这是本节的多页打印视图。 .
客户端与 API
- 1: HugeGraph RESTful API
- 1.1: Graphspace API
- 1.2: Schema API
- 1.3: PropertyKey API
- 1.4: VertexLabel API
- 1.5: EdgeLabel API
- 1.6: IndexLabel API
- 1.7: Rebuild API
- 1.8: Vertex API
- 1.9: Edge API
- 1.10: Traverser API
- 1.11: Rank API
- 1.12: Variable API
- 1.13: Graphs API
- 1.14: Task API
- 1.15: Gremlin API
- 1.16: Cypher API
- 1.17: Authentication API
- 1.18: Metrics API
- 1.19: Other API
- 2: 客户端/SDK
- 3: Gremlin-Console
HugeGraph 提供多层次的访问与接入方式,涵盖标准化 RESTful API、多语言客户端/SDK 以及命令行交互式控制台。当前 Server REST API 使用图空间(GraphSpace)和图名称组成资源路径;具体路径以各 API 页面和 Server 的 OpenAPI 页面为准。
模块指引
基于 HTTP 的 REST 接口规范,覆盖图空间管理、元数据定义、顶点与边 CRUD、任务管理、指标监控等全量服务端能力。
提供 Java、Python、Go 等语言的官方客户端 SDK,支持管理 Schema、读写顶点与边数据、执行 Gremlin 查询及调用高级图算法。
基于 Apache TinkerPop 的交互式命令行控制台,适合离线图操作、连接 Server 调试脚本与快速验证图遍历。
1 - HugeGraph RESTful API
本目录介绍当前 master 的 REST API。历史版本用法请切换到对应的多版本文档: HugeGraph 1.7 RESTful API 或 HugeGraph 1.5 RESTful API。
默认图空间名是
DEFAULT。
HugeGraph 提供了完备的 RESTful HTTP API,涵盖 Schema 管理、图数据读写、图实例与图空间运维、认证鉴权及分析计算。默认图空间名为 DEFAULT。
Server 启动后,可直接访问 http://localhost:8080/swagger-ui/index.html 在线查看 OpenAPI 交互文档与调试接口(参见 Swagger UI 使用示例)。
1.1 - Graphspace API
2.0 Graphspace
在 HugeGraph 中,多租户是通过图空间(graph space)来实现的,资源的分配和隔离可以通过图空间进行。
重要前置条件:
- 目前图空间功能只支持在 hstore 模式下使用。
- 如果非 hstore 模式,则只能使用默认的图空间
DEFAULT,且不支持创建、删除和更新图空间的操作。 - 注意在 rest-server.properties 中,设置
usePD=true,并且 hugegraph.properties 中,设置backend=hstore - 生产环境必须启用 Server 认证与授权,并将新建图空间的
auth设为true。生产管理员密码必须替换公开默认值pa(由auth.admin_pa配置)。 - 本页所有接口都只在 PD 模式下可用,单机模式下会返回
400和GraphSpace management is not supported in standalone mode错误信息。
限制图空间列表和详情接口的访问
GET /graphspaces 和 GET /graphspaces/{graphspace} 均未声明 @RolesAllowed;Server 未启用鉴权时这两个接口可匿名调用,启用鉴权后也没有方法级管理员角色限制。详情响应包含 dp_username 和 dp_password。生产环境必须将 white_ip.status 设为 enable 并通过 IP 白名单 API 启用、维护名单。网关必须按调用者身份或角色,仅允许管理员和可信运维调用方访问这两条路径;只限制来源 IP 范围仍会让同一网段的普通已认证业务账号读取 DP 凭据。Server 网络策略必须仅允许可信网关的出口地址访问 API 端口,阻断客户端绕过网关的直连路径。网关须记录这两条路径的调用身份、来源和结果;Server audit-*.log 用于鉴权授权记录,不能替代这两条路径的网关访问审计。业务账号须按最小权限授权。
2.0.1 创建一个图空间
Method & Url
Request Body
注意:目前 cpu,内存,以及 k8s 相关功能暂未开放
| 名称 | 是否必填 | 类型 | 默认值 | 取值范围 | 说明 |
|---|---|---|---|---|---|
| name | 是 | String | 小写字母、数字和下划线组成,首字符必须是小写字母,长度不超过 48 | 图空间的名字 | |
| nickname | 否 | String | name 的值 | 在所有图空间中必须唯一 | 图空间的显示名 |
| description | 否 | String | 图空间的描述信息 | ||
| cpu_limit | 是 | Int | > 0 | CPU 核数 | |
| memory_limit | 是 | Int | > 0 | 内存大小,单位 GB | |
| storage_limit | 是 | Int | > 0 | 图空间的数据占据的磁盘空间上限,单位 GB | |
| compute_cpu_limit | 否 | Int | 0 | >= 0 | 针对图计算的额外资源配置,单位 cores。当该字段不配置或者配置为 0 时,会由 cpu_limit 字段的值进行覆盖 |
| compute_memory_limit | 否 | Int | 0 | >= 0 | 针对图计算的额外内存配置,单位 GB。当该字段不配置或者配置为 0 时,会由 memory_limit 字段的值进行覆盖 |
| oltp_namespace | 否 | String | "" | OLTP 的 k8s 命名空间 | |
| olap_namespace | 否 | String | "" | OLAP 的 k8s 命名空间。当 olap_namespace 和 oltp_namespace 的值相同时,其配置的资源限额会进行合并 | |
| storage_namespace | 否 | String | "" | 存储的 k8s 命名空间 | |
| operator_image_path | 否 | String | "" | 图计算 operator 的镜像地址:在创建图空间时,允许指定对应的图计算镜像并交由 K8S 进行统一管理 | |
| internal_algorithm_image_url | 否 | String | "" | 图计算的算法镜像地址:在创建图空间时,允许指定图计算的算法镜像并交由 K8S 进行统一管理 | |
| max_graph_number | 是 | Int | > 0 | 图空间的图数目的上限 | |
| max_role_number | 否 | Int | 0 | 图空间的角色数目的上限 | |
| auth | 否 | Boolean | false | true, false | 图空间是否支持权限认证 |
| configs | 否 | Map | 其他配置信息 |
Response Status
Response Body
2.0.2 列出系统所有图空间
Method & Url
Response Status
Response Body
2.0.3 查看某个图空间
Params
路径参数说明:
- graphspace: 图空间名称
Method & Url
Response Status
Response Body
上述
dp_username和dp_password是文档示例值。实际详情响应会返回对应图空间的 DP 凭据,应按敏感凭据保护。
2.0.4 更新某个图空间
注意:auth 鉴权配置,在创建图空间的过程一旦确定下来,不允许更新
动态配额更新与资源约束:
- 动态配额更新:管理员可通过
PUT /graphspaces/{name}并携带{"action":"update","update":{...}}动态调整配额(包括max_graph_number、max_role_number、cpu_limit、memory_limit、storage_limit)。更新前建议先通过GET /graphspaces/{name}读取当前配置,并保留未修改字段的原值。 - 计算资源配额继承:当
compute_cpu_limit: 0或compute_memory_limit: 0(或创建时缺省)时,表示持续继承主图空间的cpu_limit和memory_limit。 数值 0 代表继承,既非无限制也非分配 0 资源。 - 配额超限约束:图数量达到
max_graph_number时,新建图请求将被拒绝并返回reach graph limit;存储占用超过storage_limit时,PD 会将该图空间内的图标记为ReadOnly(只读),待后续巡检检测到占用降至配额以下后自动恢复ReadWrite。 - 高精度存储指标:响应体在保留以 GB 为单位的整数
storage_used字段外,新增了storage_used_kb字段以支持 1GB 以下的高精度用量展示,storage_percent比率直接基于该 KB 精度值计算得出。
Params
路径参数说明:
- graphspace: 图空间名称
请求体说明:
- action: 标记本次操作为 Update 动作,取值固定为 “update”
- update: 即将更新的值,下述参数都应置于 update 中
| 名称 | 是否必填 | 类型 | 默认值 | 取值范围 | 说明 |
|---|---|---|---|---|---|
| name | 是 | String | 必须与路径中的图空间名一致 | 图空间名称 | |
| nickname | 否 | String | 在所有图空间中必须唯一 | 图空间的显示名 | |
| description | 否 | String | 图空间的描述信息 | ||
| cpu_limit | 是 | Int | > 0 | OLTP HugeGraphServer 的 CPU 核数 | |
| memory_limit | 是 | Int | > 0 | OLTP HugeGraphServer 的内存大小,单位 GB | |
| storage_limit | 是 | Int | > 0 | 图空间的数据占据的磁盘空间上限,单位 GB | |
| compute_cpu_limit | 否 | Int | 0 | >= 0 | 针对图计算的额外资源配置,单位 cores。当该字段不配置或者配置为 0 时,会由 cpu_limit 字段的值进行覆盖 |
| compute_memory_limit | 否 | Int | 0 | >= 0 | 针对图计算的额外内存配置,单位 GB。当该字段不配置或者配置为 0 时,会由 memory_limit 字段的值进行覆盖 |
| oltp_namespace | 否 | String | OLTP 的 k8s 命名空间 | ||
| olap_namespace | 否 | String | OLAP 的 k8s 命名空间。当 olap_namespace 和 oltp_namespace 的值相同时,其配置的资源限额会进行合并 | ||
| storage_namespace | 否 | String | 存储的 k8s 命名空间 | ||
| operator_image_path | 否 | String | 图计算 operator 的镜像地址:在更新图空间时,允许指定对应的图计算镜像并交由 K8S 进行统一管理 | ||
| internal_algorithm_image_url | 否 | String | 图计算的算法镜像地址:在更新图空间时,允许指定图计算的算法镜像并交由 K8S 进行统一管理 | ||
| max_graph_number | 是 | Int | > 0 | 图空间的图数目的上限 | |
| max_role_number | 否 | Int | 图空间的角色数目的上限 |
Method & Url
Request Body
Response Status
Response Body
2.0.5 删除某个图空间
Params
路径参数说明:
- graphspace: 图空间名称
Method & Url
Response Status
注意:删除图空间,会导致图空间的全部资源被释放。
2.0.6 列出系统所有图空间及其详情
Params
请求参数说明:
- prefix: 只返回名称或显示名以该前缀开头的图空间
Method & Url
Response Status
Response Body
每条记录包含与 GET /graphspaces/{graphspace} 相同的字段,并额外带上 authed、default、create_time 和 update_time。authed 表示当前用户是否可以进入该图空间:当图空间开启了鉴权,而当前用户既不是管理员、也不是该空间的管理员或成员时为 false。default 目前恒为 false,默认图空间功能尚未实现。
默认角色
每个图空间内置四种默认角色,可以一次性把一整组权限赋给某个用户或角色:
space:图空间管理员,只有管理员可以授予space_member:图空间成员analyst:图空间分析师observer:只读角色,传入graph时可以收窄到单个图
user 既可以是用户名,也可以是角色名。当前用户是否具备某个默认角色也可以通过 GET /graphspaces/{graphspace}/auth/managers/default 查询,参见 Authentication API。
2.0.7 授予默认角色
Params
路径参数说明:
- graphspace: 图空间名称
请求体说明:
- user: 用户名或角色名,必填
- role: 取值为
space、space_member、analyst、observer之一,必填 - graph: 图名称,选填,只在
role=observer时生效
Method & Url
Request Body
Response Status
Response Body
只有在单个图上授予角色时才会回显 graph。
2.0.8 查询默认角色
Params
路径参数说明:
- graphspace: 图空间名称
请求参数说明:
- user: 用户名或角色名,必填
- role: 默认角色名称,必填
- graph: 图名称,选填,只在
role=observer时生效
Method & Url
Response Status
Response Body
2.0.9 回收默认角色
Params
路径参数说明:
- graphspace: 图空间名称
请求参数说明:
- user: 用户名或角色名,必填
- role: 默认角色名称,必填
- graph: 图名称,选填,只在
role=observer时生效
Method & Url
Response Status
Schema 模板
Schema 模板把一段 Gremlin schema 脚本以名称保存下来,创建图时通过 schema 字段引用它来初始化图,参见 Graphs API。模板可以由它的创建者、图空间管理员或系统管理员修改和删除。
2.0.10 创建 schema 模板
Params
路径参数说明:
- graphspace: 图空间名称
请求体说明:
- name: 模板名称,必填
- schema: Gremlin schema 脚本,必填
Method & Url
Request Body
Response Status
Response Body
2.0.11 列出图空间的全部 schema 模板
Method & Url
Response Status
Response Body
2.0.12 查看某个 schema 模板
Method & Url
Response Status
2.0.13 修改某个 schema 模板
只能修改 schema,模板名称不可修改。
Method & Url
Request Body
Response Status
2.0.14 删除某个 schema 模板
Method & Url
Response Status
1.2 - Schema API
1.1 Schema
HugeGraph 提供单一接口获取某个图的全部 Schema 信息,包括:PropertyKey、VertexLabel、EdgeLabel 和 IndexLabel。
Method & Url
Response Status
Response Body
1.3 - PropertyKey API
1.2 PropertyKey
Params 说明:
- name:属性类型名称,必填
- data_type:属性类型数据类型,包括:bool、byte、int、long、float、double、text、date、uuid、blob,默认
text类型 (代表 string 字符串类型) - cardinality:属性类型基数,包括:single、list、set,默认
single(代表单属性值)
请求体字段说明:
- id:属性类型 id 值
- properties:属性的属性,对于属性而言,此项为空
- user_data:设置属性类型的通用信息,比如可设置 age 属性的取值范围,最小为 0,最大为 100;目前此项不做任何校验,只为后期拓展提供预留入口
1.2.1 创建一个 PropertyKey
Method & Url
Request Body
Response Status
Response Body
1.2.2 为已存在的 PropertyKey 添加或移除 userdata
Params
- action: 表示当前行为是添加还是移除,取值为
append(添加)和eliminate(移除)
Method & Url
Request Body
Response Status
Response Body
1.2.3 获取所有的 PropertyKey
Method & Url
Response Status
Response Body
1.2.4 根据 name 获取 PropertyKey
Method & Url
其中,age为要获取的 PropertyKey 的名称
Response Status
Response Body
1.2.5 根据 name 删除 PropertyKey
Method & Url
其中,age为要删除的 PropertyKey 的名称
Response Status
Response Body
1.4 - VertexLabel API
1.3 VertexLabel
假设已经创建好了 1.1.3 中列出来的 PropertyKeys
Params 说明
- id:顶点类型 id 值
- name:顶点类型名称,必填
- id_strategy: 顶点类型的 ID 策略,主键 ID、自动生成、自定义字符串、自定义数字、自定义 UUID,默认主键 ID
- properties: 顶点类型关联的属性类型
- primary_keys: 主键属性,当 ID 策略为 PRIMARY_KEY 时必须有值,其他 ID 策略时必须为空;
- enable_label_index:是否开启类型索引,默认关闭
- index_names:顶点类型创建的索引,详情见 3.4
- nullable_keys:可为空的属性
- user_data:设置顶点类型的通用信息,作用同属性类型
1.3.1 创建一个 VertexLabel
Method & Url
Request Body
Response Status
Response Body
从 hugegraph-server v0.11.2 版本开始支持顶点的 TTL 功能。顶点的 TTL 是通过 VertexLabel 来设置的。比如希望 person 类型的顶点存活时间为一天,需要在创建 person VertexLabel 的时候将 TTL 字段设置为 86400000,即单位为毫秒。
另外,当顶点中带有"创建时间"的属性且希望以"创建时间"属性作为计算顶点存活时间的起点时,可以设置 VertexLabel 中的 ttl_start_time 字段。比如 person VertexLabel 有 createdTime 属性,且 createdTime 是 Date 类型的参数,希望 person 类型的顶点从创建开始存活一天的时间,那么创建 person VertexLabel 的 Request Body 如下:
1.3.2 为已存在的 VertexLabel 添加 properties 或 userdata,或者移除 userdata(目前不支持移除 properties)
Params
- action: 表示当前行为是添加还是移除,取值为
append(添加)和eliminate(移除)
Method & Url
Request Body
Response Status
Response Body
1.3.3 获取所有的 VertexLabel
Method & Url
Response Status
Response Body
1.3.4 根据 name 获取 VertexLabel
Method & Url
Response Status
Response Body
1.3.5 根据 name 删除 VertexLabel
删除 VertexLabel 会导致删除对应的顶点以及相关的索引数据,会产生一个异步任务
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/1(其中"1"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.5 - EdgeLabel API
1.4 EdgeLabel
假设已经创建好了 1.2.3 中的 PropertyKeys 和 1.3.3 中的 VertexLabels
Params 说明
- name:顶点类型名称,必填
- source_label: 源顶点类型的名称,必填
- target_label: 目标顶点类型的名称,必填
- frequency:两个点之间是否可以有多条边,可以取值 SINGLE 和 MULTIPLE,非必填,默认值 SINGLE
- properties: 边类型关联的属性类型,选填
- sort_keys: 当允许关联多次时,指定区分键属性列表
- nullable_keys:可为空的属性,选填,默认可为空
- enable_label_index:是否开启类型索引,默认关闭
1.4.1 创建一个 EdgeLabel
Method & Url
Request Body
Response Status
Response Body
从 hugegraph-server v0.11.2 版本开始支持边的 TTL 功能。边的 TTL 是通过 EdgeLabel 来设置的。比如希望 knows 类型的边存活时间为一天,需要在创建 knows EdgeLabel 的时候将 TTL 字段设置为 86400000,即单位为毫秒。
另外,当边中带有"创建时间"的属性且希望以"创建时间"属性作为计算边存活时间的起点时,可以设置 EdgeLabel 中的 ttl_start_time 字段。比如 knows EdgeLabel 有 createdTime 属性,且 createdTime 是 Date 类型的参数,希望 knows 类型的边从创建开始存活一天的时间,那么创建 knows EdgeLabel 的 Request Body 如下:
1.4.2 为已存在的 EdgeLabel 添加 properties 或 userdata,或者移除 userdata(目前不支持移除 properties)
Params
- action: 表示当前行为是添加还是移除,取值为
append(添加)和eliminate(移除)
Method & Url
Request Body
Response Status
Response Body
1.4.3 获取所有的 EdgeLabel
Method & Url
Response Status
Response Body
1.4.4 根据 name 获取 EdgeLabel
Method & Url
Response Status
Response Body
1.4.5 根据 name 删除 EdgeLabel
删除 EdgeLabel 会导致删除对应的边以及相关的索引数据,会产生一个异步任务
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/1(其中"1"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.6 - IndexLabel API
1.5 IndexLabel
假设已经创建好了 1.1.3 中的 PropertyKeys、1.2.3 中的 VertexLabels 以及 1.3.3 中的 EdgeLabels
1.5.1 创建一个 IndexLabel
Method & Url
Request Body
Response Status
Response Body
1.5.2 获取所有的 IndexLabel
Method & Url
Response Status
Response Body
1.5.3 根据 name 获取 IndexLabel
Method & Url
Response Status
Response Body
1.5.4 根据 name 删除 IndexLabel
删除 IndexLabel 会导致删除相关的索引数据,响应为任务 ID,会产生一个异步任务。当前 Server 接口没有 delete_all 查询参数。
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/1(其中"1"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.5.5 为已存在的 IndexLabel 添加或移除 userdata
该方式只能修改 user_data,请求体中不能带 base_type、base_value 和 index_type。
Params
- action: 表示当前行为是添加还是移除,取值为
append(添加)和eliminate(移除)
Method & Url
Request Body
Response Status
Response Body
1.7 - Rebuild API
1.6 Rebuild
重建顶点、边或索引标签使用 PUT .../jobs/rebuild/{type}/{name}:目标标签不存在时返回 HTTP 404;
已有标签返回 HTTP 202 与任务 ID,应轮询任务结果后再确认重建完成。
1.6.1 重建 IndexLabel
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/1(其中"1"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.6.2 VertexLabel 对应的全部索引重建
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/2(其中"2"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.6.3 EdgeLabel 对应的全部索引重建
Method & Url
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/3(其中"3"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.8 - Vertex API
2.1 Vertex
顶点类型中的 Id 策略决定了顶点的 Id 类型,其对应的 id 类型如下:
| Id_Strategy | id type |
|---|---|
| AUTOMATIC | number |
| PRIMARY_KEY | string |
| CUSTOMIZE_STRING | string |
| CUSTOMIZE_NUMBER | number |
| CUSTOMIZE_UUID | uuid |
顶点的 GET/PUT/DELETE API 中 url 的 id 部分应该传入带有类型信息的 id 值,这个类型信息通过 json 串是否带引号来表示,也就是说:
- 当 id 类型为
number时,url 中的 id 不带引号,例如xxx/vertices/123456 - 当 id 类型为
string时,url 中的 id 带引号,例如xxx/vertices/"123456";在命令行或客户端转义保留字符时编码为%221%3Amarko%22
追加属性使用 PUT .../vertices/{id}?action=append 并提交对应 JSON 属性体。
接下来的示例需要先根据以下 groovy 脚本创建图 schema
2.1.1 创建一个顶点
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Method & Url
Request Body
Response Status
Response Body
2.1.2 创建多个顶点
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Method & Url
Request Body
Response Status
Response Body
2.1.3 更新顶点属性
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- id: 顶点 id,需要包含引号,例如"1:marko"
Method & Url
Request Body
注意:属性的取值有三种类别,分别为 single、set 和 list。single 表示增加或更新属性值,set 或 list 表示追加属性值。
Response Status
Response Body
2.1.4 批量更新顶点属性
功能说明
批量更新顶点的属性时,可以选择多种更新策略,如下:
- SUM: 数值累加
- BIGGER: 原值和新值 (数字、日期) 取更大的
- SMALLER: 原值和新值 (数字、日期) 取更小的
- UNION: Set 属性取并集
- INTERSECTION: Set 属性取交集
- APPEND: List 属性追加元素
- ELIMINATE: List/Set属性删除元素
- OVERRIDE: 覆盖已有属性,如果新属性为 null,则仍然使用旧属性
假设原顶点的属性如下:
通过以下命令新增顶点:
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Method & Url
Request Body
Response Status
Response Body
结果分析如下:
- lang 属性未指定更新策略,直接用新值覆盖旧值,无论新值是否为 null;
- price 属性指定 BIGGER 的更新策略,旧属性值为 328,新属性值为 299,所以仍然保留了旧属性值 328;
- age 属性指定 OVERRIDE 更新策略,而新属性值中未传入 age,相当于 age 为 null,所以仍然保留了原属性值 32;
- city 属性也指定了 OVERRIDE 更新策略,且新属性值不为 null,所以覆盖了旧值;
- weight 属性指定了 SUM 更新策略,旧属性值为 0.1,新属性值为 0.2,最后的值为 0.3;
- hobby 属性(基数为 Set)指定了 UNION 更新策略,所以新值与旧值取了并集;
其他更新策略的使用方式与此类似,此处不再详述。
2.1.5 删除顶点属性
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- id: 顶点 id,需要包含引号,例如"1:marko"
Method & Url
Request Body
注意:这里会直接删除属性(删除 key 和所有 value),无论其属性的取值是 single、set 或 list。
Response Status
Response Body
2.1.6 获取符合条件的顶点
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
- label: 顶点的类型
- properties: 属性键值对(索引覆盖要求见下文)
- keep_start_p: 默认为 false,设置为 true 时不会自动转义范围匹配表达式,例如
properties={"age":"P.gt(18)"}会被当作精确匹配,即 age 属性等于字符串 “P.gt(18)” - offset: 偏移量,默认为 0
- limit: 查询结果的最大数目,默认为 100
- page: 分页的页号
以上参数都是可选的,page 不能与非 0 的 offset 同时使用,其余参数之间可以任意组合。
指定 label 且该标签使用 PRIMARY_KEY ID 策略时,如果 properties 为所有主键字段提供精确值(P.eq 与 P.within 均视作精确值),查询直接按 ID 检索顶点,取回后再验证其余属性条件,无需属性索引。
若主键字段齐全但其中任一字段使用了 P.eq、P.within、P.contains 以外的谓词(如 P.neq、P.gt、P.between、P.textcontains 等),查询在进入属性索引阶段前即被拒绝,即使存在匹配索引也不例外。P.contains 用于主键字段时走单元素 ID 查找,不会被拦截。
对于其他 properties 查询:指定 label 时,该标签需要有与查询条件匹配的属性索引。候选标签是指声明了全部待查非 OLAP 属性的顶点标签(包括暂无数据的标签)。
普通查询不可见的标签(包括正在删除的标签)不计入候选集,不需要索引覆盖。若所有候选标签均不可见或正在删除(或指定的 label 本身不可见或正在删除),查询直接返回空结果,不报索引错误。若没有任何 Schema 标签声明待查属性,仍会报索引错误。注意:仅建立标签索引不等于属性已建立索引。
若查询包含 OLAP 属性且读取模式已开放 OLAP 数据,HugeGraph 使用全局共享的 OLAP 索引,这类属性无需每个候选标签单独建立索引。
错误触发规则:查询值与属性类型兼容,但缺少匹配索引或只覆盖了部分候选标签,均会报索引错误;仅当所有候选标签均被完整覆盖时,查询才通过索引执行。查询值与属性类型不兼容时,若已找到匹配索引则可能返回空结果(跳过部分覆盖检查);若无任何匹配索引仍报索引错误。查询不会自动回退到全量扫描。
部分覆盖检查与候选标签不可见时返回空结果的机制自 1.8.0 起生效。早期版本仅返回命中索引标签的匹配结果,且在无标签具备匹配索引时直接报索引错误。
属性键值对由属性名称和属性值组成 JSON 格式的对象,可以使用多个属性键值对作为查询条件,属性值支持精确匹配和范围匹配,精确匹配的形式如properties={"age":29},范围匹配的形式如properties={"age":"P.gt(29)"},范围匹配支持以下表达式:
| 表达式 | 说明 |
|---|---|
| P.eq(number) | 属性值等于 number 的顶点 |
| P.neq(number) | 属性值不等于 number 的顶点 |
| P.lt(number) | 属性值小于 number 的顶点 |
| P.lte(number) | 属性值小于等于 number 的顶点 |
| P.gt(number) | 属性值大于 number 的顶点 |
| P.gte(number) | 属性值大于等于 number 的顶点 |
| P.between(number1,number2) | 属性值大于等于 number1 且小于 number2 的顶点 |
| P.inside(number1,number2) | 属性值大于 number1 且小于 number2 的顶点 |
| P.outside(number1,number2) | 属性值小于 number1 且大于 number2 的顶点 |
| P.within(value1,value2,value3,…) | 属性值等于任何一个给定 value 的顶点 |
查询所有 age 为 29 且 label 为 person 的顶点
Method & Url
Response Status
Response Body
分页查询所有顶点,获取第一页(page 不带参数值),限定 3 条
通过以下命令新增顶点:
Method & Url
Response Status
Response Body
返回的 body 里面是带有下一页的页号信息的,"page": "CIYxOnBldGVyAAAAAAAAAAM=",在查询下一页的时候将该值赋给 page 参数。
分页查询所有顶点,获取下一页(page 带上上一页返回的 page 值),限定 3 条
Method & Url
Response Status
Response Body
当"page": null时,表示已经没有下一页了(注:如果后端使用的是 Cassandra,为了提高性能,当返回的页数刚好是最后一页时,返回的 page 值可能不为空,但是如果用这个 page 值再请求下一页数据时,就会返回 空数据 和 page = null,其他情况也类似)
2.1.7 根据 Id 获取顶点
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- id: 顶点 id,需要包含引号,例如"1:marko"
Method & Url
Response Status
Response Body
2.1.8 根据 Id 删除顶点
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- id: 顶点 id,需要包含引号,例如"1:marko"
请求参数说明:
- label: 顶点类型,可选参数
仅根据 Id 删除顶点
Method & Url
Response Status
根据 Label+Id 删除顶点
通过指定 Label 参数和 Id 来删除顶点时,一般来说其性能比仅根据 Id 删除会更好。
Method & Url
Response Status
1.9 - Edge API
2.2 Edge
顶点 id 格式的修改也影响到了边的 id 以及源顶点和目标顶点 id 的格式
EdgeId 是由 src-vertex-id + direction + label + sort-values + tgt-vertex-id 拼接而成,但是这里的顶点 id 类型不是通过引号区分的,而是根据前缀区分:
- 当 id 类型为 number 时,EdgeId 的顶点 id 前有一个前缀
L,形如 “L123456>1»L987654” - 当 id 类型为 string 时,EdgeId 的顶点 id 前有一个前缀
S,形如 “S1:peter>1»S2:lop”
边 ID 使用 Server 的原始边 ID 格式,转义 URL 保留字符时不要额外加 JSON 引号。不能把顶点 ID 编码规则直接套到边 ID 上。
追加属性使用 PUT .../edges/{id}?action=append 并提交对应 JSON 属性体。
删除边时按后端要求提供 DELETE .../edges/{id}?label={label} 的标签参数。
接下来的示例需要先根据以下 groovy 脚本创建图 schema
2.2.1 创建一条边
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
请求体说明:
- label:边类型名称,必填
- outV:源顶点 id,必填
- inV:目标顶点 id,必填
- outVLabel:源顶点类型,必填
- inVLabel:目标顶点类型,必填
- properties: 边关联的属性,对象内部结构为:
- name:属性名称
- value:属性值
Method & Url
Request Body
Response Status
Response Body
2.2.2 创建多条边
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
请求参数说明:
- check_vertex:是否检查顶点存在 (true | false),当设置为 true 而待插入边的源顶点或目标顶点不存在时会报错,默认为 true
请求体说明:
- 边信息的列表
Method & Url
Request Body
Response Status
Response Body
2.2.3 更新边属性
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
- id:待操作的边 id
请求参数说明:
- action:append 操作
请求体说明:
- 边信息
Method & Url
Request Body
注意:属性的取值是有三种类别的,分别是 single、set 和 list。如果是 single,表示增加或更新属性值;如果是 set 或 list,则表示追加属性值
Response Status
Response Body
2.2.4 批量更新边属性
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
请求体说明:
- edges:边信息的列表
- update_strategies:对于每个属性,可以单独设置其更新策略,包括:
- SUM:仅支持 number 类型
- BIGGER/SMALLER:仅支持 date/number 类型
- UNION/INTERSECTION:仅支持 set 类型
- APPEND/ELIMINATE:仅支持 collection 类型
- OVERRIDE
- check_vertex:是否检查顶点存在 (true | false),当设置为 true 而待插入边的源顶点或目标顶点不存在时会报错,默认为 true
- create_if_not_exist:目前只支持设定为 true
Method & Url
Request Body
Response Status
Response Body
2.2.5 删除边属性
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
- id:待操作的边 id
请求参数说明:
- action:eliminate 操作
请求体说明:
- 边信息
Method & Url
Request Body
注意:这里会直接删除属性(删除 key 和所有 value),无论其属性的取值是 single、set 或 list
Response Status
Response Body
无法删除未设置为 nullable 的属性
2.2.6 获取符合条件的边
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
请求参数说明:
- vertex_id: 顶点 id
- direction: 边的方向 (OUT | IN | BOTH),默认为 BOTH
- label: 边的标签
- properties: 属性键值对(索引覆盖要求见下文)
- keep_start_p: 默认为 false,当设置为 true 后,不会自动转义范围匹配输入的表达式,例如此时
properties={"age":"P.gt(0.8)"}会被理解为精确匹配,即 age 属性等于 “P.gt(0.8)” - offset:偏移,默认为 0
- limit: 查询数目,默认为 100
- page: 页号
未指定 vertex_id 时,properties 在全图范围内查询边。指定 label 时,该标签需有与查询条件匹配的属性索引;若指定的是未单独建索引的子边标签,可以使用其父标签(查询可见的)上的匹配索引,同级其他子标签的边会被自动过滤。
候选标签是可直接存边且声明了全部待查非 OLAP 属性的边标签(包括当前没有边的标签)。普通查询不可见的标签(包括正在删除的标签)不计入候选集,不需要索引覆盖。若所有候选标签均不可见或正在删除(或指定的 label 本身不可见或正在删除),查询返回空结果,不报索引错误。若没有任何 Schema 标签声明待查属性,仍会报索引错误。
未指定 label 时:base 父边标签不直接存边,子标签全部被覆盖时无需再为父标签单独建立索引。可以使用当前查询可见的父标签上的匹配索引覆盖子标签,也可以为每个候选子标签单独建立索引。父标签因隐藏或正在删除而被排除时,其索引不能用于覆盖子标签。仅有标签索引不等于属性已建立索引。
错误触发规则:查询值与属性类型兼容,但缺少匹配索引或只覆盖了部分候选标签,均会报索引错误;仅当所有候选标签均被完整覆盖时,查询才通过索引执行。查询值与属性类型不兼容时,若已找到匹配索引则可能返回空结果(跳过部分覆盖检查);若无任何匹配索引仍报索引错误。查询不会自动回退到全量扫描。
部分覆盖检查、子边标签复用父标签索引,以及候选标签不可见时返回空结果的机制,自 1.8.0 起生效。早期版本仅使用指定标签自身建立的索引,未指定 label 时仅返回命中索引标签的匹配结果,且在无标签具备匹配索引时直接报索引错误。
指定 vertex_id 时,查询过滤该顶点的邻接边,不适用上述全图查询的索引覆盖要求。
属性键值对由 JSON 格式的属性名称和属性值组成,允许多个属性键值对作为查询条件,属性值支持精确匹配和范围匹配,精确匹配时形如 properties={"weight":0.8},范围匹配时形如 properties={"age":"P.gt(0.8)"},范围匹配支持的表达式如下:
| 表达式 | 说明 |
|---|---|
| P.eq(number) | 属性值等于 number 的边 |
| P.neq(number) | 属性值不等于 number 的边 |
| P.lt(number) | 属性值小于 number 的边 |
| P.lte(number) | 属性值小于等于 number 的边 |
| P.gt(number) | 属性值大于 number 的边 |
| P.gte(number) | 属性值大于等于 number 的边 |
| P.between(number1,number2) | 属性值大于等于 number1 且小于 number2 的边 |
| P.inside(number1,number2) | 属性值大于 number1 且小于 number2 的边 |
| P.outside(number1,number2) | 属性值小于 number1 且大于 number2 的边 |
| P.within(value1,value2,value3,…) | 属性值等于任何一个给定 value 的边 |
| P.textcontains(value) | 属性值包含给定 value 的边 (string 类型) |
| P.contains(value) | 属性值包含给定 value 的边 (collection 类型) |
查询与顶点 person:marko(vertex_id=“1:marko”) 相连且 label 为 knows 的且 date 属性等于 “20160111” 的边
Method & Url
Response Status
Response Body
分页查询所有边,获取第一页(page 不带参数值),限定 2 条
Method & Url
Response Status
Response Body
返回的 body 里面是带有下一页的页号信息的,"page": "EoYxOm1hcmtvgggCAIQyOmxvcAAAAAAAAAAC",在查询下一页的时候将该值赋给 page 参数
分页查询所有边,获取下一页(page 带上上一页返回的 page 值),限定 2 条
Method & Url
Response Status
Response Body
此时 "page": null 表示已经没有下一页了
注:后端为 Cassandra 时,为了性能考虑,返回页恰好为最后一页时,返回
page值可能非空,通过该page再请求下一页数据时则返回空数据及page = null,其他情况类似
2.2.7 根据 id 获取边
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
- id:待操作的边 id
Method & Url
Response Status
Response Body
2.2.8 根据 id 删除边
Params
路径参数说明:
- graphspace: 图空间名称
- graph:待操作的图
- id:待操作的边 id
请求参数说明:
- label: 边的标签
仅根据 id 删除边
Method & Url
Response Status
根据 label + id 删除边
通过指定 label 参数和 id 来删除边时,一般来说其性能比仅根据 id 删除会更好
Method & Url
Response Status
1.10 - Traverser API
3.1 traverser API 概述
HugeGraphServer 为 HugeGraph 图数据库提供了 RESTful API 接口。除了顶点和边的 CRUD 基本操作以外,还提供了一些遍历(traverser)方法,我们称为traverser API。这些遍历方法实现了一些复杂的图算法,方便用户对图进行分析和挖掘。
HugeGraph 支持的 Traverser API 包括:
- K-out API,根据起始顶点,查找恰好 N 步可达的邻居,分为基础版和高级版:
- 基础版使用 GET 方法,根据起始顶点,查找恰好 N 步可达的邻居
- 高级版使用 POST 方法,根据起始顶点,查找恰好 N 步可达的邻居,与基础版的不同在于:
- 支持只统计邻居数量
- 支持顶点和边属性过滤
- 支持返回到达邻居的最短路径
- K-neighbor API,根据起始顶点,查找 N 步以内可达的所有邻居,分为基础版和高级版:
- 基础版使用 GET 方法,根据起始顶点,查找 N 步以内可达的所有邻居
- 高级版使用 POST 方法,根据起始顶点,查找 N 步以内可达的所有邻居,与基础版的不同在于:
- 支持只统计邻居数量
- 支持顶点和边属性过滤
- 支持返回到达邻居的最短路径
- Same Neighbors,查询顶点的共同邻居。GET 接口用于查询两个顶点的共同邻居;POST 批量接口用于在单次请求中独立计算多组顶点对的共同邻居。
- Jaccard Similarity API,计算 jaccard 相似度,包括两种:
- 一种是使用 GET 方法,计算两个顶点的邻居的相似度(交并比)
- 一种是使用 POST 方法,在全图中查找与起点的 jaccard similarity 最高的 N 个点
- Shortest Path API,查找两个顶点之间的最短路径
- All Shortest Paths,查找两个顶点间的全部最短路径
- Weighted Shortest Path,查找起点到目标点的带权最短路径
- Single Source Shortest Path,查找一个点到其他各个点的加权最短路径
- Multi Node Shortest Path,查找指定顶点集之间两两最短路径
- Paths API,查找两个顶点间的全部路径,分为基础版和高级版:
- 基础版使用 GET 方法,根据起点和终点,查找两个顶点间的全部路径
- 高级版使用 POST 方法,根据一组起点和一组终点,查找两个集合间符合条件的全部路径
- Customized Paths API,从一批顶点出发,按(一种)模式遍历经过的全部路径
- Template Path API,指定起点和终点以及起点和终点间路径信息,查找符合的路径
- Crosspoints API,查找两个顶点的交点(共同祖先或者共同子孙)
- Customized Crosspoints API,从一批顶点出发,按多种模式遍历,最后一步到达的顶点的交点
- Rings API,从起始顶点出发,可到达的环路路径
- Rays API,从起始顶点出发,可到达边界的路径(即无环路径)
- Fusiform Similarity API,查找一个顶点的梭形相似点
- Adamic-Adar API,计算两个顶点的 Adamic-Adar 指标
- Resource Allocation API,计算两个顶点的资源分配指标
- Edge Existence API,查询两个顶点之间存在的边
- Count API,统计经过若干步遍历后可达的顶点数量,不返回顶点本身
- Vertices API
- 按 ID 批量查询顶点;
- 获取顶点的分区;
- 按分区查询顶点;
- Edges API
- 按 ID 批量查询边;
- 获取边的分区;
- 按分区查询边;
3.2. traverser API 详解
使用方法中的例子,都是基于 TinkerPop 官网给出的图:
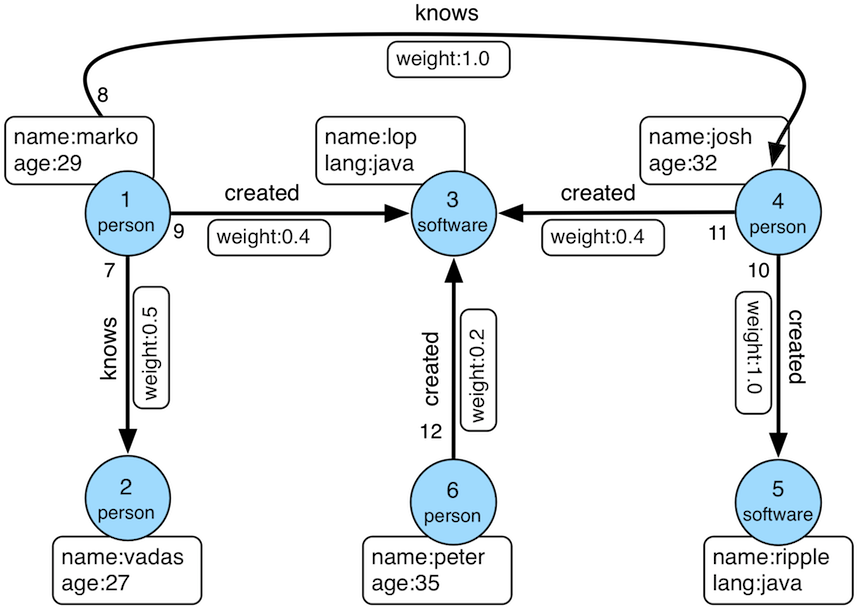
数据导入程序如下:
顶点 ID 为:
边 ID 为:
3.2.1 K-out API(GET,基础版)
3.2.1.1 功能介绍
根据起始顶点、方向、边的类型(可选)和深度 depth,查找从起始顶点出发恰好 depth 步可达的顶点
Params
- source:起始顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- max_depth:步数,必填项
- label:边的类型,选填项,默认代表所有 edge label
- nearest:nearest 为 true 时,代表起始顶点到达结果顶点的最短路径长度为 depth,不存在更短的路径;nearest 为 false 时,代表起始顶点到结果顶点有一条长度为 depth 的路径(未必最短且可以有环),选填项,默认为 true
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的顶点的最大数目,选填项,默认为 10000000
3.2.1.2 使用方法
Method & Url
Response Status
Response Body
3.2.1.3 适用场景
查找恰好 N 步关系可达的顶点。两个例子:
- 家族关系中,查找一个人的所有孙子,person A 通过连续的两条“儿子”边到达的顶点集合。
- 社交关系中发现潜在好友,例如:与目标用户相隔两层朋友关系的用户,可以通过连续两条“朋友”边到达的顶点。
3.2.2 K-out API(POST,高级版)
3.2.2.1 功能介绍
根据起始顶点、步骤(包括方向、边类型和过滤属性)和深度 depth,查找从起始顶点出发恰好 depth 步可达的顶点。
与 K-out 基础版的不同在于:
- 支持只统计邻居数量
- 支持边属性过滤
- 支持返回到达邻居的最短路径
Params
- source:起始顶点 id,必填项
- steps: 从起始点出发的 Steps,必填项,结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- edge_steps:边 Step 集合,支持对单边的类型和属性过滤,如果为空,则不过滤
- label:边类型
- properties:边属性
- vertex_steps:顶点 Step 集合,支持对单点的类型和属性过滤,如果为空,则不过滤
- label:顶点类型
- properties:顶点属性
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- max_depth:步数,必填项
- nearest:nearest 为 true 时,代表起始顶点到达结果顶点的最短路径长度为 depth,不存在更短的路径;nearest 为 false 时,代表起始顶点到结果顶点有一条长度为 depth 的路径(未必最短且可以有环),选填项,默认为 true
- count_only:Boolean 值,true 表示只统计结果的数目,不返回具体结果;false 表示返回具体的结果,默认为 false
- with_path:true 表示返回起始点到每个邻居的最短路径,false 表示不返回起始点到每个邻居的最短路径,选填项,默认为 false
- with_edge,选填项,默认为 false:
- 如果设置为 true,则结果将包含所有边的完整信息,即路径中的所有边
- 当 with_path 为 true 时,将返回所有路径中的边的完整信息
- 当 with_path 为 false 时,不返回任何信息
- 如果设置为 false,则仅返回边的 id
- 如果设置为 true,则结果将包含所有边的完整信息,即路径中的所有边
- with_vertex,选填项,默认为 false:
- 如果设置为 true,则结果将包含所有顶点的完整信息,即路径中的所有顶点
- 当 with_path 为 true 时,将返回所有路径中的顶点的完整信息
- 当 with_path 为 false 时,返回所有邻居顶点的完整信息
- 如果设置为 false,则仅返回顶点的 id
- 如果设置为 true,则结果将包含所有顶点的完整信息,即路径中的所有顶点
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的顶点的最大数目,选填项,默认为 10000000
- traverse_mode: 遍历方式,可选择“breadth_first_search”或“depth_first_search”作为参数,默认为“breadth_first_search”
3.2.2.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.2.3 适用场景
参见 3.2.1.3
3.2.3 K-neighbor(GET,基础版)
3.2.3.1 功能介绍
根据起始顶点、方向、边的类型(可选)和深度 depth,查找包括起始顶点在内、depth 步之内可达的所有顶点
相当于:起始顶点、K-out(1)、K-out(2)、… 、K-out(max_depth) 的并集
Params
- source: 起始顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- max_depth:步数,必填项
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- limit:返回的顶点的最大数目,也即遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
3.2.3.2 使用方法
Method & Url
Response Status
Response Body
3.2.3.3 适用场景
查找 N 步以内可达的所有顶点,例如:
- 家族关系中,查找一个人五服以内所有子孙,person A 通过连续的 5 条“亲子”边到达的顶点集合。
- 社交关系中发现好友圈子,例如目标用户通过 1 条、2 条、3 条“朋友”边可到达的用户可以组成目标用户的朋友圈子
3.2.4 K-neighbor API(POST,高级版)
3.2.4.1 功能介绍
根据起始顶点、步骤(包括方向、边类型和过滤属性)和深度 depth,查找从起始顶点出发 depth 步内可达的所有顶点。
与 K-neighbor 基础版的不同在于:
- 支持只统计邻居数量
- 支持边属性过滤
- 支持返回到达邻居的最短路径
Params
- source:起始顶点 id,必填项
- steps: 从起始点出发的 Steps,必填项,结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- 从起始点出发的 Steps,必填项,结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- edge_steps:边 Step 集合,支持对单边的类型和属性过滤,如果为空,则不过滤
- label:边类型
- properties:边属性
- vertex_steps:顶点 Step 集合,支持对单点的类型和属性过滤,如果为空,则不过滤
- label:顶点类型
- properties:顶点属性
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- max_depth:步数,必填项
- count_only:Boolean 值,true 表示只统计结果的数目,不返回具体结果;false 表示返回具体的结果,默认为 false
- with_path:true 表示返回起始点到每个邻居的最短路径,false 表示不返回起始点到每个邻居的最短路径,选填项,默认为 false
- with_edge,选填项,默认为 false:
- 如果设置为 true,则结果将包含所有边的完整信息,即路径中的所有边
- 当 with_path 为 true 时,将返回所有路径中的边的完整信息
- 当 with_path 为 false 时,不返回任何信息
- 如果设置为 false,则仅返回边的 id
- 如果设置为 true,则结果将包含所有边的完整信息,即路径中的所有边
- with_vertex,选填项,默认为 false:
- 如果设置为 true,则结果将包含所有顶点的完整信息,即路径中的所有顶点
- 当 with_path 为 true 时,将返回所有路径中的顶点的完整信息
- 当 with_path 为 false 时,返回所有邻居顶点的完整信息
- 如果设置为 false,则仅返回顶点的 id
- 如果设置为 true,则结果将包含所有顶点的完整信息,即路径中的所有顶点
- limit:返回的顶点的最大数目,选填项,默认为 10000000
3.2.4.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.4.3 适用场景
参见 3.2.3.3
3.2.5 Same Neighbors
3.2.5.1 功能介绍
查询两个点的共同邻居
Params
- vertex:一个顶点 id,必填项
- other:另一个顶点 id,必填项
- direction:顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- limit:返回的共同邻居的最大数目,选填项,默认为 10000000
3.2.5.2 使用方法
Method & Url
Response Status
Response Body
3.2.5.3 适用场景
查找两个顶点的共同邻居:
- 社交关系中发现两个用户的共同粉丝或者共同关注用户
3.2.6 Jaccard Similarity (GET)
3.2.6.1 功能介绍
计算两个顶点的 jaccard similarity(两个顶点邻居的交集比上两个顶点邻居的并集)
对于并集非空的邻居集合 N(u) 和 N(v),上述定义可写为:
Params
- vertex:一个顶点 id,必填项
- other:另一个顶点 id,必填项
- direction:顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
3.2.6.2 使用方法
Method & Url
Response Status
Response Body
3.2.6.3 适用场景
用于评估两个点的相似性或者紧密度
3.2.7 Jaccard Similarity (POST)
3.2.7.1 功能介绍
计算与指定顶点的 jaccard similarity 最大的 N 个点
jaccard similarity 的计算方式为:两个顶点邻居的交集比上两个顶点邻居的并集
Params
- vertex:一个顶点 id,必填项
- 从起始点出发的 Step,必填项,结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- top:返回一个起点的 jaccard similarity 中最大的 top 个,选填项,默认为 100
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
3.2.7.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.7.3 适用场景
用于在图中找出与指定顶点相似性最高的顶点
3.2.8 Shortest Path
3.2.8.1 功能介绍
根据起始顶点、目的顶点、方向、边的类型(可选)和最大深度,查找一条最短路径
Params
- source:起始顶点 id,必填项
- target:目的顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- max_depth:最大步数,必填项
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启) - capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
3.2.8.2 使用方法
Method & Url
Response Status
Response Body
3.2.8.3 适用场景
查找两个顶点间的最短路径,例如:
- 社交关系网中,查找两个用户有关系的最短路径,即最近的朋友关系链
- 设备关联网络中,查找两个设备最短的关联关系
3.2.9 All Shortest Paths
3.2.9.1 功能介绍
根据起始顶点、目的顶点、方向、边的类型(可选)和最大深度,查找两点间所有的最短路径
Params
- source:起始顶点 id,必填项
- target:目的顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- max_depth:最大步数,必填项
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启) - capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
3.2.9.2 使用方法
Method & Url
Response Status
Response Body
3.2.9.3 适用场景
查找两个顶点间的所有最短路径,例如:
- 社交关系网中,查找两个用户有关系的全部最短路径,即最近的朋友关系链
- 设备关联网络中,查找两个设备全部的最短关联关系
3.2.10 Weighted Shortest Path
3.2.10.1 功能介绍
根据起始顶点、目的顶点、方向、边的类型(可选)和最大深度,查找一条带权最短路径
Params
- source:起始顶点 id,必填项
- target:目的顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- weight:边的权重属性,必填项,必须是数字类型的属性
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启) - capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.10.2 使用方法
Method & Url
Response Status
Response Body
3.2.10.3 适用场景
查找两个顶点间的带权最短路径,例如:
- 交通线路中查找从 A 城市到 B 城市花钱最少的交通方式
3.2.11 Single Source Shortest Path
3.2.11.1 功能介绍
从一个顶点出发,查找该点到图中其他顶点的最短路径(可选是否带权重)
Params
- source:起始顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- weight:边的权重属性,选填项,必须是数字类型的属性,如果不填或者虽然填了但是边没有该属性,则权重为 1.0
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启) - capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:查询到的目标顶点个数,也是返回的最短路径的条数,选填项,默认为 10
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.11.2 使用方法
Method & Url
Response Status
Response Body
3.2.11.3 适用场景
查找从一个点出发到其他顶点的带权最短路径,比如:
- 查找从北京出发到全国其他所有城市的耗时最短的乘车方案
3.2.12 Multi Node Shortest Path
3.2.12.1 功能介绍
查找指定顶点集两两之间的最短路径
Params
- vertices:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- step:表示从起始顶点到终止顶点走过的路径,必填项,Step 的结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- max_depth:步数,必填项
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.12.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.12.3 适用场景
查找多个点之间的最短路径,比如:
- 查找多个公司和法人之间的最短路径
3.2.13 Paths(GET,基础版)
3.2.13.1 功能介绍
根据起始顶点、目的顶点、方向、边的类型(可选)和最大深度等条件查找所有路径
Params
- source:起始顶点 id,必填项
- target:目的顶点 id,必填项
- direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_depth:步数,必填项
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的路径的最大数目,选填项,默认为 10
3.2.13.2 使用方法
Method & Url
Response Status
Response Body
3.2.13.3 适用场景
查找两个顶点间的所有路径,例如:
- 社交网络中,查找两个用户所有可能的关系路径
- 设备关联网络中,查找两个设备之间所有的关联路径
3.2.14 Paths(POST,高级版)
3.2.14.1 功能介绍
根据起始顶点、目的顶点、步骤(step)和最大深度等条件查找所有路径
Params
- sources:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- targets:定义终止顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供终止顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询终止顶点
- label:顶点的类型
- properties:通过属性的值查询终止顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- step:表示从起始顶点到终止顶点走过的路径,必填项,Step 的结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- max_depth:步数,必填项
- nearest:nearest 为 true 时,代表起始顶点到达结果顶点的最短路径长度为 depth,不存在更短的路径;nearest 为 false 时,代表起始顶点到结果顶点有一条长度为 depth 的路径(未必最短且可以有环),选填项,默认为 true
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的路径的最大数目,选填项,默认为 10
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.14.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.14.3 适用场景
查找两个顶点间的所有路径,例如:
- 社交网络中,查找两个用户所有可能的关系路径
- 设备关联网络中,查找两个设备之间所有的关联路径
3.2.15 Customized Paths
3.2.15.1 功能介绍
根据一批起始顶点、边规则(包括方向、边的类型和属性过滤)和最大深度等条件查找符合条件的所有的路径
Params
- sources:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- steps:表示从起始顶点走过的路径规则,是一组 Step 的列表。必填项。每个 Step 的结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- weight_by:根据指定的属性计算边的权重,sort_by 不为 NONE 时有效,与 default_weight 互斥
- default_weight:当边没有属性作为权重计算值时,采取的默认权重,sort_by 不为 NONE 时有效,与 weight_by 互斥
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - sample:当需要对某个 step 的符合条件的边进行采样时设置,-1 表示不采样,默认为采样 100
- sort_by:根据路径的权重排序,选填项,默认为 NONE:
- NONE 表示不排序,默认值
- INCR 表示按照路径权重的升序排序
- DECR 表示按照路径权重的降序排序
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的路径的最大数目,选填项,默认为 10
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.15.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.15.3 适用场景
适合查找各种复杂的路径集合,例如:
- 社交网络中,查找看过张艺谋所导演的电影的用户关注的大 V 的路径(张艺谋—>电影—->用户—>大 V)
- 风控网络中,查找多个高风险用户的直系亲属的朋友的路径(高风险用户—>直系亲属—>朋友)
3.2.16 Template Paths
3.2.16.1 功能介绍
根据一批起始顶点、边规则(包括方向、边的类型和属性过滤)和最大深度等条件查找符合条件的所有的路径
Params
- sources:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- targets:定义终止顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供终止顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询终止顶点
- label:顶点的类型
- properties:通过属性的值查询终止顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
- steps:表示从起始顶点走过的路径规则,是一组 Step 的列表。必填项。每个 Step 的结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- max_times:当前 step 可以重复的次数,当为 N 时,表示从起始顶点可以经过当前 step 1-N 次
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- with_ring:Boolean 值,true 表示包含环路;false 表示不包含环路,默认为 false
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的路径的最大数目,选填项,默认为 10
- with_vertex:true 表示返回结果包含完整的顶点信息(路径中的全部顶点),false 时表示只返回顶点 id,选填项,默认为 false
3.2.16.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.16.3 适用场景
适合查找各种复杂的模板路径,比如 personA -(朋友)-> personB -(同学)-> personC,其中"朋友"和"同学"边可以分别是最多 3 层和 4 层的情况
3.2.17 Crosspoints
3.2.17.1 功能介绍
根据起始顶点、目的顶点、方向、边的类型(可选)和最大深度等条件查找相交点
Params
- source:起始顶点 id,必填项
- target:目的顶点 id,必填项
- direction:起始顶点到目的顶点的方向,目的点到起始点是反方向,BOTH 时不考虑方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_depth:步数,必填项
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的交点的最大数目,选填项,默认为 10
3.2.17.2 使用方法
Method & Url
Response Status
Response Body
3.2.17.3 适用场景
查找两个顶点的交点及其路径,例如:
- 社交网络中,查找两个用户共同关注的话题或者大 V
- 家族关系中,查找共同的祖先
3.2.18 Customized Crosspoints
3.2.18.1 功能介绍
根据一批起始顶点、多种边规则(包括方向、边的类型和属性过滤)和最大深度等条件查找符合条件的所有的路径终点的交集
Params
sources:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
path_patterns:表示从起始顶点走过的路径规则,是一组规则的列表。必填项。每个规则是一个 PathPattern
- 每个 PathPattern 是一组 Step 列表,每个 Step 结构如下:
- direction:表示边的方向(OUT,IN,BOTH),默认是 BOTH
- labels:边的类型列表
- properties:通过属性的值过滤边
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:用于设置查询过程中舍弃超级顶点的最小边数,即当某个顶点的邻接边数目大于 skip_degree 时,完全舍弃该顶点。选填项,如果开启时,需满足
skip_degree >= max_degree约束,默认为 0 (不启用),表示不跳过任何点 (注意:开启此配置后,遍历时会尝试访问一个顶点的 skip_degree 条边,而不仅仅是 max_degree 条边,这样有额外的遍历开销,对查询性能影响可能有较大影响,请确认理解后再开启)
- 每个 PathPattern 是一组 Step 列表,每个 Step 结构如下:
capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
limit:返回的路径的最大数目,选填项,默认为 10
with_path:true 表示返回交点所在的路径,false 表示不返回交点所在的路径,选填项,默认为 false
with_vertex,选填项,默认为 false:
- true 表示返回结果包含完整的顶点信息(路径中的全部顶点)
- with_path 为 true 时,返回所有路径中的顶点的完整信息
- with_path 为 false 时,返回所有交点的完整信息
- false 时表示只返回顶点 id
- true 表示返回结果包含完整的顶点信息(路径中的全部顶点)
3.2.18.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.18.3 适用场景
查询一组顶点通过多种路径在终点有交集的情况。例如:
- 在商品图谱中,多款手机、学习机、游戏机通过不同的低级别的类目路径,最终都属于一级类目的电子设备
3.2.19 Rings
3.2.19.1 功能介绍
根据起始顶点、方向、边的类型(可选)和最大深度等条件查找可达的环路
例如:1 -> 25 -> 775 -> 14690 -> 25, 其中环路为 25 -> 775 -> 14690 -> 25
Params
- source:起始顶点 id,必填项
- direction:起始顶点发出的边的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_depth:步数,必填项
- source_in_ring:环路是否包含起点,选填项,默认为 true
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的可达环路的最大数目,选填项,默认为 10
3.2.19.2 使用方法
Method & Url
Response Status
Response Body
3.2.19.3 适用场景
查询起始顶点可达的环路,例如:
- 风控项目中,查询一个用户可达的循环担保的人或者设备
- 设备关联网络中,发现一个设备周围的循环引用的设备
3.2.20 Rays
3.2.20.1 功能介绍
根据起始顶点、方向、边的类型(可选)和最大深度等条件查找发散到边界顶点的路径
例如:1 -> 25 -> 775 -> 14690 -> 2289 -> 18379, 其中 18379 为边界顶点,即没有从 18379 发出的边
Params
- source:起始顶点 id,必填项
- direction:起始顶点发出的边的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_depth:步数,必填项
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
- limit:返回的非环路的最大数目,选填项,默认为 10
3.2.20.2 使用方法
Method & Url
Response Status
Response Body
3.2.20.3 适用场景
查找起始顶点到某种关系的边界顶点的路径,例如:
- 家族关系中,查找一个人到所有还没有孩子的子孙的路径
- 设备关联网络中,找到某个设备到终端设备的路径
3.2.21 Fusiform Similarity
3.2.21.1 功能介绍
按照条件查询一批顶点对应的"梭形相似点"。当两个顶点跟很多共同的顶点之间有某种关系的时候,我们认为这两个点为"梭形相似点"。举个例子说明"梭形相似点":“读者 A"读了 100 本书,可以定义读过这 100 本书中的 80 本以上的读者,是"读者 A"的"梭形相似点”
Params
sources:定义起始顶点,必填项,指定方式包括:
- ids:通过顶点 id 列表提供起始顶点
- label 和 properties:如果没有指定 ids,则使用 label 和 properties 的联合条件查询起始顶点
- label:顶点的类型
- properties:通过属性的值查询起始顶点
注意:properties 中的属性值可以是列表,表示只要 key 对应的 value 在列表中就可以
label:边的类型,选填项,默认代表所有 edge label
direction:起始顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
min_neighbors:最少邻居数目,邻居数目少于这个阈值时,认为起点不具备"梭形相似点"。比如想要找一个"读者 A"读过的书的"梭形相似点",那么
min_neighbors为 100 时,表示"读者 A"至少要读过 100 本书才可以有"梭形相似点",必填项alpha:相似度,代表:起点与"梭形相似点"的共同邻居数目占起点的全部邻居数目的比例,必填项
min_similars:“梭形相似点"的最少个数,只有当起点的"梭形相似点"数目大于或等于该值时,才会返回起点及其"梭形相似点”,选填项,默认值为 1
top:返回一个起点的"梭形相似点"中相似度最高的 top 个,必填项,0 表示全部
group_property:与
min_groups一起使用,当起点跟其所有的"梭形相似点"某个属性的值有至少min_groups个不同值时,才会返回该起点及其"梭形相似点"。比如为"读者 A"推荐"异地"书友时,需要设置group_property为读者的"城市"属性,min_group至少为 2,选填项,不填代表不需要根据属性过滤min_groups:与
group_property一起使用,只有group_property设置时才有意义max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
capacity:遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
limit:返回的结果数目上限(一个起点及其"梭形相似点"算一个结果),选填项,默认为 10
with_intermediary:是否返回起点及其"梭形相似点"共同关联的中间点,默认为 false
with_vertex,选填项,默认为 false:
- true 表示返回结果包含完整的顶点信息
- false 时表示只返回顶点 id
3.2.21.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.21.3 适用场景
查询一组顶点相似度很高的顶点。例如:
- 跟一个读者有类似书单的读者
- 跟一个玩家玩类似游戏的玩家
3.2.22 Vertices
3.2.22.1 根据顶点的 id 列表,批量查询顶点
Params
- ids:要查询的顶点 id 列表
Method & Url
Response Status
Response Body
3.2.22.2 获取顶点 Shard 信息
通过指定的分片大小 split_size,获取顶点分片信息(可以与 3.2.21.3 中的 Scan 配合使用来获取顶点)。
Params
- split_size:分片大小,必填项
Method & Url
Response Status
Response Body
3.2.22.3 根据 Shard 信息批量获取顶点
通过指定的分片信息批量查询顶点(Shard 信息的获取参见 3.2.21.2 Shard)。
Params
- start:分片起始位置,必填项
- end:分片结束位置,必填项
- page:分页位置,选填项,默认为 null,不分页;当 page 为“”时表示分页的第一页,从 start 指示的位置开始
- page_limit:分页获取顶点时,一页中顶点数目的上限,选填项,默认为 100000
Method & Url
Response Status
Response Body
3.2.22.4 适用场景
- 按 id 列表查询顶点,可用于批量查询顶点,比如在 path 查询到多条路径之后,可以进一步查询某条路径的所有顶点属性。
- 获取分片和按分片查询顶点,可以用来遍历全部顶点
3.2.23 Edges
3.2.23.1 根据边的 id 列表,批量查询边
Params
- ids:要查询的边 id 列表
Method & Url
Response Status
Response Body
3.2.23.2 获取边 Shard 信息
通过指定的分片大小 split_size,获取边分片信息(可以与 3.2.22.3 中的 Scan 配合使用来获取边)。
Params
- split_size:分片大小,必填项
Method & Url
Response Status
Response Body
3.2.23.3 根据 Shard 信息批量获取边
通过指定的分片信息批量查询边(Shard 信息的获取参见 3.2.22.2)。
Params
- start:分片起始位置,必填项
- end:分片结束位置,必填项
- page:分页位置,选填项,默认为 null,不分页;当 page 为“”时表示分页的第一页,从 start 指示的位置开始
- page_limit:分页获取边时,一页中边数目的上限,选填项,默认为 100000
Method & Url
Response Status
Response Body
3.2.23.4 适用场景
- 按 id 列表查询边,可用于批量查询边
- 获取分片和按分片查询边,可以用来遍历全部边
3.2.24 Adamic-Adar
3.2.24.1 功能介绍
计算两个顶点的 Adamic-Adar 指标,即每个共同邻居的度取对数后倒数之和。
Params
- vertex:一个顶点 id,必填项
- other:另一个顶点 id,必填项,不能与
vertex相同 - direction:顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- limit:参与计算的共同邻居的最大数目,选填项,默认为 10000000
3.2.24.2 使用方法
Method & Url
Response Status
Response Body
度为 0 的共同邻居会被跳过,因此两个顶点没有共同邻居时结果为 0.0。
3.2.24.3 适用场景
预测两个顶点之间是否可能出现连边,其中冷门的共同邻居比热门的共同邻居权重更高。
3.2.25 Resource Allocation
3.2.25.1 功能介绍
计算两个顶点的资源分配指标,即每个共同邻居的度的倒数之和。
Params
- vertex:一个顶点 id,必填项
- other:另一个顶点 id,必填项,不能与
vertex相同 - direction:顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- label:边的类型,选填项,默认代表所有 edge label
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- limit:参与计算的共同邻居的最大数目,选填项,默认为 10000000
3.2.25.2 使用方法
Method & Url
Response Status
Response Body
3.2.25.3 适用场景
连边预测,相比 Adamic-Adar 对高度数的共同邻居惩罚更强。
3.2.26 Edge Existence
3.2.26.1 功能介绍
查询起点和终点之间存在的边。
Params
- source:起始顶点 id,必填项
- target:目标顶点 id,必填项
- label:边的类型,选填项,默认代表所有 edge label
- sort_values:排序键的取值,当 edge label 的 frequency 为 MULTIPLE 时用于从多条平行边中选定一条,选填项,默认为空字符串
- limit:返回的边的最大数目,选填项,默认为 100
3.2.26.2 使用方法
Method & Url
Response Status
Response Body
3.2.26.3 适用场景
判断两个顶点之间是否直接相连,并在一次请求中拿到连接边的属性。
3.2.27 Count
3.2.27.1 功能介绍
统计从起始顶点出发,经过若干步遍历后可达的顶点数量,不返回顶点本身。
Params
- source:起始顶点 id,必填项
- steps:遍历的步骤,必填项,每个 step 支持以下字段:
- direction:顶点向外发散的方向(OUT,IN,BOTH),选填项,默认是 BOTH
- labels:当前 step 的边类型列表,选填项,默认代表所有 edge label
- properties:当前 step 的边属性过滤条件,选填项
- max_degree:当前 step 中单个顶点遍历的最大邻接边数目,选填项,默认为 10000
- skip_degree:当前 step 中跳过超级点的阈值,选填项,默认为 100000
- contains_traversed:是否把中间各步到达的顶点也计入结果,选填项,默认为 false
- dedup_size:用于去重的顶点数上限,
-1表示不限制,选填项,默认为 1000000
3.2.27.2 使用方法
Method & Url
Request Body
Response Status
Response Body
3.2.27.3 适用场景
只关心多步邻居的规模时使用,避免序列化和传输大量顶点。
3.2.28 Same Neighbors Batch (POST)
3.2.28.1 功能介绍
在单次批量 HTTP 请求中独立计算多组顶点对的共同邻居。
与接收单组顶点的 GET sameneighbors 接口不同,sameneighborsbatch 接收一个顶点对列表,并独立计算每一对顶点的共同邻居。
Params
- vertex_list:顶点对列表,必填项。每个元素必须且仅包含两个非空的顶点 ID。数值型 ID 必须为 64 位整型范围内的整数(
-9223372036854775808至9223372036854775807),也支持 String 和 UUID 格式。 - direction:顶点向外发散的方向(
OUT,IN,BOTH),选填项,默认是BOTH。 - label:边的类型过滤条件,选填项,默认代表所有 edge label。
- max_degree:遍历过程中单个顶点访问的最大邻接边数,选填项,默认为
10000,必须为正数或-1(不限制)。 - limit:每组顶点对返回的共同邻居最大数目,选填项,默认为
10000000,必须为不超过2147483647的正数或-1。
3.2.28.2 使用方法
Method & Url
Request Body
Response Status
Response Body
响应体包含与输入对顺序对应的二维数组 same_neighbors,以及包含遍历迭代计数和耗时的 measure:
遍历开始前会对 vertex_list 中的所有顶点对执行校验。若存在非法或不支持的顶点 ID,请求将直接拒绝。
无共同邻居的顶点对返回空数组 []。measure 中的计数统计涵盖该批次的所有顶点对。
3.2.28.3 适用场景
批量查询多组候选顶点之间的共同好友、共同关注或关联实体(如社交推荐、协同过滤),避免发起大量连续串行的 HTTP 请求。
Python 调用方:异步全图任务使用 client.olap(),立即返回的 OLTP 查询使用 client.traverser() 或 client.rank(),
详见 Python 客户端指南。
1.11 - Rank API
4.1 rank API 概述
HugeGraphServer 除了上一节提到的遍历(traverser)方法,还提供了一类专门做推荐的方法,我们称为rank API,可在图中为一个点推荐与其关系密切的其它点。
4.2 rank API 详解
4.2.1 Personal Rank API
Personal Rank 算法典型场景是用于推荐应用中,根据某个点现有的出边,推荐具有相近 / 相同关系的其他点,比如根据某个人的阅读记录 / 习惯,向它推荐其他可能感兴趣的书,或潜在的书友,举例如下:
- 假设给定 1 个 Person 点 是 tom, 它喜欢
a,b,c,d,e5 本书,我们的想给 tom 推荐一些书友,以及一些书,最容易的想法就是看看还有哪些人喜欢过这些书 (共同兴趣) - 那么此时,需要有其它的 Person 点比如 neo, 他喜欢
b,d,f3 本书,以及 jay, 它喜欢c,d,e,g4 本书,lee 它喜欢a,d,e,f4 本书 - 由于 tom 已经看过的书不需要重复推荐,所以返回结果里应该期望推荐有共同喜好的其他书友看过,但 tom 没看过的书,比如推荐 “f” 和 “g” 书,且优先级 f > g
- 此时再计算 tom 的个性化 rank 值,就会返回排序后 TopN 推荐的 书友 + 书 的结果了 (如果只需要推荐的书,选择 OTHER_LABEL 即可)
4.2.1.0 数据准备
上面是一个简单的例子,这里再提供一个公开的 1MB 测试数据集 MovieLens 为例,用户需下载该数据集,然后使用 HugeGraph-Loader 导入到 HugeGraph 中,简单起见,数据中顶点 user 和 movie 的属性都忽略,仅使用 id 字段即可,边 rating 的具体评分值也忽略。loader 使用的元数据文件和输入源映射文件内容如下:
注意将映射文件中
input.path的值修改为自己本地的路径。
4.2.1.1 功能介绍
适用于二分图,给出所有源顶点相关的其他顶点及其相关性组成的列表。
二分图:也称二部图,是图论里的一种特殊模型,也是一种特殊的网络流。其最大的特点在于,可以将图里的顶点分为两个集合,两个集合之间的点有边相连,但集合内的点之间没有直接关联。
假设有一个用户和物品的二分图,基于随机游走的 PersonalRank 算法步骤如下:
- 选定一个起点用户 u,其初始权重为 1.0,从 Vu 开始游走(有 alpha 的概率走到邻居点,1 - alpha 的概率停留);
- 如果决定向外游走,那么会选取某一个类型的出边,例如
rating来查找共同的打分人:- 那就从当前节点的邻居节点中按照均匀分布随机选择一个,并且按照均匀分布划分权重值;
- 给源顶点补偿权重 1 - alpha;
- 重复步骤 2;
- 达到一定步数或达到精度后收敛,得到推荐列表。
Params
必填项:
- source: 源顶点 id
- label: 源点出发的某类边 label,须连接两类不同顶点
选填项:
- alpha:每轮迭代时从某个点往外走的概率,与 PageRank 算法中的 alpha 类似,取值区间为 (0, 1], 默认值
0.85 - max_degree: 查询过程中,单个顶点遍历的最大邻接边数目,默认为
10000 - max_depth: 迭代次数,取值区间为 [2, 5000], 默认值
5 - with_label:筛选结果中保留哪些结果,可选以下三类,默认为
BOTH_LABEL- SAME_LABEL:仅保留与源顶点相同类别的顶点
- OTHER_LABEL:仅保留与源顶点不同类别(二分图的另一端)的顶点
- BOTH_LABEL:同时保留与源顶点相同和相反类别的顶点
- limit: 返回的顶点的最大数目,默认为
100 - max_diff: 提前收敛的精度差,默认为
0.0001(后续实现) - sorted:返回的结果是否根据 rank 排序,为 true 时降序排列,反之不排序,默认为
true
4.2.1.2 使用方法
Method & Url
Request Body
Response Status
Response Body
4.2.1.3 适用场景
两类不同顶点连接形成的二分图中,给某个点推荐相关性最高的其他顶点,例如:
- 阅读推荐: 找出优先给某人推荐的其他书籍, 也可以同时推荐共同喜好最高的书友 (例: 微信 “你的好友也在看 xx 文章” 功能)
- 社交推荐: 找出拥有相同关注话题的其他博主, 也可以推荐可能感兴趣的新闻/消息 (例: Weibo 中的 “热点推荐” 功能)
- 商品推荐: 通过某人现在的购物习惯, 找出应优先推给它的商品列表, 也可以给它推荐带货播主 (例: TaoBao 的 “猜你喜欢” 功能)
4.2.2 Neighbor Rank API
4.2.2.0 数据准备
4.2.2.1 功能介绍
在一般图结构中,找出每一层与给定起点相关性最高的前 N 个顶点及其相关度,用图的语义理解就是:从起点往外走,走到各层各个顶点的概率。
Params
- source: 源顶点 id,必填项
- alpha:每轮迭代时从某个点往外走的概率,与 PageRank 算法中的 alpha 类似,必填项,取值区间为 (0, 1]
- steps: 表示从起始顶点走过的路径规则,是一组 Step 的列表,每个 Step 对应结果中的一层,必填项。每个 Step 的结构如下:
- direction:表示边的方向(OUT, IN, BOTH),默认是 BOTH
- labels:边的类型列表,多个边类型取并集
- max_degree:查询过程中,单个顶点遍历的最大邻接边数目,默认为 10000;当前也兼容参数名
degree。 - skip_degree:当前层跳过超级点的阈值,默认为 0,表示不跳过
- top:在结果中每一层只保留权重最高的前 N 个结果,默认为 10,最大值为 1000
- capacity: 遍历过程中最大的访问的顶点数目,选填项,默认为 10000000
4.2.2.2 使用方法
Method & Url
Request Body
Response Status
Response Body
4.2.2.3 适用场景
为给定的起点在不同的层中找到最应该推荐的顶点。
- 比如:在观众、朋友、电影、导演的四层图结构中,根据某个观众的朋友们喜欢的电影,为这个观众推荐电影;或者根据这些电影是谁拍的,为其推荐导演。
Python 调用方:异步全图任务使用 client.olap(),立即返回的 OLTP 查询使用 client.traverser() 或 client.rank(),
详见 Python 客户端指南。
1.12 - Variable API
5.1 Variables
Variables 可以用来存储有关整个图的数据,数据按照键值对的方式存取
5.1.1 创建或者更新某个键值对
Method & Url
Request Body
Response Status
Response Body
5.1.2 列出全部键值对
Method & Url
Response Status
Response Body
5.1.3 列出某个键值对
Method & Url
Response Status
Response Body
5.1.4 删除某个键值对
Method & Url
Response Status
1.13 - Graphs API
6.1 Graphs
生产环境必须启用 Server 认证与授权,通过 IP 白名单及最小权限控制图管理接口的访问,并保留 audit-*.log 审计记录。下文非鉴权配置仅用于隔离的本地测试。
本页介绍当前 master 的 Graphs API。历史版本的路径和请求体请切换到对应多版本页面: 1.7 版 Graphs API 或 1.5 版 Graphs API。
启用鉴权时,创建、克隆、删除、清空、修改图显示名、读取图配置、设置读模式和手动压缩等操作要求图空间管理权限(space);管理员可按权限继承规则满足。创建或恢复快照、设置数据模式允许图空间管理者或该图所有者操作;列表、详情、数据模式读取和读模式读取按图读取权限校验。Raft API 另要求图空间成员权限。
GET /apis是资源索引。索引中的资源路径属于 Server 根地址,应使用/versions、/graphspaces与/gremlin,不要再加/apis前缀。旧版索引没有前导斜杠,应相对 Server 根路径解析,不能拼到索引目录下面。网关另有公开路径前缀时,保留该前缀。GET /graphspaces仅支持 PD 模式;独立部署模式请使用GET /graphs列出已配置的图。- 动态建图使用
POST /graphspaces/{space}/graphs/{graph},并提供后端要求的图配置。POST /graphs不是建图接口。旧形态/graphs能列出图,并不表示 GraphSpace API 不存在。运行 SeaTunnel 自带 sink 示例前,请按 SeaTunnel 指南 先创建目标图。
6.1.1 列出图空间中全部的图
Params
路径参数说明:
- graphspace: 图空间名称
Method & Url
Response Status
Response Body
6.1.2 查看某个图的信息
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Method & Url
Response Status
Response Body
6.1.3 清空某个图的全部数据,包括 schema、vertex、edge 和 index 等
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
由于清空图是一个比较危险的操作,为避免用户误调用,我们给 API 添加了用于确认的参数:
- confirm_message: 默认为
I'm sure to delete all data
Method & Url
Response Status
6.1.4 克隆一个图
HugeGraph 提供两种图克隆方式:
- 模式一:仅配置克隆(Configuration Clone):仅复制源图的配置信息,不复制 Schema、顶点或边数据。
- 模式二:Schema 克隆(Schema Clone,Server API 0.73+):在同一图空间内复制源图配置及属性键、顶点标签和索引标签,不复制顶点与边数据。
模式一:仅配置克隆
通过图创建端点配合查询参数 clone_graph_name 复制源图配置。
在 PD 模式下,若源图配置了 schema.init_template,克隆出的新图也会继承该配置并基于模板初始化 Schema。
Params
路径参数:
graphspace: 图空间名称graph: 要创建的新图名称
查询参数:
clone_graph_name: 源图名称。注意必须作为 Query 参数传入,不能放在请求体 JSON 中。
Method & Url
Request Body (可选)
可选择传入 JSON 配置覆盖源图配置(例如自定义存储目录等):
- RocksDB 存储路径不能与现有图冲突,需指定不同目录。
- 如需开启权限认证,需设置
"gremlin.graph": "org.apache.hugegraph.auth.HugeFactoryAuthProxy"。
Response Status
Response Body
模式二:Schema 克隆(Server API 0.73+)
自 HugeGraph 1.8.0(Server REST API 0.73+)起提供同步的 Schema 克隆接口。该接口在同一图空间内创建新图,并复制源图的所有属性键、顶点标签及相关索引,但不复制顶点与边数据。复制时会自动清空 schema.init_template,以准确复制源图当时的实际 Schema。
克隆期间请保持源图 Schema 不变。开启鉴权时,调用该接口需要图空间管理权限(Space Admin)。
暂不支持包含边标签(EdgeLabel)的源图:由于部分后端存储无法可靠还原边标签的继承层级,若源图包含任何边标签,服务端将在创建目标图前直接拦截拒绝;克隆过程中若有新增边标签也会报错中断。
非原子操作与残留清理:Schema 复制不是原子事务。若在创建目标图后复制 Schema 元素失败,新图可能处于部分初始化的状态且对外可见。服务端不会自动回滚或删除已建的图;遇到失败需排查并显式调用删除接口清理该目标图后再重试。
Params
路径参数:
graphspace: 图空间名称graph: 要创建的目标图名称
查询参数:
source: 同一图空间内的源图名称(必填)
Method & Url
Request Body (可选)
仅支持通过 JSON 指定 nickname(可选):
Response Status
Response Body
6.1.5 创建一个图
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Method & Url
Request Body
创建一个图(设置 Content-Type: application/json)
gremlin.graph 配置说明:
- 鉴权模式:
"gremlin.graph": "org.apache.hugegraph.auth.HugeFactoryAuthProxy"(生产环境必须使用) - 非鉴权模式:
"gremlin.graph": "org.apache.hugegraph.HugeFactory"
注意:如果 backend 是 hstore,请确保 HugeGraph-Server 已正确配置 PD,参见 HStore 配置。调度器由后端类型决定:hstore 使用分布式调度器,其他后端使用本地调度器。
选填字段及其默认值:
gremlin.graph默认为org.apache.hugegraph.HugeFactorybackend在 PD 模式下默认为hstore,否则默认为rocksdbserializer默认为binarystore默认为图名称nickname设置图的显示名,在图空间内必须唯一schema指定初始化该图所用的 schema 模板,会被保存为schema.init_templatedescription会原样返回在响应中
RocksDB 示例:
HStore 示例:
Note: Rocksdb 存储路径不能与现有图相同(需使用不同的目录)
Response Status
Response Body
6.1.6 删除某个图及其全部数据
启用鉴权时需要图空间管理权限(space)。
删图前停止所有使用该图的 Server 的写入和任务,并在失败及重试期间持续保持停止状态。 所有 Server 上的删除完成且经确认前,不得重建同名图。通知送达不构成集群范围的屏障。
执行删除的 Server 会关闭新任务准入,并等待实际执行、取消回调和事务清理结束。
配置的任务等待超时(task.wait_timeout,单位秒)时,会在移除数据、配置或元数据前拒绝删除;待执行对象退出后再重试。
因任务未排空而拒绝删除后,任务准入仍保持关闭。若要在破坏性清理前恢复正常用图,保持写入和任务生产者停止,
等待全部已准入任务和取消清理结束后再重启 Server;重启不会恢复已经移除的数据或元数据。
仅关闭调度器时,尚未开始的持久化任务仍保留在存储中。
删图不是事务操作,破坏性清理后的失败不会恢复已移除的数据或元数据。执行对象或原生资源的清理结果不确定时需要人工检查,
不能强制移除调度器,也不能仅凭任务 Future 已完成就恢复写入。
在启用 PD 且 graph.load_from_local_config=true 的部署中,若因使用本地配置而拒绝删除,
移除对应配置文件并重启 Server 仅会阻止 Server 继续加载该图,其后端存储数据仍会保留。
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
由于删除图是一个比较危险的操作,为避免用户误调用,我们给 API 添加了用于确认的参数:
- confirm_message: 默认为
I'm sure to drop the graph
Method & Url
Response Status
6.1.7 列出图空间中全部的图及其配置
对当前用户有读权限的每个图返回一条记录,其中包含该图的配置(形如密码、密钥、token、凭证、私钥的配置项会被过滤掉)以及下面这些字段。当前用户的默认图会排在前面。
Params
路径参数说明:
- graphspace: 图空间名称
请求参数说明:
- prefix: 只返回名称或显示名以该前缀开头的图
Method & Url
Response Status
Response Body
default_update_time 只在该图是当前用户的默认图时返回,create_time 只在该图记录了创建时间时返回。
6.1.8 修改某个图的显示名
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
- action: 固定为
update - update: 需要修改的字段。
name必填且必须与路径中的图名一致,nickname是新的显示名,在图空间内必须唯一。
Method & Url
Request Body
Response Status
Response Body
6.1.9 管理当前用户的默认图
默认图是按用户记录的,因此下面的接口都以调用者的身份生效。它们依赖权限系统,未开启权限的单机模式下会返回 400 和 GraphSpace management is not supported in standalone mode。
设置默认图
Method & Url
Response Status
Response Body
取消默认图
Method & Url
Response Status
Response Body
查看默认图
Method & Url
Response Status
Response Body
6.1.10 重新加载图空间中的图
图配置变化通过重启 Server 应用。热重载恢复尚未实现,不要使用此接口进行配置维护。 当前未启用 PD 的执行路径中,reload 会调用删图流程,可能清空后端数据。重启完成并确认加载了预期图之前,持续停止写入和任务。 下方请求及响应仅说明 API 格式,不代表维护或恢复保障。
Params
路径参数说明:
- graphspace: 图空间名称
请求参数说明:
- action: 固定为
reload
Method & Url
Request Body
Response Status
Response Body
6.1.11 克隆图 Schema
从 Server API 版本 0.73 起,支持将同一图空间内已有源图的 Schema 同步克隆到新建的目标图中。 该接口会同步复制源图的全部属性类型(Property Key)、顶点类型(Vertex Label)和索引标签(Index Label)。
该接口仅复制 Schema,不复制图中的顶点和边数据。若源图包含任何边类型(Edge Label),接口将在创建目标图前直接拒绝, 因为部分后端存储无法安全保留边类型所需的层次元数据。克隆期间应停止对源图 Schema 进行修改。 若目标图创建后克隆过程出错,目标图可能处于部分 Schema 状态,需人工排查并显式删除后重试。
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 要创建的目标图名称
请求参数说明:
- source: 被克隆的源图名称(必填)
Method & Url
Request Body (可选)
可选的 JSON 请求体,仅支持设置目标图的 nickname(设置 Content-Type: application/json):
Response Status
Response Body
6.2 Conf
6.2.1 查看某个图的配置
Method & Url
Response Status
Response Body
6.3 Mode
合法的图模式包括:NONE,RESTORING,MERGING,LOADING
- None 模式(默认),元数据和图数据的写入属于正常状态。特别的:
- 元数据(schema)创建时不允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,不允许指定 ID
- LOADING:批量导入数据时自动启用,特别的:
- 添加顶点/边时,不会检查必填属性是否传入
Restore 时存在两种不同的模式:Restoring 和 Merging
- Restoring 模式,恢复到一个新图中,特别的:
- 元数据(schema)创建时允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,允许指定 ID
- Merging 模式,合并到一个已存在元数据和图数据的图中,特别的:
- 元数据(schema)创建时不允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,允许指定 ID
正常情况下,图模式为 None,当需要 Restore 图时,需要根据需要临时修改图模式为 Restoring 模式或者 Merging 模式,并在完成 Restore 时,恢复图模式为 None。
6.3.1 查看某个图的模式
启用鉴权时需要图读取权限(space_member 或该图的所有者)。
Method & Url
Response Status
Response Body
合法的图模式包括:NONE,RESTORING,MERGING,LOADING
6.3.2 设置某个图的模式
启用鉴权时需要图空间管理权限(space)或该图所有者权限;管理员可按权限继承规则满足。
Method & Url
Request Body
合法的图模式包括:NONE,RESTORING,MERGING,LOADING
存在活跃的 loading owner 时,此枚举 PUT 会拒绝所有模式修改,包括 "LOADING"。请先停止导入 worker,再释放其 owner。
Response Status
Response Body
6.3.3 查看某个图的读模式
启用鉴权时需要图读取权限(space_member 或该图的所有者)。
Params
- name: 图的名称
Method & Url
Response Status
Response Body
6.3.4 设置某个图的读模式
启用鉴权时需要图空间管理权限(space);管理员可按权限继承规则满足。
Params
- name: 图的名称
Method & Url
Request Body
合法的读模式包括:ALL,OLTP_ONLY。传入 OLAP_ONLY 时接口会报错
Graph-read-mode could be ALL or OLTP_ONLY。
Response Status
Response Body
6.3.5 LOADING owner 管理
自 HugeGraph 1.8.0 起提供 owner 协议 1 接口(需配合返回 protocol: 1 的新版 Server 与对应 Loader;当前 master 分支暂未包含该协议);
Loader 需使用配套的 1.8.0 及以上版本客户端。旧版本发行包、早期 1.8 构建以及当前 master 分支均不包含该协议;仅支持 LOADING 枚举不能说明支持这些接口。
启用鉴权时,两个接口沿用模式设置接口的权限要求,即图空间管理权限(space)或该图所有者权限,并校验 STATUS 写权限。
Server 将句柄绑定到实际鉴权用户;token 本身不赋予权限。申请、释放和重试必须保持相同身份。
200 能力响应包含图实例 UUID、当前非负 epoch 及状态 revision:
每轮导入生成一个新的小写连字符 UUID(lowercase hyphenated UUID)作为 token,保留返回的 instance 和 epoch,通过以下请求申请,并设置 Content-Type: application/json:
只有响应中包含 state: "active" 时才表示申请成功;此时返回 200 并回显 protocol、instance、epoch、token 以及 mode: "LOADING"。
若返回 200 但 state: "released",说明该句柄已失效或已被提前取消,此时并未获得 owner 保护;必须先停止并排空该次导入尝试,然后再通过 GET 获取新的 instance 和 epoch 并使用新 token 重新发起尝试。
释放时将 action 设置为 release,句柄保持不变;响应中包含 state: "released" 和当前实际模式。未申请前直接调用释放会被记录,并导致后续使用该句柄的申请直接返回 released。
重试保留同一句柄;Server 校验其鉴权身份、instance 和 epoch。已释放句柄不能再次申请。
当异常中断(如 kill -9)导致句柄残留时,管理员可发起强制恢复请求:
管理员恢复需要全局管理员权限(admin)。调用方必须传入从 GET /mode/owners 获取的当前 revision、instance 和 epoch,
以及确认文案 confirm: "I'm sure all imports have stopped"。
若传入的 revision 与服务端当前状态不一致,请求将被拒绝并返回 HTTP 409 Conflict。
恢复成功后服务端清除所有残留 owner,将图模式重置为 NONE 并递增 epoch,返回 HTTP 200(含 state: "recovered" 和 mode: "NONE")。
首个 owner 要求 NONE;其他 owner 共享由 owner 管理的 LOADING,最后一个释放后恢复 NONE。
手动设置的 LOADING、RESTORING 和 MERGING 不会被接管;owner 活跃时,旧枚举 PUT 会拒绝模式修改。
该协议保护同一 Server 上实际运行的图实例中的普通导入,句柄绑定到实际鉴权身份、instance 和 epoch。
它不提供跨 Server 协调、数据写入隔离或自动过期。请使用固定的 Server 直连地址,在导入停止后释放。
升级后的 Loader 仅在 owner 探测返回接口路由不受支持的 404 时回退到旧行为;其他错误仍失败。
图数据源和恢复导入保留原有枚举模式行为,参见 Loader 兼容与恢复说明。
6.4 Snapshot
6.4.1 创建快照
启用鉴权时需要图空间管理权限(space)或该图所有者权限;管理员可按权限继承规则满足。
Params
- name: 图的名称
Method & Url
Response Status
Response Body
6.4.2 快照恢复
启用鉴权时需要图空间管理权限(space)或该图所有者权限;管理员可按权限继承规则满足。
Params
- name: 图的名称
Method & Url
Response Status
Response Body
6.5 Compact
6.5.1 手动压缩图
启用鉴权时需要图空间管理权限(space);管理员可按权限继承规则满足。
Params
- name: 图的名称
Method & Url
Response Status
Response Body
6.6 Raft
以下接口只在图运行于 raft 模式时可用,参见 配置项 中的 raft.mode。未开启 raft 模式的图会返回 400 和 Allowed <operation> operation only when working on raft mode。
启用鉴权时需要图空间成员权限(space_member);管理员可按权限继承规则满足。
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
- group: raft 组名称,默认为
default - endpoint: 节点地址,形如
host:port。transfer_leader、set_leader、add_peer和remove_peer必填。
6.6.1 查看 raft 组的成员列表
Method & Url
Response Status
Response Body
返回对象的 key 是 raft 组名称。
6.6.2 查看 raft 组的 leader
Method & Url
Response Status
Response Body
6.6.3 转移 raft 组的 leader
Method & Url
Response Status
Response Body
6.6.4 指定 raft 组的 leader
Method & Url
Response Status
Response Body
6.6.5 向 raft 组添加成员
该操作会创建一个异步任务,参见 Task API。
Method & Url
Response Status
Response Body
6.6.6 从 raft 组移除成员
该操作会创建一个异步任务,参见 Task API。
Method & Url
Response Status
Response Body
1.14 - Task API
7.1 Task
轮询到 task_status 为终态后再读取 task_result;running 不表示任务已经完成。
Hubble 客户端传输超时与 Server 执行超时是不同限制,仅调整其中一个不会移除另一个。
不要把 Hubble 封装的任务 ID(可能映射为负数)直接传给 Server 原生 /tasks/{id}。
7.1.1 列出某个图中全部的异步任务
Params
- status: 异步任务的状态,取值为 NEW、SCHEDULING、SCHEDULED、QUEUED、RESTORING、RUNNING、SUCCESS、CANCELLING、CANCELLED、FAILED、HANGING、DELETING 之一,不区分大小写
- ids: 需要查询的任务 id,可以重复传多个。不能与
status或page同时使用,并且会忽略limit - limit:返回异步任务数目上限,默认为 100
- page: 分页的页标记,传该参数时响应中会带上下一页的
page字段
Method & Url
Response Status
Response Body
7.1.2 查看某个异步任务的信息
Params
- with_result: 是否加载任务的结果,默认为 true
Method & Url
Response Status
Response Body
7.1.3 删除某个异步任务信息,不删除异步任务本身
Params
- force: 任务仍在运行时是否强制删除,默认为 false
任务记录删除与删图是不同操作。图维护须遵守图 API中的停写和任务清理要求。
Method & Url
Response Status
7.1.4 取消某个异步任务,该异步任务必须具有处理中断的能力
假设已经通过Gremlin API创建了一个异步任务如下:
Method & Url
请保证在 10 秒内发送该请求,如果超过 10 秒发送,任务可能已经执行完成,无法取消。
Response Status
对已经完成或者正在取消中的任务发起取消会返回 400。
Response Body
返回整个任务对象,其中 task_status 为 cancelling 或 cancelled:
此时查询 label 为 man 的顶点数目,一定是小于 10 的。
7.2 Algorithm Job
在服务内部以异步任务的方式调度一个 OLAP 算法,返回的 task id 可以用上面的 Task API 跟踪。
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- name: 算法名称,已注册的算法有
count_vertex、count_edge、degree_centrality、stress_centrality、betweenness_centrality、closeness_centrality、eigenvector_centrality、triangle_count、cluster_coefficient、lpa、louvain、weak_connected_component、fusiform_similarity、rings、k_core、page_rank和subgraph_stat。名称不存在时返回404。
Method & Url
Request Body
请求体是算法的参数集合,每个算法各自校验自己的参数。传 {} 表示全部使用默认值。
Response Status
Response Body
7.3 Computer Job
以异步任务的方式调度一个 HugeGraph-Computer 作业。该作业在服务外部执行,参见 HugeGraph-Computer。
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
- name: 算法名称,已注册的有
page_rank、weak_connected_component、lpa、triangle_count和louvain。名称不存在时返回404。
Method & Url
Request Body
请求体是作业的参数集合,传 {} 表示全部使用默认值。
Response Status
Response Body
Python 调用方:异步全图任务使用 client.olap(),立即返回的 OLTP 查询使用 client.traverser() 或 client.rank(),
详见 Python 客户端指南。
1.15 - Gremlin API
8.1 Gremlin
Gremlin 遍历语法、特性支持与升级说明请查阅 图查询语言 - Gremlin。
生产环境下安全使用原生查询接口
图查询语言 (如 Gremlin/Cypher) 本身的灵活性会带来一些潜在的安全隐患。为了保障核心安全,请避免直接在公网环境暴露任何相关的原生查询接口。
生产环境必须开启 鉴权体系 (Auth)、启用并维护 IP 白名单,并按最小权限控制用户可执行的操作。Server 标准配置会把鉴权代理的授权记录写入 audit-*.log;必须保留并限制其读取权限。auth.audit_log_rate 只限制每用户日志输出速率,不是审计日志的启停开关。
8.1.1 向 HugeGraphServer 发送 gremlin 语句(GET),同步执行
Params
- gremlin: 要发送给
HugeGraphServer执行的gremlin语句 - bindings: 用来绑定参数,key 是字符串,value 是绑定的值(只能是字符串或者数字),功能类似于 MySQL 的 Prepared Statement,用于加速语句执行
- language: 发送语句的语言类型,默认为
gremlin-groovy - aliases: 为存在于图空间的已有变量添加别名
此 REST 代理的 GET 查询不能可靠地传递含 JSON 花括号的 aliases 参数;当前图绑定名带连字符,也不能直接作为 Groovy 变量。以下用简单表达式示范 GET。需要选择图执行遍历时,请使用下方带 aliases 的 POST 示例。
Method & Url
Response Status
Response Body
8.1.2 向 HugeGraphServer 发送 gremlin 语句(POST),同步执行
查询顶点数
可执行请求命令
/gremlin 是顶层接口。图空间 DEFAULT 中图 hugegraph 对应的 traversal source 名为 __g_DEFAULT-hugegraph,请求通过 aliases 映射为脚本中的 g。若使用不同图空间或图名,应按 Server 绑定名调整 alias。批量结果可能以 gzip 返回,curl 使用 --compressed 可自动解压。
绑定名区分大小写:<space>-<graph> 是图,__g_<space>-<graph> 是遍历源。多图 Server 没有隐含的全局 g。
bindings 用于查询变量,不能注册图;alias 目标也不能写成 graph.traversal() 表达式。
没有 GraphSpace 的旧版独立图使用 <graph> 与 __g_<graph>。Server 启用鉴权时,补充配置要求的 HTTP 凭据,例如 -u "$HG_USER:$HG_PASSWORD"。
同步 Gremlin 默认执行上限为 30000 毫秒,由 gremlin-server.yaml 的 evaluationTimeout 配置。
全图计数与按标签过滤计数可能走不同执行路径,不能用 g.V().count() 的耗时推断标签扫描耗时。
可能超过同步限制的查询应提交 Server 异步任务(见下文 8.1.3 节)。
轮询到 task_status 为终态后再读取 task_result;running 不表示计数已经完成。
Hubble 客户端传输超时与 Server 执行超时是不同限制,仅调整其中一个不会移除另一个。
Response Status
Response Body
顶点数取决于当前图中的数据;上面的 6 仅为示例结果。
响应体的结构与其他 Vertex 或 Edge 的 RESTful API 的结构有区别,用户可能需要自行解析。
查询边
Request Body
Response Status
Response Body
边 ID、端点和属性值取决于当前图中的数据。
8.1.3 向 HugeGraphServer 发送 gremlin 语句(POST),异步执行
Method & Url
查询顶点
Request Body
注意:
异步请求不能自行传入
aliases字段;Server 会自动绑定graph(当前图对象)和g(当前遍历源),并把 URL 中的图名作为graph的别名。因此脚本可以使用graph或g,也可以使用当前请求路径中的图名。
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/1(其中"1"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
查询边
Request Body
Response Status
Response Body
注:
可以通过
GET http://localhost:8080/graphspaces/DEFAULT/graphs/hugegraph/tasks/2(其中"2"是 task_id)来查询异步任务的执行状态,更多异步任务 RESTful API
1.16 - Cypher API
9.1 Cypher
Cypher 语法、语句示例与转译限制请查阅 图查询语言 - Cypher 及 Cypher 兼容性矩阵。
当服务端未开启鉴权时,无需携带
Authorization请求头且凭证不参与鉴权校验; 开启鉴权后,支持Basic(标准 RFC 4648 Base64 编码)或BearerToken(未携带认证信息的请求返回 401),并沿用已验证的调用者权限执行查询。 在 1.2.0 至 1.7.0 版本中,未开启鉴权时也必须携带该头。
9.1.1 向 HugeGraphServer 发送 Cypher 语句(GET),同步执行
Method & Url
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
请求参数说明:
- cypher: cypher 语句
使用示例
Response Status
Response Body
9.1.2 向 HugeGraphServer 发送 Cypher 语句(POST 原始文本),同步执行
Method & Url
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Body
{cypher}
- cypher: cypher 语句
注意:
请求体包含原始 Cypher 纯文本语句(也支持传入 JSON 对象体,详见 9.1.3)。但服务端接口使用
@Consumes(APPLICATION_JSON)约束,POST 请求必须显式声明-H "Content-Type: application/json"请求头;若使用text/plain会被拒绝并返回 HTTP 415。
使用示例
Response Status
Response Body
9.1.3 向 HugeGraphServer 发送参数化 Cypher 语句(POST JSON,推荐),同步执行
Method & Url
Params
路径参数说明:
- graphspace: 图空间名称
- graph: 图名称
Body
- cypher: Cypher 查询语句(引用绑定参数使用
$param形式) - parameters: 参数映射表(JSON 对象,顶层最多支持 16 个键;更多属性可放入嵌套 Map 中)
使用示例
Response Status
Response Body
9.1.4 Cypher 结构化错误响应与错误码
当 Cypher 语句解析、转译或执行失败时,HugeGraphServer 返回兼容 Gremlin 规范的响应体,HTTP 状态码保持为 200,status.code 为 400。
结构化的错误详情挂载在 status.attributes.errors 数组中。
HTTP 层错误(如鉴权失败 401 或不支持的媒体类型 415)属于独立处理路径,不使用此响应封套。
客户端应检查响应体中的 status.code,而非单纯依赖 HTTP 状态码。响应中不包含顶层 errors 字段。
错误响应结构
status.attributes.errors 中的每个元素包含以下字段:
code: 稳定的错误代码字符串。message: 来自转译器或执行引擎的详细错误信息(具体文字描述不作为强约束契约)。hint: 明确的操作指引与排错建议(无具体指引时为空字符串)。
错误码列表
| 错误码 | 识别的失败类型 | 提示信息(Hint) |
|---|---|---|
HugeGraph.Cypher.SyntaxError | 语法解析错误、未知函数、多条语句或未定义变量 | 提示语法规则(如单语句、在 MATCH/WITH 声明变量) |
HugeGraph.Cypher.ExecutionError | 顶点/边类型、属性或索引未定义;未识别错误兜底 | 建议通过 Schema API 创建元数据;兜底为空字符串 |
HugeGraph.Cypher.UnsupportedFeature | 不支持的子句、match/create 模式或函数谓词 | 建议查阅 Cypher 兼容性指南确认受支持语法 |
- SyntaxError: 语法解析错误、不支持的内置函数、带行列位置的语义错误、单次请求包含多条语句,或未在
MATCH、UNWIND、WITH中声明即引用的变量。 - ExecutionError: 顶点类型、边类型、属性或索引未定义错误。该错误码同时作为未分类转译错误及底层运行时异常的统一兜底分类,并不意味着图遍历已开始执行。
- UnsupportedFeature: 当前 Cypher 转译器不支持的子句、匹配/创建模式、属性类型或自定义谓词。
1.17 - Authentication API
版本说明:本页介绍当前
master的接口。历史用法请切换到对应多版本页面: 1.7 版认证 API 或 1.5 版认证 API。用户、图空间用户组、资源、关联和赋权接口使用
/graphspaces/{graphspace}/auth/...。登录、登出和 token 校验仍使用/auth/login、/auth/logout、/auth/verify;图空间默认角色接口位于/graphspaces/{graphspace}/role。源码保留顶层/auth/groups,本页组接口示例使用图空间范围接口。
下文 {group_id}、{target_id}、{another_target_id}、{belong_id} 和 {access_id} 均为占位符,使用前须替换为对应响应中的 id。将 ID 放入 URL 路径时,还须按 URL 路径组件规则编码。
10.1 用户认证与权限控制
开启权限及相关配置请先参考 权限配置 文档
用户认证与权限控制概述:
HugeGraph 支持多用户认证、以及细粒度的权限访问控制,采用基于“用户 - 用户组 - 操作 - 资源”的 4 层设计,灵活控制用户角色与权限。 资源描述了图数据库中的数据,比如符合某一类条件的顶点,每一个资源包括 type、label、properties 三个要素,共有 18 种 type、 任意 label、任意 properties 的组合形成的资源,一个资源的内部条件是且关系,多个资源之间的条件是或关系。用户可以属于一个或多个用户组,每个用户组可以拥有对任意个资源的操作权限,操作类型包括:读、写、删除、执行等种类。HugeGraph 支持动态创建用户、用户组、资源, 支持动态分配或取消权限。初始化数据库时超级管理员用户被创建,后续可通过超级管理员创建各类角色用户,新创建的用户如果被分配足够权限后,可以由其创建或管理更多的用户。
举例说明:
user(name=boss) -belong-> group(name=all) -access(read)-> target(graph=graph1, resource={label: person,
city: Beijing})
描述:用户’boss’拥有对’graph1’图中北京人的读权限。
接口说明:
用户认证与权限控制的核心接口包括 5 类核心接口与配套管理 API:
- 用户 (User) API — 管理用户账号、密码及基本信息。
- 用户组 (Group) API — 管理用户组,实现基于角色的聚合。
- 资源 (Target) API — 定义可访问的资源类型与过滤边界。
- 关联角色 (Belong) API — 将用户关联绑定到用户组。
- 赋权 (Access) API — 为用户组授予对应资源的访问权限。
- 登录与管理员 API — 授予图空间管理角色以及签发校验 Token。
10.2 用户(User)API
用户接口包括:创建用户,删除用户,修改用户,和查询用户相关信息接口。
10.2.1 创建用户
Params
- user_name: 用户名称
- user_password: 用户密码
- user_nickname: 用户昵称
- user_phone: 用户手机号
- user_email: 用户邮箱
- user_avatar: 用户头像地址
- user_description: 用户描述
其中 user_name 和 user_password 为必填,其余为选填。
Request Body
Method & Url
Response Status
Response Body
返回报文中,密码为加密后的密文
10.2.2 删除用户
Params
- id: 需要删除的用户 Id
Method & Url
Response Status
10.2.3 修改用户
Params
- id: 需要修改的用户 Id
Method & Url
Request Body
修改 user_password 和 user_phone。user_name 不可修改,传了也必须与已有名称一致。
Response Status
Response Body
返回结果是包含修改过的内容在内的整个用户对象
10.2.4 查询用户列表
Params
- name: 只返回该名称的用户,传该参数时返回的是单个用户对象而不是列表,用户不存在时返回
404 - limit: 返回结果条数的上限,默认为 100
Method & Url
Response Status
Response Body
10.2.5 查询某个用户
Params
- id: 需要查询的用户 Id
Method & Url
Response Status
Response Body
10.2.6 查询某个用户的角色
Method & Url
Response Status
Response Body
10.3 用户组(Group)API
用户组会赋予相应的资源权限,用户会被分配不同的用户组,即可拥有不同的资源权限。
用户组接口包括:创建用户组,删除用户组,修改用户组,和查询用户组相关信息接口。
GraphSpace 用户组名由服务端生成,格式为
~hubble_role:v1:+ GraphSpace 名称的 base64url 编码 +:+ 32 个十六进制字符。 例如,DEFAULT的名称和 ID 都是~hubble_role:v1:REVGQVVMVA:<32 hex>。请求中的group_name只是客户端标签;后续请求请用创建响应返回的 ID。
10.3.1 创建用户组
Params
- group_name: 必填的客户端标签;持久化名称由服务端生成
- group_description: 用户组描述
Request Body
group_name 为必填字段;图空间范围的用户组持久化名称由服务端生成,不能用此字段自定义。请从创建响应中复制 id,用于后续关联、授权、查询、更新或删除。
Method & Url
Response Status
Response Body
10.3.2 删除用户组
Params
- id: 需要删除的用户组 Id
Method & Url
Response Status
10.3.3 修改用户组
Params
- id: 需要修改的用户组 Id
Method & Url
Request Body
修改 group_description。GraphSpace 形式下这里的 group_name 应当省略,或等于服务端生成的名称,传入其他值会被拒绝并提示 “The name of group can’t be updated”。
Response Status
Response Body
返回结果是包含修改过的内容在内的整个用户组对象
10.3.4 查询用户组列表
Params
- limit: 返回结果条数的上限
Method & Url
Response Status
Response Body
10.3.5 查询某个用户组
Params
- id: 需要查询的用户组 Id
Method & Url
Response Status
Response Body
10.4 资源(Target)API
资源描述了图数据库中的数据,比如符合某一类条件的顶点,每一个资源包括 type、label、properties 三个要素,共有 18 种 type、
任意 label、任意 properties 的组合形成的资源,一个资源的内部条件是且关系,多个资源之间的条件是或关系。
资源接口包括:资源的创建、删除、修改和查询。
10.4.1 创建资源
Params
- target_name: 资源名称
- target_graph: 资源图
- target_url: 资源地址
- target_resources: 资源定义 (列表)
target_resources 可以包括多个 target_resource,以列表的形式存储。
每个 target_resource 包含:
- type:可选值 VERTEX, EDGE 等,可填 ALL,则表示可以是顶点或边;
- label:可选值,⼀个顶点或边类型的名称,可填*,则表示任意类型;
- properties:map 类型,可包含多个属性的键值对,必须匹配所有属性值,属性值⽀持填条件范围(age: P.gte(18)),properties 如果为 null 表示任意属性均可,如果属性名和属性值均为‘*ʼ也表示任意属性均可。
如精细资源:“target_resources”: [{“type”:“VERTEX”,“label”:“person”,“properties”:{“city”:“Beijing”,“age”:“P.gte(20)”}}]**
资源定义含义:类型是’person’的顶点,且城市属性是’Beijing’,年龄属性大于等于 20。
Request Body
Method & Url
Response Status
Response Body
10.4.2 删除资源
Params
- id: 需要删除的资源 Id
Method & Url
Response Status
10.4.3 修改资源
Params
- id: 需要修改的资源 Id
Method & Url
Request Body
修改资源定义中的 type
Response Status
Response Body
返回结果是包含修改过的内容在内的整个用户组对象
10.4.4 查询资源列表
Params
- limit: 返回结果条数的上限
Method & Url
Response Status
Response Body
10.4.5 查询某个资源
Params
- id: 需要查询的资源 Id
Method & Url
Response Status
Response Body
10.5 关联角色(Belong)API
关联用户和用户组的关系,一个用户可以关联一个或者多个用户组。用户组拥有相关资源的权限,不同用户组的资源权限可以理解为不同的角色。即给用户关联角色。
关联角色接口包括:用户关联角色的创建、删除、修改和查询。
下例沿用 10.3 的用户组 ID。实际调用时请换成自己创建响应中的 ID。后续操作使用 Belong 创建响应里的
id,并将 URL 路径中的>编码为%3E。
10.5.1 创建用户的关联角色
Params
- user: 用户 Id
- group: 用户组 Id
- belong_description: 描述
Request Body
Method & Url
Response Status
Response Body
10.5.2 删除关联角色
Params
- id: 需要删除的关联角色 Id
Method & Url
Response Status
10.5.3 修改关联角色
关联角色只能修改描述,不能修改 user 和 group 属性,如果需要修改关联角色,需要删除原来关联关系,新增关联角色。
Params
- id: 需要修改的关联角色 Id
Method & Url
Request Body
修改 belong_description
Response Status
Response Body
返回结果是包含修改过的内容在内的整个用户组对象
10.5.4 查询关联角色列表
Params
- user: 只返回该用户的关联关系
- group: 只返回该角色的关联关系
- limit: 返回结果条数的上限,默认为 100
user 和 group 不能同时使用。
Method & Url
Response Status
Response Body
10.5.5 查看某个关联角色
Params
- id: 需要查询的关联角色 Id
Method & Url
Response Status
Response Body
10.6 赋权(Access)API
给用户组赋予资源的权限,主要包含:读操作 (READ)、写操作 (WRITE)、删除操作 (DELETE)、执行操作 (EXECUTE) 等。
赋权接口包括:赋权的创建、删除、修改和查询。
下例使用 10.3 和 10.4 返回的用户组 ID、资源 ID。实际调用时请换成自己的响应值。后续操作使用 Access 创建响应里的
id,并将 URL 路径中的>编码为%3E。
10.6.1 创建赋权 (用户组赋予资源的权限)
Params
- group: 用户组 Id
- target: 资源 Id
- access_permission: 权限许可
- access_description: 赋权描述
access_permission:
- READ:读操作,所有的查询,包括查询 Schema、查顶点/边,查询顶点和边的数量 VERTEX_AGGR/EDGE_AGGR,也包括读图的状态 STATUS、变量 VAR、任务 TASK 等;
- WRITE:写操作,所有的创建、更新操作,包括给 Schema 增加 property key,给顶点增加或更新属性等;
- DELETE:删除操作,包括删除元数据、删除顶点/边;
- EXECUTE:执⾏操作,包括执⾏ Gremlin 语句、执⾏ Task、执⾏ metadata 函数;
Request Body
Method & Url
Response Status
Response Body
10.6.2 删除赋权
Params
- id: 需要删除的赋权 Id
Method & Url
Response Status
10.6.3 修改赋权
赋权只能修改描述,不能修改用户组、资源和权限许可,如果需要修改赋权的关系,可以删除原来的赋权关系,新增赋权。
Params
- id: 需要修改的赋权 Id
Method & Url
Request Body
修改 access_description
Response Status
Response Body
返回结果是包含修改过的内容在内的整个用户组对象
10.6.4 查询赋权列表
Params
- group: 只返回该角色的赋权记录
- target: 只返回该资源上的赋权记录
- limit: 返回结果条数的上限,默认为 100
group 和 target 不能同时使用。
Method & Url
Response Status
Response Body
10.6.5 查询某个赋权
Params
- id: 需要查询的赋权 Id
Method & Url
Response Status
Response Body
10.7 图空间管理员(Manager)API
重要提示:在使用以下 API 之前,需要先创建图空间(graphspace)。请参考 Graphspace API 创建名为 gs1 的图空间。文档中的示例均假设已存在名为 gs1 的图空间
重要提示:管理员相关接口只在 PD 模式下可用,单机模式下会返回 400 和 GraphSpace management is not supported in standalone mode 错误信息。
- 图空间管理员 API 用于在 graphspace 维度给用户授予/回收管理员角色,并查询当前用户或其他用户在该 graphspace 下的角色信息。角色类型可取
SPACE、SPACE_MEMBER、ADMIN。
10.7.1 检查当前登录用户是否拥有某个角色
Params
- type: 需要校验的角色类型,必填,取值为
SPACE、SPACE_MEMBER、ADMIN之一
Method & Url
Response Status
Response Body
10.7.2 查询图空间管理员列表
Params
- type: 角色类型,必填,取值为
SPACE、SPACE_MEMBER、ADMIN之一。SPACE返回图空间管理员,SPACE_MEMBER返回图空间成员,ADMIN返回整个集群的管理员
Method & Url
Response Status
Response Body
10.7.3 授权/创建图空间管理员
- 下面在 gs1 下,将用户 boss 授权为 SPACE_MEMBER 角色
Params
- user: 用户或角色名称,必填
- type: 角色类型,必填,取值为
SPACE、SPACE_MEMBER、ADMIN之一
把已经是图空间成员的用户授权为
SPACE时会先回收其成员角色,反之同理。只有管理员可以授予ADMIN。
Request Body
Method & Url
Response Status
Response Body
10.7.4 取消图空间管理员权限
- 下面在 gs1 下,将用户 boss 的 SPACE_MEMBER 角色删除
Params
- user: 需要删除的用户名称,内置的
admin用户不能从ADMIN中移除 - type: 需要删除的角色类型,取值为
SPACE、SPACE_MEMBER、ADMIN之一
Method & Url
Response Status
10.7.5 查询指定用户在图空间中的角色
Params
- user: 用户名称
Method & Url
Response Status
Response Body
返回的角色取自 ADMIN、SPACE、SPACE_MEMBER;用户在该图空间下不具备其中任何角色时返回 NONE。
10.7.6 检查当前登录用户是否拥有某个默认角色
默认角色是图空间的内置角色,参见 Graphspace API。role 的合法取值为 space、space_member、analyst 和 observer;graph 只在 role=observer 时生效。
Params
- role: 默认角色名称,必填
- graph: 图名称,选填,只在
role=observer时使用
Method & Url
Response Status
Response Body
10.8 登录(Login)API
除了 HTTP Basic 认证之外,服务还可以签发 JWT token,之后通过 Authorization: Bearer <token> 请求头携带。登录相关接口不带图空间前缀。
token 使用 auth.token_secret 配置项签名,有效期为 auth.token_expire 秒(默认 86400)。该密钥的默认值在启动时随机生成,因此当 token 需要在重启后继续有效、或者需要被多个服务节点接受时,必须显式配置该项。
10.8.1 登录并获取 token
Params
- user_name: 用户名称,必填
- user_password: 用户密码,必填
- token_expire: token 有效期(秒),选填
Request Body
Method & Url
Response Status
用户名或密码错误时返回 401。
Response Body
10.8.2 登出并使 token 失效
需要失效的 token 从请求头中获取,无需请求体。
Params
请求头说明:
- Authorization:
Bearer <token>,必填。只接受 Bearer 方式,其他方式返回400。
Method & Url
Response Status
token 非法或已过期时返回 401。
10.8.3 校验 token
Params
请求头说明:
- Authorization:
Bearer <token>,必填
Method & Url
Response Status
token 非法或已过期时返回 401。
Response Body
10.9 项目(Project)API
项目把一组图和一个管理员角色、一个操作员角色绑定在一起,从而可以一次性对这组图授权。创建项目时会同时生成它的 project_target、project_admin_group 和 project_op_group,这些字段会在响应中返回,但不能由客户端设置。
10.9.1 创建项目
Params
- project_name: 项目名称,必填
- project_description: 项目描述,选填
创建时不能传 project_graphs,请使用下面的 add_graph 操作。
Request Body
Method & Url
Response Status
Response Body
10.9.2 向项目中添加或移除图
Params
- id: 项目 Id
- action:
add_graph表示添加,remove_graph表示移除
Request Body
Method & Url
Response Status
Response Body
返回整个项目对象,其中包含更新后的图列表。
10.9.3 修改项目描述
Params
- id: 项目 Id
不传 action 时表示修改描述,此时请求体中不能带 project_graphs。
Request Body
Method & Url
Response Status
10.9.4 查询项目列表
Params
- limit: 返回结果条数的上限,默认为 100
Method & Url
Response Status
Response Body
10.9.5 查询某个项目
Params
- id: 项目 Id
Method & Url
Response Status
10.9.6 删除项目
Params
- id: 项目 Id
删除前需要先把项目中的图全部移除。
Method & Url
Response Status
1.18 - Metrics API
HugeGraph 提供了获取监控信息的 Metrics 接口,比如各个 Gremlin 执行时间的统计、缓存的占用大小等。Metrics 接口包括如下几类:基础指标、统计指标、系统指标、后端存储指标。
1. 基础指标
1.1 获取所有基础指标
Params
- type:如果传值为
json,则以 json 格式返回,否则以 Promethaus 格式返回。
1.1.1 Method & Url
Response Status
Response Body
1.1.2 Method & Url
Response Status
Response Body
1.2 获取 Gauges 指标
Method & Url
Response Status
Response Body
1.3 获取 Counters 指标
Method & Url
Response Status
Response Body
1.4 获取 histograms 指标
Method & Url
Response Status
Response Body
1.5 获取 meters 指标
Method & Url
Response Status
Response Body
1.6 获取 timers 指标
Method & Url
Response Status
Response Body
2.统计指标
Params
- type:如果传值为 json,则以 json 格式返回,否则以 Promethaus 格式返回。
2.1 Method & Url
Response Status
Response Body
2.2 Method & Url
Response Status
Response Body
3.系统指标
系统指标主要返回机器运行指标,如内存、线程等信息。
Method & Url
Response Status
Response Body
4.后端指标
hugeGraph 支持多种后端存储,后端指标包括内存、磁盘等信息。
Method & Url
Response Status
Response Body
1.19 - Other API
11.1 Other
11.1.1 查看HugeGraph的版本信息
Method & Url
Response Status
Response Body
11.1.2 查看服务的概要信息
返回服务名、内核版本、文档地址以及当前节点注册的 API 分组。
Method & Url
Response Status
Response Body
swagger_ui 由 restserver.url 拼接得到,apis 是当前节点注册的 API 分组,按名称排序。
11.1.3 列出服务的全部 API
按 API 分组和资源类列出所有已注册的接口方法,每条记录包含 url、HTTP 方法,以及查询参数的类型和默认值。
Method & Url
Response Status
Response Body
返回内容较长,下面的片段展示了它的结构:
11.1.4 查看和切换异常堆栈开关
服务返回的错误信息中是否带上 exception 和 cause 等异常堆栈字段,由 exception.allow_trace 配置项(默认 true)决定。下面的接口是一个节点级别的运行期覆盖开关:打开时无论配置项取值如何都会带上堆栈。GET 返回的是该覆盖开关的状态,初始为 false。
Method & Url
Response Status
Response Body
Method & Url
Request Body
Response Status
Response Body
11.1.5 管理 IP 白名单,该操作需要管理员权限
白名单只在开关打开时生效,参见 white_ip.status 配置项(默认 disable)。
查看白名单
Method & Url
Response Status
Response Body
向白名单添加或删除 IP
Params
- ips: IPv4 地址列表
- action:
load表示添加,remove表示删除
Method & Url
Request Body
Response Status
Response Body
existed_ips 是已经在白名单中的地址,added_ips 是新增的地址,illegal_ips 只在存在非法 IPv4 地址时返回。action=remove 时返回的是 removed_ips 和 non_existed_ips。
启用或关闭白名单
Params
- status:
true表示启用,false表示关闭
Method & Url
Response Status
Response Body
11.1.6 启动 Arthas 诊断代理
自 HugeGraph 1.8.0 起,Server 与 Store 发行包统一内置 Arthas 4.1.5(PD 未内置)。 可通过本地脚本或管理员 HTTP 接口挂载到正在运行的 JVM 进行在线诊断。
安全与访问控制说明
- 默认本地监听:Arthas 默认仅监听
127.0.0.1。若绑定通配地址(如0.0.0.0),请务必收紧网络防火墙并开启认证。 - 管理员权限限制:HTTP API 激活(
PUT /arthas)仅限已开启鉴权的管理员调用;未开启鉴权时直接返回403。 - Store 端点禁用:Store 服务的
GET /v1/arthasstart已禁用并返回403,统一推荐使用bin/arthas.sh。 - 免重启与自动清理:推荐在宿主机以服务属主身份直接运行
bin/arthas.sh,无需重启服务; 交互会话退出时脚本会自动卸载代理。
| 部署方式 | 推荐激活方式 | 权限与访问说明 |
|---|---|---|
| Server(已开启认证) | 管理员调用 PUT /arthas 或运行 bin/arthas.sh | 仅管理员账号可调用 HTTP 接口;本地脚本需服务 OS 用户权限 |
| Server(未开启认证) | 本地脚本 bin/arthas.sh | HTTP 接口直接返回 403(包括 loopback 与代理请求) |
| Store | 本地脚本 bin/arthas.sh | GET /v1/arthasstart 已禁用并返回 403 |
激活与使用方式
运维说明与安全配置
- 会话退出与清理:本地脚本会在退出时(输入
quit、stop或--command执行完成)自动停止 Arthas 代理并释放端口, 服务 JVM 保持运行。若仅通过 HTTP API 激活,会话结束后需显式执行stop彻底卸载代理。 - 用户认证与安全:对外暴露诊断端口前强烈建议启用原生认证。可通过脚本参数
--username/--password传递凭据, 或在服务 JVM 参数中设置-Darthas.username与-Darthas.password。 详细认证机制及安全配置请参考 Arthas 官方用户认证文档。 - 禁用高危命令:Server 可在
rest-server.properties中通过arthas.disabled_commands配置禁用命令列表 (以逗号分隔,如jad,mc)。请勿禁用session与stop,以便工具管理生命周期。 各命令详情请参见 Arthas 官方命令列表。
HTTP 响应体示例
成功激活后返回 HTTP 200 及生效配置:
2 - 客户端/SDK
HugeGraph 提供多语言客户端 SDK,方便在不同语言与技术栈中连接 HugeGraph Server,进行 Schema 管理、顶点与边数据读写、Gremlin 遍历及高级分析。
支持的客户端
官方核心 Java SDK,提供与 Gremlin 语法相近的 API 风格,支持完整的 Schema 管理、CRUD、Gremlin 查询及 Traverser 算法,并支持 GraphSpace 隔离。
官方 Python SDK(
pyhugegraph),位于 HugeGraph-AI 仓库,支持管理 Schema、读写图数据及提交 Gremlin 查询,深度集成 HugeGraph-LLM 与 HugeGraph-ML。官方 Go SDK,支持版本查询、Schema 定义(PropertyKey/VertexLabel/EdgeLabel)、顶点操作与 Gremlin 查询。
选择建议
- 生产级 Java/Scala 服务:推荐使用 HugeGraph Java Client,功能最完备,覆盖所有底层能力与连接池管理。
- AI/LLM/算法与数据科学应用:推荐使用 HugeGraph Python Client(
pyhugegraph),深度适配 HugeGraph-LLM、HugeGraph-ML 及 Python 数据科学分析工作流。 - 微服务与云原生工具构建:推荐使用 HugeGraph Go Client 或直接调用 RESTful API。
- 终端离线调试或临时查询:推荐使用 Gremlin Console。
2.1 - HugeGraph Java Client
1 HugeGraph-Client 概述
HugeGraph Java Client 将 Java API 转换为 HugeGraph Server 的 REST 请求,支持管理 Schema 和图数据、执行 Gremlin 及调用 Traverser API。本文涵盖 Java 项目的快速接入示例与全量核心 API 参考。
其他语言可使用 Go Client 或 Python Client。
2 环境要求
- JDK 17,用于本文示例及从 Toolchain
master构建 Client1.8.0 - Maven 3.6.3+
3 使用流程
按下面的顺序接入 HugeGraph-Client。
- 使用 IntelliJ IDEA 或 Eclipse 新建 Maven 工程。
- 在
pom.xml中添加 HugeGraph-Client 依赖。 - 创建客户端、调用 API,并在使用后关闭客户端。
详细操作见下面的完整示例。
4 完整示例
4.1 新建 Maven 工程
使用 Eclipse 或 IntelliJ IDEA 创建 Maven 工程。
4.2 添加 hugegraph-client 依赖
在 pom.xml 中添加依赖。
先根据用途选择客户端版本。
| 用途 | 客户端版本 | Java 编译目标 |
|---|---|---|
| 运行下方完整示例 | 已发布的 1.7.0,使用上面的依赖即可 | 发布版 POM 为 Java 8;本文统一使用 JDK 17 |
| 使用能力探测等 master 新接口 | Toolchain master(以 1.8 为基线) | Java 17 |
示例使用的 Schema、Graph、Gremlin 和资源关闭接口在 Client 1.7.0 中可用,也与 Toolchain master 兼容。
发布版的 Java 编译目标不代表所有传递依赖的运行环境要求。
若需要使用 master 分支未发布的新接口,可从源码编译安装 Client(需配合 Toolchain 源码,详见 Tools 源码构建指引):
两条版本检查都应显示 JDK 17。使用 master 分支 Client 的项目运行 Maven 命令时,也需添加 -Dmaven.repo.local="$candidate_dir/m2"。
Client 与 Server 的版本不必相同;升级前核对所需 API 及兼容范围。
4.3 Example
选择单条操作或批量操作示例,将完整代码保存为 Maven 工程中的 src/main/java/SingleExample.java 或
src/main/java/BatchExample.java。复制按钮会包含已折叠的代码行。
4.3.1 SingleExample
4.3.2 BatchExample
4.4 运行 Example
- 启动 HugeGraph Server,在图空间
DEFAULT中准备名为hugegraph的测试图。 - 将 Maven 工程的 JDK 设为 17,把所选示例中
HugeClient.builder(...)和configUser(...)的 Server 地址、图空间、图名和凭据改为实际配置。 Server 未开启鉴权时,省略configUser(...)。 - 在 IDE 中运行
SingleExample.main()或BatchExample.main()。两个示例都会创建 Schema 和图数据、打印结果并关闭客户端。 请使用测试图,已有 Schema 或数据可能影响重复运行。
本文的代码都是java语言写的,但其风格与gremlin(groovy)是非常类似的。用户只需要把代码中的变量声明替换成def或直接去掉,
就能将java代码转变为groovy;另外就是每一行语句最后可以不加分号,groovy认为一行就是一条语句。
用户在HugeGraph-Hubble中编写的gremlin(groovy)可以参考本文的java代码,下面会举出几个例子。
本文以 Toolchain master(Client 1.8.0)为准。请先按上方快速入门准备对应依赖;
能力探测等新增接口不能直接用于旧版 Client。
5 HugeClient 构造与操作入口
HugeGraph-Client 是操作 graph 的总入口,用户必须先创建出 HugeGraph-Client 对象,与 HugeGraph-Server 建立连接(伪连接)后,才能获取到 schema、graph 以及 gremlin 的操作入口对象。
HugeGraph-Client 连接服务端已有的图。构造器支持传入 GraphSpace;使用双参数构造器或传入空值时,GraphSpace 默认为 DEFAULT。
上述创建 HugeClient 的过程如果失败会抛出异常,用户需要 try-catch。如果成功则继续获取 schema、graph 以及 gremlin 的 manager。
在HugeGraph - Hubble中通过gremlin来操作时,不需要使用HugeClient,可以忽略。
5.1 构造器选项
构造器支持下列选项。所有超时参数的单位都是秒,内部会转换为毫秒。
| interface | description | default |
|---|---|---|
configUrl(String url) | 服务端地址,通常已经通过 builder(...) 传入 | 必填 |
configGraph(String graph) | 图名称,通常已经通过 builder(...) 传入 | 必填 |
configGraphSpace(String graphSpace) | GraphSpace 名称,传入 null 或空值时回退为 DEFAULT | DEFAULT |
configUser(String username, String password) | 服务端用户名和密码,传入 null 时按空字符串处理 | 空,不开启认证 |
configToken(String token) | 使用 Token 代替用户名和密码 | 空 |
configTimeout(int seconds) | 请求超时,建议使用正数秒值 | 20 |
configConnectTimeout(Integer seconds) | 连接超时,不设置时沿用 configTimeout | 未设置 |
configReadTimeout(Integer seconds) | 读取超时,不设置时沿用 configTimeout | 未设置 |
configPool(int maxConns, int maxConnsPerRoute) | 连接池大小,任意一项传入 0 时恢复其默认值 | 4 x CPU 数,2 x CPU 数 |
configIdleTime(int seconds) | 空闲连接保持时间,必须大于 0 | 30 |
configSSL(String trustStoreFile, String trustStorePassword) | HTTPS 连接使用的信任库 | 空 |
configHttpBuilder(Consumer<OkHttpClient.Builder> consumer) | 回调,用于进一步定制底层的 OkHttp 客户端 | 无 |
graphRequired(boolean graphRequired) | build() 是否拒绝空的 url 或图名称 | true |
当前 master 的 configTimeout(0) 存在单位换算缺陷,会得到 20,000 秒而非默认的 20 秒。
保持默认值时省略该调用,或显式使用 configTimeout(20);不要用 0 恢复默认值。
调用 build() 时,客户端会读取服务端的 API 版本,超出 [0.38, 0.81) 范围时报错。
5.2 操作入口
除 schema、graph 和 gremlin 外,HugeClient 还提供下列入口。图级别的入口只有在指定了图名称时才可用;如果创建客户端时图名称为空,这些入口会返回 null,直到调用 assignGraph(graphSpace, graph) 为止。
| interface | returns | scope | description |
|---|---|---|---|
schema() | SchemaManager | graph | 管理 PropertyKey、VertexLabel、EdgeLabel 和 IndexLabel |
graph() | GraphManager | graph | 单条或批量地增删改查顶点和边 |
gremlin() | GremlinManager | graph | 同步执行 Gremlin 语句,或作为异步任务提交 |
cypher() | CypherManager | graph | 同步执行 Cypher 语句,或作为异步任务提交 |
traverser() | TraverserManager | graph | RESTful 遍历,如最短路径、k-out、k-neighbor、交叉点等 |
variables() | VariablesManager | graph | 获取、设置、列出和删除图变量 |
job() | JobManager | graph | 重建 VertexLabel、EdgeLabel 或 IndexLabel 的索引 |
task() | TaskManager | graph | 列出、获取、取消、删除异步任务,或等待其完成 |
computer() | ComputerManager | graph | 创建、取消、列出和获取 computer 任务 |
graphs() | GraphsManager | graphspace | 创建、克隆、列出、重载、清空和删除图,读取和设置图的模式 |
graphSpace() | GraphSpaceManager | server | 管理 GraphSpace,详见第 8 节 |
auth() | AuthManager | server | 管理 user、group、target、belong 和 access |
metrics() | MetricsManager | server | 读取后端、系统和统计指标 |
versionManager() | VersionManager | server | 读取服务端的 core、gremlin 和 API 版本 |
客户端还会报告所连服务端支持的能力,调用方可以据此判断,而不必解析版本号:supportsGraphSpace()、supportsCypher()、supportsGraphCreate()、supportsDefaultRole() 和 isServerAuthEnabled()。
6 元数据管理 (SchemaManager)
6.1 SchemaManager
SchemaManager 用于管理 HugeGraph 中的四种元数据,分别是 PropertyKey(属性类型)、VertexLabel(顶点类型)、EdgeLabel(边类型)和 IndexLabel(索引标签)。在定义元数据信息之前必须先创建 SchemaManager 对象。
用户可使用如下方法获得 SchemaManager 对象:
在HugeGraph-Hubble中通过gremlin创建schema对象:
下面分别介绍四种元数据的定义过程。
6.2 PropertyKey
6.2.1 接口及参数介绍
PropertyKey 用来规范顶点和边的属性的约束,暂不支持定义属性的属性。
PropertyKey 允许定义的约束信息包括:name、datatype、cardinality、aggregateType、writeType、userdata,下面逐一介绍。
- name: 属性的名字,用来区分不同的 PropertyKey,不允许有同名的属性;
| interface | param | must set |
|---|---|---|
| propertyKey(String name) | name | y |
- datatype:属性值类型,必须从下表中选择符合具体业务场景的一项显式设置;
| interface | Java Class |
|---|---|
| asText() | String |
| asInt() | Integer |
| asDate() | Date |
| asUUID() | UUID |
| asBoolean() | Boolean |
| asByte() | Byte |
| asBlob() | Byte[] |
| asDouble() | Double |
| asFloat() | Float |
| asLong() | Long |
- cardinality:属性值是单值还是多值,多值的情况下又分为允许有重复值和不允许有重复值,该项默认为 single,如有必要可从下表中选择一项设置;
| interface | cardinality | description |
|---|---|---|
| valueSingle() | single | single value |
| valueList() | list | multi-values that allow duplicate value |
| valueSet() | set | multi-values that not allow duplicate value |
- aggregateType:同一属性被重复写入时的合并方式,默认为 none,即保留最后写入的值。数值类的选项要求属性为数字类型;
| interface | aggregateType | description |
|---|---|---|
| calcSum() | sum | 对写入的值累加 |
| calcMax() | max | 保留最大值 |
| calcMin() | min | 保留最小值 |
| calcOld() | old | 保留首次写入的值,忽略后续更新 |
aggregateType(AggregateType type) 可以直接设置该项,传入 AggregateType.NONE 即恢复默认。
- writeType:属性属于 OLTP 图数据还是 OLAP 计算结果,对于 OLAP 还区分是否带索引,默认为 oltp;
| writeType | description |
|---|---|
| OLTP | 普通图属性 |
| OLAP_COMMON | 不带索引的 OLAP 属性 |
| OLAP_SECONDARY | 带二级索引的 OLAP 属性 |
| OLAP_RANGE | 带范围索引的 OLAP 属性 |
| interface | description |
|---|---|
| writeType(WriteType writeType) | 使用枚举值设置写入类型 |
| writeType(String name) | 使用枚举名设置写入类型 |
- userdata:用户可以自己添加一些约束或额外信息,然后自行检查传入的属性是否满足约束,或者必要的时候提取出额外信息
| interface | description |
|---|---|
| userdata(String key, Object value) | The same key, the latter will cover the former |
6.2.2 创建 PropertyKey
在HugeGraph-Hubble中通过gremlin创建上述PropertyKey对象的语法完全一致,如果用户没有定义出schema变量,应该这样写:
以下的示例中,gremlin与java的语法完全一致,不再赘述。
- ifNotExist():为 create 添加判断机制,若当前 PropertyKey 已经存在则不再创建,否则创建该属性。若不添加判断,在 properkey 已存在的情况下会抛出异常信息,下同,不再赘述。
6.2.3 删除 PropertyKey
6.2.4 查询 PropertyKey
6.3 VertexLabel
6.3.1 接口及参数介绍
VertexLabel 用来定义顶点类型,描述顶点的约束信息:
VertexLabel 允许定义的约束信息包括:name、idStrategy、properties、primaryKeys、nullableKeys 和 ttl,下面逐一介绍。
- name: 属性的名字,用来区分不同的 VertexLabel,不允许有同名的属性;
| interface | param | must set |
|---|---|---|
| vertexLabel(String name) | name | y |
- idStrategy: 每一个 VertexLabel 都可以选择自己的 Id 策略,目前有三种策略供选择,即 Automatic(自动生成)、Customize(用户传入)和 PrimaryKey(主属性键)。其中 Automatic 使用 Snowflake 算法生成 Id,Customize 需要用户自行传入字符串或数字类型的 Id,PrimaryKey 则允许用户从 VertexLabel 的属性中选择若干主属性作为区分的依据,HugeGraph 内部会根据主属性的值拼接生成 Id。idStrategy 默认使用 Automatic 的,但如果用户没有显式设置 idStrategy 又调用了 primaryKeys(…) 方法设置了主属性,则 idStrategy 将自动使用 PrimaryKey;
| interface | idStrategy | description |
|---|---|---|
| useAutomaticId | AUTOMATIC | generate id automatically by Snowflake algorithm |
| useCustomizeStringId | CUSTOMIZE_STRING | passed id by user, must be string type |
| useCustomizeNumberId | CUSTOMIZE_NUMBER | passed id by user, must be number type |
| useCustomizeUuidId | CUSTOMIZE_UUID | passed id by user, must be UUID type |
| usePrimaryKeyId | PRIMARY_KEY | choose some important prop as primary key to splice id |
- properties: 定义顶点的属性,传入的参数是 PropertyKey 的 name
| interface | description |
|---|---|
| properties(String… properties) | allow to pass multi props |
- primaryKeys: 当用户选择了 PrimaryKey 的 Id 策略时,需要从 VertexLabel 的属性中选择若干主属性作为区分的依据;
| interface | description |
|---|---|
| primaryKeys(String… keys) | allow to choose multi prop as primaryKeys |
需要注意的是,Id 策略的选择与 primaryKeys 的设置有一些相互约束,不能随意调用,约束关系见下表:
| useAutomaticId | useCustomizeStringId | useCustomizeNumberId | usePrimaryKeyId | |
|---|---|---|---|---|
| unset primaryKeys | AUTOMATIC | CUSTOMIZE_STRING | CUSTOMIZE_NUMBER | ERROR |
| set primaryKeys | ERROR | ERROR | ERROR | PRIMARY_KEY |
客户端自身只校验 Id 策略是否被重复设置,因此在同一个构造器上调用两个上述方法会在本地报错。上表中的组合由服务端校验。
- nullableKeys: 对于通过 properties(…) 方法设置过的属性,默认全都是不可为空的,也就是在创建顶点时该属性必须赋值,这样可能对用户数据提出了太过严格的完整性要求。为避免这样的强约束,用户可以通过 本方法设置若干属性为可空的,这样添加顶点时该属性可以不赋值。
| interface | description |
|---|---|
| nullableKeys(String… properties) | allow to pass multi props |
注意:primaryKeys 和 nullableKeys 不能有交集,因为一个属性不能既作为主属性,又是可空的。
- ttl:该类型顶点的存活时间,默认为 0,即永不过期。客户端会拒绝负值。默认从顶点写入的时刻开始计时;设置 ttlStartTime 后,改为从该 label 的某个日期属性开始计时。
| interface | description |
|---|---|
| ttl(long ttl) | 设置存活时间,0 表示不过期 |
| ttlStartTime(String property) | 指定计时起点所用的日期属性 |
- enableLabelIndex:用户可以指定是否需要为 label 创建索引。不创建则无法全局搜索指定 label 的顶点和边,创建则可以全局搜索,做类似于
g.V().hasLabel('person'), g.E().has('label', 'person')这样的查询, 但是插入数据时性能上会更加慢,并且需要占用更多的存储空间。此项默认为 true。
| interface | description |
|---|---|
| enableLabelIndex(boolean enable) | Whether to create a label index |
- userdata:用户可以自己添加一些约束或额外信息,然后自行检查传入的属性是否满足约束,或者必要的时候提取出额外信息
| interface | description |
|---|---|
| userdata(String key, Object value) | The same key, the latter will cover the former |
6.3.2 创建 VertexLabel
6.3.3 追加 VertexLabel
VertexLabel 是可以追加约束的,不过仅限 properties 和 nullableKeys,而且追加的属性也必须添加到 nullableKeys 集合中。
6.3.4 删除 VertexLabel
6.3.5 查询 VertexLabel
6.4 EdgeLabel
6.4.1 接口及参数介绍
EdgeLabel 用来定义边类型,描述边的约束信息。
EdgeLabel 允许定义的约束信息包括:name、sourceLabel、targetLabel、frequency、properties、sortKeys、nullableKeys 和 ttl,下面逐一介绍。
- name: 属性的名字,用来区分不同的 EdgeLabel,不允许有同名的属性;
| interface | param | must set |
|---|---|---|
| edgeLabel(String name) | name | y |
sourceLabel 和 targetLabel: 边连接的源顶点类型名和目标顶点类型名,两者都设置等同于声明一组连接。
link: EdgeLabel 内部保存的是一组源顶点和目标顶点的组合,因此
link(...)可以多次调用,让同一种边连接多组顶点类型。一旦通过这种方式添加过组合,sourceLabel(...)和targetLabel(...)就会被拒绝;同时sourceLabel()和targetLabel()这两个取值方法只在恰好有一组组合时可用,需要读取全部组合时请使用links()。
| interface | param | must set |
|---|---|---|
| link(String sourceLabel, String targetLabel) | sourceLabel, targetLabel | y,或设置下面两项 |
| sourceLabel(String label) | label | y,除非已使用 link() |
| targetLabel(String label) | label | y,除非已使用 link() |
- frequency: 字面意思是频率,表示在两个具体的顶点间某个关系出现的次数,可以是单次(single)或多次(frequency),默认为 single;
| interface | frequency | description |
|---|---|---|
| singleTime() | single | a relationship can only occur once |
| multiTimes() | multiple | a relationship can occur many times |
- properties: 定义边的属性
| interface | description |
|---|---|
| properties(String… properties) | allow to pass multi props |
- sortKeys: 当 EdgeLabel 的 frequency 为 multiple 时,需要某些属性来区分这多次的关系,故引入了 sortKeys(排序键);
| interface | description |
|---|---|
| sortKeys(String… keys) | allow to choose multi prop as sortKeys |
- nullableKeys: 与顶点中的 nullableKeys 概念一致,不再赘述
注意:sortKeys 和 nullableKeys 也不能有交集。
ttl:与顶点中的 ttl 概念一致,同样提供
ttl(long ttl)和ttlStartTime(String property)方法,默认值同样为 0。edge label type:EdgeLabel 默认为普通类型,也可以声明为一族边类型的父类型、某个父类型的子类型,或者通用类型:
| interface | edgeLabelType | description |
|---|---|---|
| asBase() | PARENT | 将该 label 声明为父类型 |
| withBase(String parentLabel) | SUB | 将该 label 声明为 parentLabel 的子类型 |
| asGeneral() | GENERAL | 将该 label 声明为通用类型 |
enableLabelIndex:与顶点中的 enableLabelIndex 概念一致,不再赘述
userdata:用户可以自己添加一些约束或额外信息,然后自行检查传入的属性是否满足约束,或者必要的时候提取出额外信息
| interface | description |
|---|---|
| userdata(String key, Object value) | The same key, the latter will cover the former |
6.4.2 创建 EdgeLabel
6.4.3 追加 EdgeLabel
6.4.4 删除 EdgeLabel
6.4.5 查询 EdgeLabel
6.5 IndexLabel
6.5.1 接口及参数介绍
IndexLabel 用来定义索引类型,描述索引的约束信息,主要是为了方便查询。
IndexLabel 允许定义的约束信息包括:name、baseType、baseValue、indexFields、indexType,下面逐一介绍。
- name: 属性的名字,用来区分不同的 IndexLabel,不允许有同名的属性;
| interface | param | must set |
|---|---|---|
| indexLabel(String name) | name | y |
baseType: 表示要为 VertexLabel 还是 EdgeLabel 建立索引, 与下面的 baseValue 配合使用;
baseValue: 指定要建立索引的 VertexLabel 或 EdgeLabel 的名称;
| interface | param | description |
|---|---|---|
| onV(String baseValue) | baseValue | build index for VertexLabel: ‘baseValue’ |
| onE(String baseValue) | baseValue | build index for EdgeLabel: ‘baseValue’ |
- indexFields: 要在哪些属性上建立索引,可以是为多列建立联合索引;
| interface | param | description |
|---|---|---|
| by(String… fields) | files | allow to build index for multi fields for secondary index |
- indexType: 建立的索引类型,目前支持五种,即 Secondary、Range、Search、Shard 和 Unique。
- Secondary 支持精确匹配的二级索引,允许建立联合索引,联合索引支持索引前缀搜索
- 单个属性,支持相等查询,比如:person 顶点的 city 属性的二级索引,可以用
g.V().has("city", "北京")查询"city 属性值是北京"的全部顶点 - 联合索引,支持前缀查询和相等查询,比如:person 顶点的 city 和 street 属性的联合索引,可以用
g.V().has ("city", "北京").has('street', '中关村街道')查询"city属性值是北京且street属性值是中关村"的全部顶点,或者g.V() .has("city", "北京")查询"city 属性值是北京"的全部顶点
secondary index 的查询都是基于"是"或者"相等"的查询条件,不支持"部分匹配"
- 单个属性,支持相等查询,比如:person 顶点的 city 属性的二级索引,可以用
- Range 支持数值类型的范围查询
- 必须是单个数字或者日期属性,比如:person 顶点的 age 属性的范围索引,可以用
g.V().has("age", P.gt(18))查询"age属性值大于18"的顶点。除了P.gt()以外,还支持P.gte(),P.lte(),P.lt(),P.eq(),P.between(),P.inside()和P.outside()等
- 必须是单个数字或者日期属性,比如:person 顶点的 age 属性的范围索引,可以用
- Search 支持全文检索的索引
- 必须是单个文本属性,比如:person 顶点的 address 属性的全文索引,可以用
g.V().has("address", Text .contains('大厦')查询"address 属性中包含大厦"的全部顶点
search index 的查询是基于"是"或者"包含"的查询条件
- 必须是单个文本属性,比如:person 顶点的 address 属性的全文索引,可以用
- Shard 支持前缀匹配 + 数字范围查询的索引
- N 个属性的分片索引,支持前缀相等情况下的范围查询,比如:person 顶点的 city 和 age 属性的分片索引,可以用
g.V().has ("city", "北京").has("age", P.between(18, 30))查询"city 属性是北京且年龄大于等于 18 小于 30"的全部顶点 - shard index N 个属性全是文本属性时,等价于 secondary index
- shard index 只有单个数字或者日期属性时,等价于 range index
shard index 可以有任意数字或者日期属性,但是查询时最多只能提供一个范围查找条件,且该范围查找条件的属性的前缀属性都是相等查询条件
- N 个属性的分片索引,支持前缀相等情况下的范围查询,比如:person 顶点的 city 和 age 属性的分片索引,可以用
- Unique 支持属性值唯一性约束,即可以限定属性的值不重复,允许联合索引,但不支持查询
- 单个或者多个属性的唯一性索引,不可用来查询,只可对属性的值进行限定,当出现重复值时将报错
- Secondary 支持精确匹配的二级索引,允许建立联合索引,联合索引支持索引前缀搜索
| interface | indexType | description |
|---|---|---|
| secondary() | Secondary | support prefix search |
| range() | Range | support range(numeric or date type) search |
| search() | Search | support full text search |
| shard() | Shard | support prefix + range(numeric or date type) search |
| unique() | Unique | support unique props value, not support search |
6.5.2 创建 IndexLabel
以下示例假定已创建带 name、age 的 person 顶点类型,以及带 date 的 created 边类型。
先补充索引所需属性;id 是业务属性,与顶点的内部 ID 不同。
6.5.3 删除 IndexLabel
6.5.4 查询 IndexLabel
7 图数据操作 (GraphManager)
7.1 Vertex
顶点是构成图的最基本元素,一个图中可以有非常多的顶点。下面给出一个添加顶点的例子:
- 添加顶点的关键是顶点属性,添加顶点函数的参数个数必须为偶数,且满足
key1 -> val1, key2 -> val2 ···的顺序排列,键值对之间的顺序是自由的。 - 参数中必须包含一对特殊的键值对,就是
T.LABEL -> "val",用来定义该顶点的类别,以便于程序从缓存或后端获取到该 VertexLabel 的 schema 定义,然后做后续的约束检查。例子中的 label 定义为 person。T.LABEL就是常量"label",直接传入该字符串效果相同。 - 如果顶点类型的 Id 策略为
AUTOMATIC,则不允许用户传入 id 键值对。 - 如果顶点类型的 Id 策略为
CUSTOMIZE_STRING,则用户需要自己传入 String 类型 id 的值,键值对形如:T.ID, "123456"。 - 如果顶点类型的 Id 策略为
CUSTOMIZE_NUMBER,则用户需要自己传入 Number 类型 id 的值,键值对形如:T.ID, 123456。 - 如果顶点类型的 Id 策略为
PRIMARY_KEY,参数还必须全部包含该primaryKeys对应属性的名和值,如果不设置会抛出异常。比如之前person的primaryKeys是name,例子中就设置了name的值为marko。 - 对于非 nullableKeys 的属性,必须要赋值。
- 剩下的参数就是顶点其他属性的设置,但并非必须。
- 调用
addVertex方法后,顶点会立刻被插入到后端存储系统中。
7.2 Edge
有了点,还需要边才能构成完整的图。下面给出一个添加边的例子:
- 由(源)顶点来调用添加边的函数,函数第一个参数为边的 label,第二个参数是目标顶点,这两个参数的位置和顺序是固定的。后续的参数就是
key1 -> val1, key2 -> val2 ···的顺序排列,设置边的属性,键值对顺序自由。 - 源顶点和目标顶点必须符合 EdgeLabel 中 source-label 和 target-label 的定义,不能随意添加。
- 对于非 nullableKeys 的属性,必须要赋值。
注意:当 frequency 为 multiple 时必须要设置 sortKeys 对应属性类型的值。
8 图空间管理 (GraphSpace)
Client 支持管理一个物理部署中的多个 GraphSpace,每个 GraphSpace 可以包含多个图。不指定 GraphSpace 时使用 DEFAULT。
GraphSpace 需要服务端 core 版本不低于 1.7.0。连接更早的服务端时,客户端会退回到 legacy 模式,此时 hugeClient.supportsGraphSpace() 返回 false。
8.1 创建GraphSpace
8.2 GraphSpace 接口汇总
| 类别 | 接口 | 描述 |
|---|---|---|
| Manager - 查询 | listGraphSpace() | 获取所有 GraphSpace 名称 |
| listProfile() / listProfile(String prefix) | 获取 GraphSpace 概要 | |
| getGraphSpace(String name) | 获取指定 GraphSpace | |
| getDefault() | 获取默认 GraphSpace | |
| Manager - 创建/更新 | createGraphSpace(GraphSpace) | 创建 GraphSpace |
| updateGraphSpace(GraphSpace) | 更新配置 | |
| setDefault(String name) | 设置默认 GraphSpace | |
| Manager - 删除 | deleteGraphSpace(String name) | 删除指定 GraphSpace |
| Manager - 默认角色 | setDefaultRole(String name, String user, String role) | 授予默认角色,可用第四个参数限定到某个图 |
| checkDefaultRole(String name, String user, String role) | 检查默认角色,可用第四个参数限定到某个图 | |
| deleteDefaultRole(String name, String user, String role) | 撤销默认角色,可用第四个参数限定到某个图 | |
| GraphSpace - 属性 | getName() / getNickname() / getDescription() | 获取名称/昵称/描述 |
| getGraphNumberUsed() / getRoleNumberUsed() | 获取已使用的图数量/角色数量 | |
| getCpuUsed() / getMemoryUsed() / getStorageUsed() | 获取已使用的资源 | |
| getCreateTime() / getUpdateTime() | 获取创建时间/更新时间 | |
| GraphSpace - 配置 | setDescription(String) / setNickname(String) | 设置描述/昵称 |
| setMaxGraphNumber(int) / setMaxRoleNumber(int) | 设置最大图数量/角色数量 | |
| setCpuLimit(int) / setMemoryLimit(int) / setStorageLimit(int) | 设置资源配额 | |
| setConfigs(Map<String, Object>) | 设置额外的配置项 |
2.2 - HugeGraph Python 客户端快速上手
hugegraph-python-client 是 Apache HugeGraph 的 Python SDK。它支持管理 Schema、读写图数据、执行 Gremlin 查询、进行 OLTP 实时图遍历以及
提交异步 OLAP 全图计算任务。HugeGraph-LLM 和 HugeGraph-ML 也依赖该客户端进行图数据库交互。
客户端源码位于 hugegraph-ai 仓库的 hugegraph-python-client/ 目录下,导入包名为 pyhugegraph。
环境要求
- Python >= 3.12(支持 Python 3.12–3.14)。
- HugeGraph Server 1.5.0 或更高版本(Server 1.7+ 推荐开启 GraphSpace 模式;1.5/1.6 使用传统路由)。
pip或uv包管理器。
运行时依赖包括 decorator、requests、urllib3 和 rich。
安装
客户端提供两种安装方式,具体取决于使用的是 PyPI 稳定发行版还是 master 分支最新的开发功能。
版本与功能边界说明:
已发布的 PyPI 发行包(hugegraph-python 1.7.x)为稳定基础版本,以 CamelCase 命名风格为主(带旧版 snake_case 别名)。
本文档演示的现代特性——包括原生 snake_case API、client.olap() 全图计算算法、client.task().wait() 任务轮询等待、
client.close() 连接生命周期管理以及更新后的遍历器签名——均对齐 master 分支最新实现。
如需体验或测试这些新特性,请通过源码方式安装客户端。
连接与数据写入
客户端初始化参数
PyHugeClient(url, graph, user, pwd, graphspace=None, timeout=None, *, token=None)
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
url | str | 必填 | HugeGraph Server 基础地址。若未携带协议前缀,会自动补齐 http://(例如 127.0.0.1:8080)。 |
graph | str | 必填 | 目标图实例名称,为第二个位置参数。 |
user | str | 必填 | 用户名,用于 HTTP Basic Auth 认证。 |
pwd | str | 必填 | 密码,用于 HTTP Basic Auth 认证。 |
graphspace | str 或 None | None | GraphSpace 名称。为 None 时通过版本探测自动决定路由。 |
timeout | float、tuple[float, float] 或 None | None | (connect, read) 超时秒数,或统一指定单个浮点数。默认值为 (0.5, 15.0)。 |
token | str 或 None | None | 显式指定 Bearer Token;提供时优先覆盖 Basic Auth 认证。 |
对于幂等请求,在收到 500、502、504 错误响应时最多重试 3 次(退避系数为 0.1)。异步任务轮询等待期间会自动管理截止时间预算,不额外触发重定向或 HTTP 重试。
服务端版本与 GraphSpace 路由
客户端在初始化阶段自动解析 GraphSpace 路由:
- 显式传入非空
graphspace时,直接启用对应的 GraphSpace 路由模式。 graphspace=None时,客户端向GET {url}/versions发起探测以获取服务端内核版本。- HugeGraph Server 1.7+ 默认启用 GraphSpace 并分配至
DEFAULT。 - HugeGraph Server 1.5 / 1.6 保持传统无 GraphSpace 路由。
- 低于 1.5.0 的版本不支持,初始化时会抛出
RuntimeError。 - 若版本探测失败且未显式指定 GraphSpace,客户端初始化将直接抛出异常,避免错误猜测服务端路由结构。
路由模式决定了服务端请求路径前缀:开启 GraphSpace 时为 /graphspaces/<graphspace>/graphs/<graph>/...,关闭时为 /graphs/<graph>/...。
客户端入口概览
PyHugeClient 实例维护全局共享的 HTTP Session。所有管理器均采用延迟加载并缓存复用:
| 访问入口 | 管理器类 | 功能范围 |
|---|---|---|
client.schema() | SchemaManager | 属性类型、顶点类型、边类型、索引类型管理 |
client.graph() | GraphManager | 顶点与边增删改查、批量写入、条件分页查询 |
client.gremlin() | GremlinManager | 执行 Gremlin 查询语句 |
client.traverser() | TraverserManager | 实时图遍历与路径查询(OLTP) |
client.rank() | RankManager | 实时个性化推荐排序(OLTP) |
client.olap() | OlapManager | 异步全图计算算法作业(OLAP) |
client.task() | TaskManager | 异步任务状态查询、结果轮询等待、任务取消与删除 |
client.graphs() | GraphsManager | 图元数据查看、配置导出、图列表、清空全图数据 |
client.graphspaces() | GraphspaceManager | 多图空间(GraphSpace)生命周期管理 |
client.schema_templates() | SchemaTemplateManager | 可复用 Schema 模板管理 |
client.auth() | AuthManager | 用户、用户组、目标资源、所属关系与权限管理 |
client.variable() | VariableManager | 图级别持久化键值变量 |
client.metrics() | MetricsManager | 服务端监控指标数据采集 |
client.version() | VersionManager | 服务端及各组件版本信息 |
client.rest() | RestClient | 底层 REST API 直接调用及扩展端点 |
常用操作
定义 Schema
Schema 构造器采用链式调用。调用 create() 执行创建,或使用 append()、eliminate()、remove() 修改已有定义:
查询 Schema
增删改查图数据
图数据 API 直接接收 Python 属性字典:
add_vertex 返回包含 id、label、type 与 properties 的 VertexData 实例。
add_edge 返回包含 id、label、type、outV、outVLabel、inV、inVLabel 与 properties 的 EdgeData 实例。
传入客户端的顶点 ID 可以是字符串、整数或 uuid.UUID 对象。布尔类型会被拦截拒绝,整数必须位于 Java 64 位有符号整型范围内。
批量导入数据
add_vertices 接收 (label, properties) 元组列表,add_edges 接收 (label, out_id, in_id, out_label, in_label, properties) 元组列表:
分页与条件查询
执行 Gremlin 查询
exec() 会根据图实例名称及解析出的 GraphSpace 自动绑定 graph 与 g 别名,并解析返回服务端响应中的 result 数据内容。
实时图遍历(OLTP)
client.traverser() 封装了服务端实时图遍历接口,支持多跳邻居、最短路径、共同邻居与相似度计算:
POST 方式的遍历接口支持复杂请求体:advanced_paths、customized_paths、template_paths、customized_crosspoints 以及 fusiform_similarity。
OLAP 全图计算任务
对于全图级别的重型计算算法(如 PageRank、Louvain 社区发现、中心度计算等),请使用 client.olap()。这些作业在服务端以异步任务方式运行并通过 Task ID 进行跟踪管理:
支持的 OLAP 算法
服务端提供了 17 个唯一的全图计算算法名称:
| 算法类别 | 具体算法名称 |
|---|---|
| 图统计 | count_edge、count_vertex、subgraph_stat、triangle_count、rings |
| 中心度 | betweenness_centrality、closeness_centrality、degree_centrality、eigenvector_centrality、stress_centrality |
| 社区与聚类 | cluster_coefficient、k_core、louvain、lpa、weak_connected_component |
| 排序与相似度 | page_rank、fusiform_similarity |
类似 page_rank 的算法会将计算出的权重属性回写到图中。在要求显式 Schema 声明的环境中,执行 PageRank 前需在参与计算的顶点类型上提前声明名为 r_rank 的可空 DOUBLE 属性。
任务生命周期管理
TaskManager 提供了对异步任务的完整管控能力:
wait(id, timeout=300, poll_interval=1)轮询期间仅查询任务状态而不拉取大体积结果,完成后再统一获取最终产出。TaskTimeoutError仅代表客户端轮询等待超时,服务端后台运行的任务作业不会被终止。- 如需强行终止服务端任务,请显式调用
cancel_task(id)。
图变量、监控与元数据
认证与权限控制
PyHugeClient 同时支持 HTTP Basic Auth 与 Bearer Token 认证:
AuthManager 支持在 GraphSpace 隔离下管理用户、用户组、目标资源、所属关系以及操作权限:
方法命名规范与迁移说明
- 推荐规范:新代码请统一使用
snake_case方法名(如add_vertex、property_key等)。 - 兼容保证:现有的公开 CamelCase 方法(如
addVertex、propertyKey等)作为直接别名持续得到兼容支持。 - 客户端生命周期:结束调用后请统一通过
client.close()释放连接池会话资源,无需单独关闭单个 manager。 - 返回契约:
- 传统快捷接口
get_all_graphs()、get_version()和get_graph_info()保持返回 JSON 字符串以维护向前兼容。 - 标准现代接口
client.graphs().list()、client.version().version()和client.graphs().get(graph_name)直接返回已解析的 Python 字典。 - 带权最短路径与单源最短路径方法不再支持
max_depth参数(服务端接口不支持);请使用capacity、max_degree和skip_degree参数进行限制。
- 传统快捷接口
底层 REST API 直接调用
对于批量原生接口调用或高级管理器尚未封装的扩展接口,可通过 client.rest() 直接访问完整 REST 接口面:
下表列出与服务端完全对齐的 194 个底层 REST 端点:
| Python REST entry | Method | Path | Query parameters |
|---|---|---|---|
rest.access.create() | POST | /graphspaces/{graphspace}/auth/accesses | — |
rest.access.delete() | DELETE | /graphspaces/{graphspace}/auth/accesses/{id} | — |
rest.access.get() | GET | /graphspaces/{graphspace}/auth/accesses/{id} | — |
rest.access.list() | GET | /graphspaces/{graphspace}/auth/accesses | group, target, limit |
rest.access.update() | PUT | /graphspaces/{graphspace}/auth/accesses/{id} | — |
rest.adamic_adar.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/adamicadar | vertex, other, direction, label, max_degree, limit |
rest.algorithm.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/jobs/algorithm/{name} | — |
rest.all_shortest_paths.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/allshortestpaths | source, target, direction, label, max_depth, max_degree, skip_degree, with_vertex, with_edge, capacity |
rest.arthas.start_arthas() | PUT | /arthas | — |
rest.belong.create() | POST | /graphspaces/{graphspace}/auth/belongs | — |
rest.belong.delete() | DELETE | /graphspaces/{graphspace}/auth/belongs/{id} | — |
rest.belong.get() | GET | /graphspaces/{graphspace}/auth/belongs/{id} | — |
rest.belong.list() | GET | /graphspaces/{graphspace}/auth/belongs | user, group, limit |
rest.belong.update() | PUT | /graphspaces/{graphspace}/auth/belongs/{id} | — |
rest.computer.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/jobs/computer/{name} | — |
rest.count.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/count | — |
rest.crosspoints.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/crosspoints | source, target, direction, label, max_depth, max_degree, capacity, limit |
rest.customized_crosspoints.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/customizedcrosspoints | — |
rest.customized_paths.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/customizedpaths | — |
rest.cypher.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/cypher | — |
rest.cypher.query() | GET | /graphspaces/{graphspace}/graphs/{graph}/cypher | cypher |
rest.edge.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/graph/edges | — |
rest.edge.create_batch() | POST | /graphspaces/{graphspace}/graphs/{graph}/graph/edges/batch | check_vertex |
rest.edge.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/graph/edges/{id} | label |
rest.edge.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/graph/edges/{id} | — |
rest.edge.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/graph/edges | vertex_id, direction, label, properties, keep_start_p, offset, page, limit |
rest.edge.update_batch() | PUT | /graphspaces/{graphspace}/graphs/{graph}/graph/edges/batch | — |
rest.edge.update_by_id() | PUT | /graphspaces/{graphspace}/graphs/{graph}/graph/edges/{id} | action |
rest.edge_existence.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/edgeexist | source, target, label, sort_values, limit |
rest.edge_label.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/schema/edgelabels | — |
rest.edge_label.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/schema/edgelabels/{name} | — |
rest.edge_label.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/edgelabels/{name} | — |
rest.edge_label.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/edgelabels | names |
rest.edge_label.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/schema/edgelabels/{name} | action |
rest.edges.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/edges | ids |
rest.edges.scan() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/edges/scan | start, end, page, page_limit |
rest.edges.shards() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/edges/shards | split_size |
rest.exception_trace.get() | GET | /exception/trace | — |
rest.exception_trace.trace() | PUT | /exception/trace | — |
rest.fusiform_similarity.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/fusiformsimilarity | — |
rest.graph_space.check_default_role() | GET | /graphspaces/{graphspace}/role | user, role, graph |
rest.graph_space.create() | POST | /graphspaces | — |
rest.graph_space.delete() | DELETE | /graphspaces/{name} | — |
rest.graph_space.delete_default_role() | DELETE | /graphspaces/{graphspace}/role | user, role, graph |
rest.graph_space.get() | GET | /graphspaces/{graphspace} | — |
rest.graph_space.list() | GET | /graphspaces | — |
rest.graph_space.list_profile() | GET | /graphspaces/profile | prefix |
rest.graph_space.manage() | PUT | /graphspaces/{name} | — |
rest.graph_space.set_default_role() | POST | /graphspaces/{graphspace}/role | — |
rest.graph_space_group.create() | POST | /graphspaces/{graphspace}/auth/groups | — |
rest.graph_space_group.delete() | DELETE | /graphspaces/{graphspace}/auth/groups/{id} | — |
rest.graph_space_group.get() | GET | /graphspaces/{graphspace}/auth/groups/{id} | — |
rest.graph_space_group.list() | GET | /graphspaces/{graphspace}/auth/groups | limit |
rest.graph_space_group.update() | PUT | /graphspaces/{graphspace}/auth/groups/{id} | — |
rest.graphs.clear() | DELETE | /graphspaces/{graphspace}/graphs/{name}/clear | confirm_message |
rest.graphs.clone_schema() | POST | /graphspaces/{graphspace}/graphs/{name}/schema-clone | source |
rest.graphs.compact() | PUT | /graphspaces/{graphspace}/graphs/{name}/compact | — |
rest.graphs.create() | POST | /graphspaces/{graphspace}/graphs/{name} | clone_graph_name |
rest.graphs.create_by_text() | POST | /graphspaces/{graphspace}/graphs/{name} | clone_graph_name |
rest.graphs.create_snapshot() | PUT | /graphspaces/{graphspace}/graphs/{name}/snapshot_create | — |
rest.graphs.drop() | DELETE | /graphspaces/{graphspace}/graphs/{name} | confirm_message |
rest.graphs.get() | GET | /graphspaces/{graphspace}/graphs/{name} | — |
rest.graphs.get_conf() | GET | /graphspaces/{graphspace}/graphs/{name}/conf | — |
rest.graphs.get_default() | GET | /graphspaces/{graphspace}/graphs/default | — |
rest.graphs.graph_read_mode_get() | GET | /graphspaces/{graphspace}/graphs/{name}/graph_read_mode | — |
rest.graphs.graph_read_mode_set() | PUT | /graphspaces/{graphspace}/graphs/{name}/graph_read_mode | — |
rest.graphs.list() | GET | /graphspaces/{graphspace}/graphs | — |
rest.graphs.list_profile() | GET | /graphspaces/{graphspace}/graphs/profile | prefix |
rest.graphs.loading_mode_get() | GET | /graphspaces/{graphspace}/graphs/{name}/mode/owners | — |
rest.graphs.loading_mode_set() | PUT | /graphspaces/{graphspace}/graphs/{name}/mode/owners | — |
rest.graphs.manage() | PUT | /graphspaces/{graphspace}/graphs/{name} | — |
rest.graphs.mode_get() | GET | /graphspaces/{graphspace}/graphs/{name}/mode | — |
rest.graphs.mode_set() | PUT | /graphspaces/{graphspace}/graphs/{name}/mode | — |
rest.graphs.reload() | PUT | /graphspaces/{graphspace}/graphs/manage | — |
rest.graphs.resume_snapshot() | PUT | /graphspaces/{graphspace}/graphs/{name}/snapshot_resume | — |
rest.graphs.set_default() | POST | /graphspaces/{graphspace}/graphs/{name}/default | — |
rest.graphs.unset_default() | DELETE | /graphspaces/{graphspace}/graphs/{name}/default | — |
rest.gremlin.get() | GET | /gremlin | gremlin, language; additional query map |
rest.gremlin.post() | POST | /gremlin | — |
rest.gremlin_job.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/jobs/gremlin | — |
rest.group.create() | POST | /auth/groups | — |
rest.group.delete() | DELETE | /auth/groups/{id} | — |
rest.group.get() | GET | /auth/groups/{id} | — |
rest.group.list() | GET | /auth/groups | limit |
rest.group.update() | PUT | /auth/groups/{id} | — |
rest.index_label.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/schema/indexlabels | — |
rest.index_label.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/schema/indexlabels/{name} | — |
rest.index_label.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/indexlabels/{name} | — |
rest.index_label.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/indexlabels | names |
rest.index_label.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/schema/indexlabels/{name} | action |
rest.jaccard_similarity.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/jaccardsimilarity | vertex, other, direction, label, max_degree |
rest.jaccard_similarity.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/jaccardsimilarity | — |
rest.kneighbor.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/kneighbor | source, direction, label, max_depth, count_only, max_degree, limit |
rest.kneighbor.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/kneighbor | — |
rest.kout.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/kout | source, direction, label, max_depth, nearest, count_only, max_degree, capacity, limit |
rest.kout.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/kout | — |
rest.login.login() | POST | /auth/login | — |
rest.login.logout() | DELETE | /auth/logout | — |
rest.login.verify_token() | GET | /auth/verify | — |
rest.manager.check_default_role() | GET | /graphspaces/{graphspace}/auth/managers/default | role, graph |
rest.manager.check_role() | GET | /graphspaces/{graphspace}/auth/managers/check | type |
rest.manager.create_manager() | POST | /graphspaces/{graphspace}/auth/managers | — |
rest.manager.delete() | DELETE | /graphspaces/{graphspace}/auth/managers | user, type |
rest.manager.get_roles_in_gs() | GET | /graphspaces/{graphspace}/auth/managers/role | user |
rest.manager.list() | GET | /graphspaces/{graphspace}/auth/managers | type |
rest.metrics.all() | GET | /metrics | type |
rest.metrics.backend() | GET | /metrics/backend | — |
rest.metrics.counters() | GET | /metrics/counters | — |
rest.metrics.gauges() | GET | /metrics/gauges | — |
rest.metrics.histograms() | GET | /metrics/histograms | — |
rest.metrics.meters() | GET | /metrics/meters | — |
rest.metrics.statistics() | GET | /metrics/statistics | type |
rest.metrics.system() | GET | /metrics/system | — |
rest.metrics.timers() | GET | /metrics/timers | — |
rest.multi_node_shortest_path.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/multinodeshortestpath | — |
rest.neighbor_rank.neighbor_rank() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/neighborrank | — |
rest.paths.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/paths | source, target, direction, label, max_depth, max_degree, capacity, limit |
rest.paths.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/paths | — |
rest.personal_rank.personal_rank() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/personalrank | — |
rest.profile.get_profile() | GET | / | — |
rest.profile.show_all_apis() | GET | /apis | — |
rest.project.create() | POST | /graphspaces/{graphspace}/auth/projects | — |
rest.project.delete() | DELETE | /graphspaces/{graphspace}/auth/projects/{id} | — |
rest.project.get() | GET | /graphspaces/{graphspace}/auth/projects/{id} | — |
rest.project.list() | GET | /graphspaces/{graphspace}/auth/projects | limit |
rest.project.update() | PUT | /graphspaces/{graphspace}/auth/projects/{id} | action |
rest.property_key.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/schema/propertykeys | — |
rest.property_key.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/schema/propertykeys/{name} | — |
rest.property_key.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/propertykeys/{name} | — |
rest.property_key.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/propertykeys | names |
rest.property_key.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/schema/propertykeys/{name} | action |
rest.raft.add_peer() | POST | /graphspaces/{graphspace}/graphs/{graph}/raft/add_peer | group, endpoint |
rest.raft.get_leader() | GET | /graphspaces/{graphspace}/graphs/{graph}/raft/get_leader | group |
rest.raft.list_peers() | GET | /graphspaces/{graphspace}/graphs/{graph}/raft/list_peers | group |
rest.raft.remove_peer() | POST | /graphspaces/{graphspace}/graphs/{graph}/raft/remove_peer | group, endpoint |
rest.raft.set_leader() | POST | /graphspaces/{graphspace}/graphs/{graph}/raft/set_leader | group, endpoint |
rest.raft.transfer_leader() | POST | /graphspaces/{graphspace}/graphs/{graph}/raft/transfer_leader | group, endpoint |
rest.rays.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/rays | source, direction, label, max_depth, max_degree, capacity, limit, with_vertex, with_edge |
rest.rebuild.edge_label_rebuild() | PUT | /graphspaces/{graphspace}/graphs/{graph}/jobs/rebuild/edgelabels/{name} | — |
rest.rebuild.index_label_rebuild() | PUT | /graphspaces/{graphspace}/graphs/{graph}/jobs/rebuild/indexlabels/{name} | — |
rest.rebuild.vertex_label_rebuild() | PUT | /graphspaces/{graphspace}/graphs/{graph}/jobs/rebuild/vertexlabels/{name} | — |
rest.resource_allocation.create() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/resourceallocation | vertex, other, direction, label, max_degree, limit |
rest.rings.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/rings | source, direction, label, max_depth, source_in_ring, max_degree, capacity, limit, with_vertex, with_edge |
rest.same_neighbors.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/sameneighbors | vertex, other, direction, label, max_degree, limit |
rest.same_neighbors.same_neighbors() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/sameneighbors | — |
rest.same_neighbors_batch.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/sameneighborsbatch | — |
rest.schema.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema | — |
rest.schema_template.create() | POST | /graphspaces/{graphspace}/schematemplates | — |
rest.schema_template.delete() | DELETE | /graphspaces/{graphspace}/schematemplates/{name} | — |
rest.schema_template.get() | GET | /graphspaces/{graphspace}/schematemplates/{name} | — |
rest.schema_template.list() | GET | /graphspaces/{graphspace}/schematemplates | — |
rest.schema_template.update() | PUT | /graphspaces/{graphspace}/schematemplates/{name} | — |
rest.shortest_path.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/shortestpath | source, target, direction, label, max_depth, max_degree, skip_degree, with_vertex, with_edge, capacity |
rest.single_source_shortest_path.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/singlesourceshortestpath | source, direction, label, weight, max_degree, skip_degree, with_vertex, with_edge, capacity, limit |
rest.target.create() | POST | /graphspaces/{graphspace}/auth/targets | — |
rest.target.delete() | DELETE | /graphspaces/{graphspace}/auth/targets/{id} | — |
rest.target.get() | GET | /graphspaces/{graphspace}/auth/targets/{id} | — |
rest.target.list() | GET | /graphspaces/{graphspace}/auth/targets | limit |
rest.target.update() | PUT | /graphspaces/{graphspace}/auth/targets/{id} | — |
rest.task.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/tasks/{id} | force |
rest.task.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/tasks/{id} | with_result |
rest.task.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/tasks | status, ids, limit, page |
rest.task.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/tasks/{id} | action |
rest.template_paths.post() | POST | /graphspaces/{graphspace}/graphs/{graph}/traversers/templatepaths | — |
rest.user.create() | POST | /graphspaces/{graphspace}/auth/users | — |
rest.user.delete() | DELETE | /graphspaces/{graphspace}/auth/users/{id} | — |
rest.user.get() | GET | /graphspaces/{graphspace}/auth/users/{id} | — |
rest.user.list() | GET | /graphspaces/{graphspace}/auth/users | name, limit |
rest.user.role() | GET | /graphspaces/{graphspace}/auth/users/{id}/role | — |
rest.user.update() | PUT | /graphspaces/{graphspace}/auth/users/{id} | — |
rest.variables.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/variables/{key} | — |
rest.variables.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/variables/{key} | — |
rest.variables.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/variables | — |
rest.variables.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/variables/{key} | — |
rest.version.list() | GET | /versions | — |
rest.vertex.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices | — |
rest.vertex.create_batch() | POST | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices/batch | — |
rest.vertex.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices/{id} | label |
rest.vertex.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices/{id} | — |
rest.vertex.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices | label, properties, keep_start_p, offset, page, limit |
rest.vertex.update_batch() | PUT | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices/batch | — |
rest.vertex.update_by_id() | PUT | /graphspaces/{graphspace}/graphs/{graph}/graph/vertices/{id} | action |
rest.vertex_label.create() | POST | /graphspaces/{graphspace}/graphs/{graph}/schema/vertexlabels | — |
rest.vertex_label.delete() | DELETE | /graphspaces/{graphspace}/graphs/{graph}/schema/vertexlabels/{name} | — |
rest.vertex_label.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/vertexlabels/{name} | — |
rest.vertex_label.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/schema/vertexlabels | names |
rest.vertex_label.update() | PUT | /graphspaces/{graphspace}/graphs/{graph}/schema/vertexlabels/{name} | action |
rest.vertices.list() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/vertices | ids |
rest.vertices.scan() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/vertices/scan | start, end, page, page_limit |
rest.vertices.shards() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/vertices/shards | split_size |
rest.weighted_shortest_path.get() | GET | /graphspaces/{graphspace}/graphs/{graph}/traversers/weightedshortestpath | source, target, direction, label, weight, max_degree, skip_degree, with_vertex, with_edge, capacity |
rest.white_ip_list.list() | GET | /whiteiplist | — |
rest.white_ip_list.update_status() | PUT | /whiteiplist | status |
rest.white_ip_list.update_white_ips() | POST | /whiteiplist | — |
异常处理
常见异常定义位于 pyhugegraph.utils.exceptions:
| 异常类型 | 触发场景 |
|---|---|
NotAuthorizedError | 服务端返回 HTTP 401 未认证 |
NotFoundError | 服务端返回 HTTP 404 资源未找到 |
ServerError | 服务端返回非 2xx 响应(附带服务端错误详情) |
ResponseParseError | 响应内容无法反序列化为预期格式 |
ServiceUnavailableError | 服务端暂时不可用 |
InvalidParameterError, CreateError, RemoveError, UpdateError, DataFormatError | 客户端本地参数或格式校验失败 |
敏感参数(密码、Token、密钥等)在日志输出中会自动脱敏处理。
开发与测试验证
在 HugeGraph-AI 仓库根目录下执行代码规范与测试套件:
代码格式化与静态检查:
运行单元测试与契约测试:
针对正在运行的 HugeGraph Server 执行集成测试:
主线 CI 默认使用 hugegraph/hugegraph:latest 镜像进行集成验证,并对 1.7.0 执行兼容回归。源码与测试位于 hugegraph-python-client/src/pyhugegraph/ 和 hugegraph-python-client/src/tests/。
2.3 - HugeGraph Go 客户端快速入门
HugeGraph Go Client 是 Toolchain 仓库中的 Go SDK,目前提供版本查询、Schema(PropertyKey、VertexLabel、EdgeLabel)、顶点和 Gremlin API。边数据 API 尚未实现。
该模块仍在开发中。接口范围以
hugegraph-client-go/api/v1下的源码为准。
环境要求
- Go 1.19 或更高版本
- 可访问的 HugeGraph Server,默认示例地址为
http://127.0.0.1:8080
安装
在 Go module 项目中执行:
初始化客户端
NewCommonClient 要求 Host 是 IP 地址,Port 在 1 到 65535 之间;客户端始终使用明文 HTTP 连接。未启用认证时,用户名和密码留空;只有两者都设置时才会发送 Basic Auth。
GraphSpace 非空时,Vertex 和 Schema API(Schema()、Propertykey、VertexLabel、EdgeLabel)使用
/graphspaces/{space}/graphs/{graph}/... 路径;留空时使用旧版 /graphs/{graph}/... 路径。默认图空间填写 DEFAULT。
Gremlin 默认 aliases 也使用 GraphSpace,空值按 DEFAULT 处理。Version() 始终请求 /versions,不依赖图空间。
Version() 返回的 Versions 包含 HugeGraph Server、Core、Gremlin 和 REST API 版本。若使用源码提供的 NewDefaultCommonClient(),默认连接 127.0.0.1:8080 下的 hugegraph 图,使用 admin/pa 认证,并挂载一个打印全部请求和响应体的 ColorLogger;生产代码通常应显式传入配置。
配置项
hugegraph.Config 包含以下字段:
| 字段 | 类型 | 说明 |
|---|---|---|
Host | string | HugeGraph Server 的 IP 地址,不支持主机名 |
Port | int | HugeGraph Server 的 REST 端口,取值 1 到 65535 |
GraphSpace | string | Vertex、Schema API 和 Gremlin 默认 aliases 使用的图空间;默认空间填写 DEFAULT |
Graph | string | Server 上配置的图名 |
Username | string | Server 用户名,未启用认证时填空字符串 |
Password | string | Server 密码,未启用认证时填空字符串 |
Transport | http.RoundTripper | 自定义 HTTP transport,为 nil 时使用 http.DefaultTransport |
Logger | hgtransport.Logger | 请求/响应日志,为 nil 时不记录日志 |
hgtransport 包提供四种 logger:TextLogger(纯文本)、ColorLogger(终端彩色)、CurlLogger(可执行的 curl 命令)和 JSONLogger(JSON 行)。它们的字段相同:Output(io.Writer)、EnableRequestBody 和 EnableResponseBody。
已实现的入口
CommonClient 当前公开以下入口:
| 入口 | 用途 |
|---|---|
Version() | 查询服务端版本 |
Schema() | 查询完整 Schema |
Propertykey | Create、GetAll、GetByName、UpdateUserdata、DeleteByName |
VertexLabel | Create、GetAll、GetByName、UpdateUserdata、DeleteByName |
EdgeLabel | Create、GetAll、DeleteByName |
Vertex | Create、BatchCreate、UpdateProperties(通过 WithAction 指定 append 或 eliminate) |
Gremlin | Get 和 Post。Post 默认 language 为 gremlin-groovy,根据 GraphSpace 和 Graph 自动填充 graph/g aliases,并在 Data 中返回解析后的结果;Get 只返回状态码,并把原始响应打印到 stdout。 |
每个操作都通过挂在操作本身上的 With... 函数式选项传参,例如 client.Gremlin.Post.WithGremlin(...) 或 client.Propertykey.GetByName.WithName(...)。
EdgeLabel.Create 的请求数据允许 Properties: nil 或空切片 []string{},用于创建无属性的边标签。
类型化 API 返回的 err 表示参数校验、传输、响应读取或 JSON 解码错误。
HTTP 4xx/5xx 仍可能返回 err == nil,例如创建顶点时指定不存在的 label 会返回 HTTP 400。
读取结果数据前,请检查 response.StatusCode 是否属于 2xx。调用 Gremlin.Post 时,还需检查 response.Data.Status.Code 是否为成功的 Gremlin 协议状态码(2xx)。
Vertex相关操作的入参是internal/model包中的model.Vertex[any]。Go 不允许从其他 module 导入internal包,因此目前VertexAPI 只能在客户端 module 内部调用;其测试文件也已全部注释。
完整调用方式可参考各 API 目录中的测试,例如 version_test.go、gemlin_test.go 和 vertexlabel_test.go。
3 - Gremlin-Console
Gremlin-Console 是 TinkerPop 的交互式客户端,支持离线操作图,也可以连接 Server 提交查询。常用 Gremlin 遍历语法与示例请参阅 Gremlin 查询语言。主要包含两种工作模式:
- 单机离线调用模式 — 直接执行 Groovy 脚本操作 HugeGraph-Core,无需启动 Server 服务。
- Client/Server 请求模式 — 通过 WebSocket 连接运行中的 HugeGraph Server,远程执行 Gremlin 查询。
Gremlin-Console 适合快速体验、原型探索与排查调试,不推荐直接用于高并发或高吞吐的生产环境。生产环境建议使用相应语言的客户端(如 HugeGraph-Client)。
1 单机离线调用模式
Server 发行包内的 Console 已包含 HugeGraph-Core JAR 和插件,可以直接执行 Groovy 脚本操作图,无需启动 Server。
先在 hugegraph.properties 中配置 Memory 后端。其他后端可能需要额外初始化。
然后运行示例脚本。
这里的
--会被 getopts 解析为最后一个 option,这样后面的 options 就可以传入 Gremlin-Console 进行处理了。-i代表Execute the specified script and leave the console open on completion,更多选项请参考 TinkerPop Gremlin Console 官方文档。
其中 example.groovy 是 scripts 目录下的一个示例脚本,该脚本插入了一些数据,并在最后查询图中顶点和边的数量。
脚本执行后,可以继续输入 Gremlin 语句。
更多的 Gremlin 语句请参考 Tinkerpop 官网。
2 Client/Server 请求模式
Gremlin-Console 通过 WebSocket 连接 HugeGraph-Server。使用与 Server 同版本发行包中的 Console 和 conf/remote.yaml,
保留文件中的序列化器配置,只修改地址,以及启用鉴权时需要的凭据。旧版配置可能引用已经不存在的序列化器类。
准备连接配置并启动 Server。
检查
conf/gremlin-server.yaml中的host、port。默认的WsAndHttpChannelizer同时处理 WebSocket 和 HTTP 请求,无需修改。conf/remote.yaml中的hosts应填写 Console 能访问的 Server 地址,port应与 Gremlin 端口一致(默认为8182,不是 REST 端口8080)。 按照快速上手启动 Server。当前 master 配置使用 GraphBinary V1 和 HugeGraph 类型注册器。
如果 Server 开启了鉴权,在同一个文件中填写实际凭据。
随包的
remote-objects.yaml和gremlin-driver-settings.yaml使用相同的序列化器配置;使用这些文件时也要保持一致。从 Server 发行包目录启动 Console,并创建带 traversal 别名的客户端。
Server 端将默认图空间下的图绑定为
DEFAULT-hugegraph,其 traversal source 绑定为__g_DEFAULT-hugegraph。 由于连字符-在 Groovy 中不能直接用作变量名,通过 Java Driver 连接时,使用.alias(['g': '__g_DEFAULT-hugegraph'])将其映射为g。通过客户端提交查询。
若启动 Server 时预加载了示例图,两条查询均返回
6(其他图返回其实际顶点数)。 通过 Driver 的client.submit()提交脚本时,无需在语句前加:>前缀。使用结束后关闭客户端和集群连接。
此外,也可以使用 Gremlin Console 内置的 :remote 命令连接:
使用 :remote 连接时,以 :> 开头的语句会被发送至远端 Server 执行,普通语句则在 Console 本地执行。
更多用法见 TinkerPop Gremlin Console 参考。