这是本节的多页打印视图。 .
使用指南
- 1: HugeGraph 架构概览
- 1.1: HugeGraph Plugin 机制及插件扩展流程
- 1.2: HugeGraph 设计理念
- 2: 开发测试
- 2.1: HugeGraph工具链本地测试指南
- 2.2: ToplingDB 开发版集成
- 3: 备份与恢复
- 4: HugeGraph Docker 集群部署指南
- 5: FAQ
- 6: 报告安全问题
- 7: 1.8.0 共享基础模块迁移指南
- 8: HugeGraph 1.8.0 Gremlin 迁移与兼容性指南
本节说明 HugeGraph 的架构、设计、备份恢复、插件开发、安全设置和常见问题。
1 - HugeGraph 架构概览
全栈组件
HugeGraph 生态由职责不同的图数据库、图计算、图 AI 和工具链组件组成。HugeGraph Server 提供 OLTP 图数据库服务;HugeGraph-Computer 与 Vermeer 是独立的 OLAP 图计算引擎;HugeGraph-AI 提供图 AI 能力。Toolchain 中的客户端、数据导入、可视化和运维工具为应用及运维人员提供配套入口。
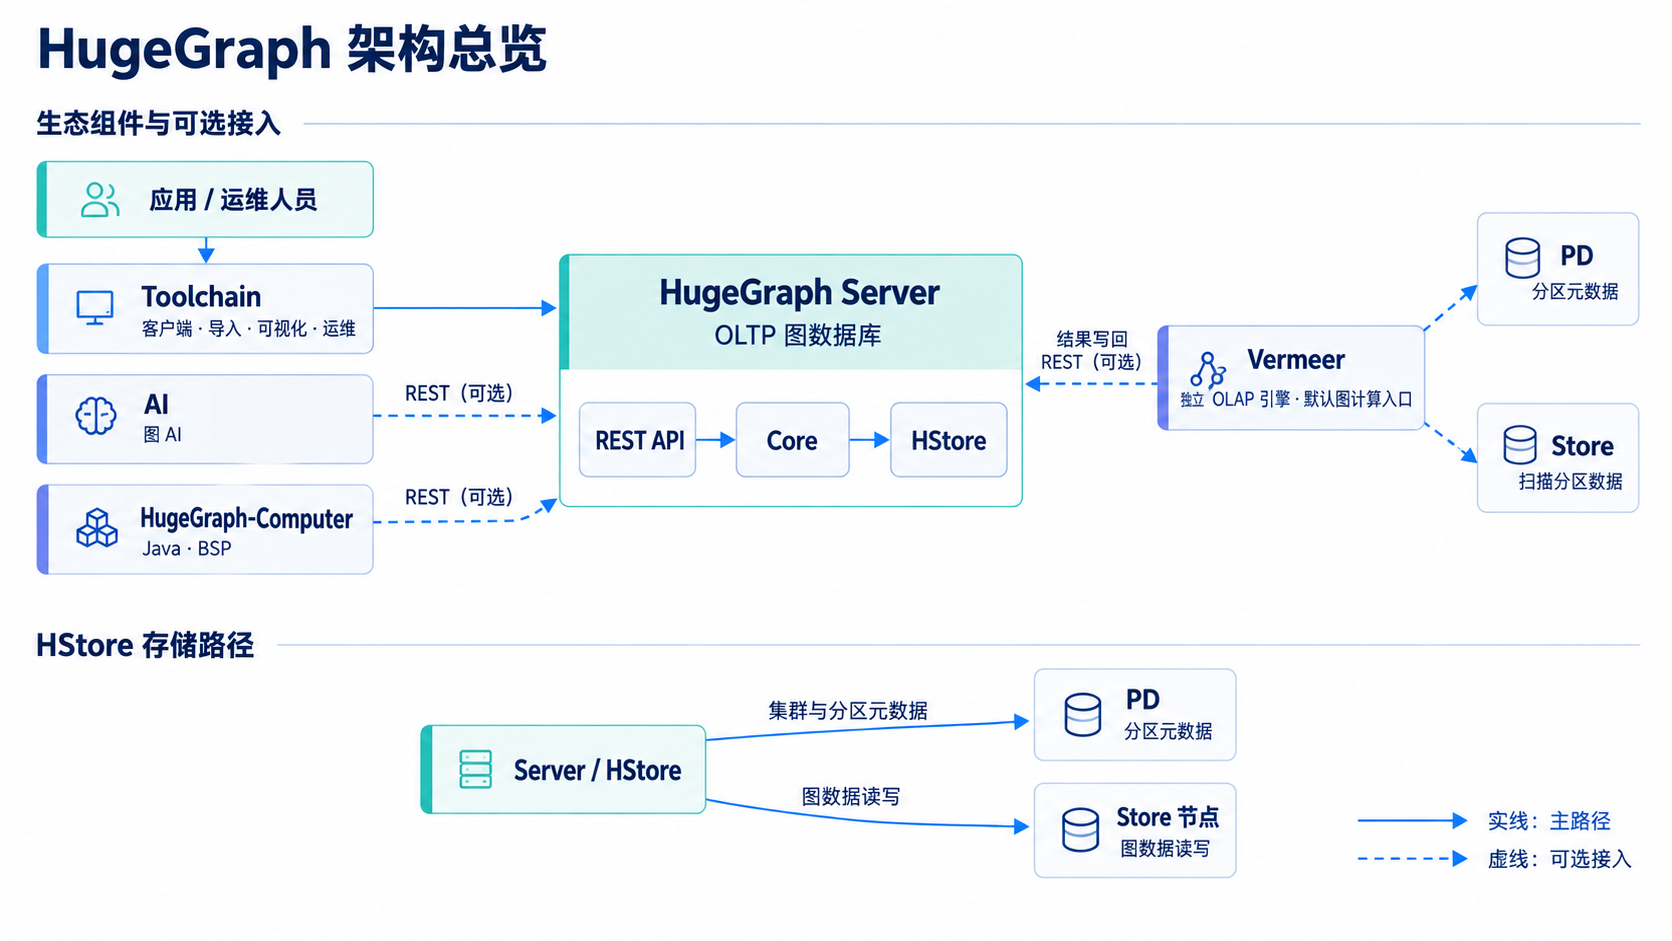
图:Server 以 HStore 后端为例;RocksDB、HBase 等独立后端见下方 Mermaid。Vermeer 和 HugeGraph-Computer 是独立的 OLAP 引擎,虚线表示可选接入。
生态接入
flowchart TB
  Apps["应用 / 运维"] --> Toolchain["Toolchain"] --> Server["Server REST API"]
  AI["AI"] -. REST .-> Server
  Computer["Computer"] -. REST .-> Server
  Vermeer["Vermeer"] -. PD .-> PD["PD"]
  Vermeer -. 扫描 .-> Store["Store"]
  Vermeer -. 写回 .-> Server
虚线表示可选的 HugeGraph 接入,不代表所有 AI、Computer 或 Vermeer 任务都必须连接 Server、PD 或 Store。Computer 和 AI 通过 Server REST API 读写图数据。Vermeer 的 HugeGraph 输入模式向 PD 查询分区元数据,并直接向 Store 扫描 HStore 分区;选择 HugeGraph 结果输出时,再通过 Server REST API 写回结果。
Server 内部结构
flowchart TB
  API["REST API / Gremlin"] --> Core["Core"] --> Adapter["后端适配"]
  Adapter --> RocksDB["RocksDB"]
  Adapter --> HBase["HBase"]
  Adapter --> HStore["HStore"]
  HStore --> PD["PD"]
  HStore --> Store["Store"]
Server 的 REST API 和 Gremlin 接口把请求交给 Core,再由存储后端适配器执行读写。RocksDB 和 HBase 是独立后端;HStore 适配器从 PD 获取集群元数据和分区信息,并向 Store 节点发送图数据操作。PD 管理集群元数据与分区,不承载图数据读写路径。
当前 Server 提供 RocksDB、HBase、HStore 和内存后端实现。内存后端主要用于测试或临时使用,不属于正式持久化部署选项;生产部署方式见 Server 快速上手。
Toolchain 的主要组件如下:
- Hubble — Web 交互式图可视化与一站式管理工作台。
- Loader — 支持多源、断点续传的高性能批量图数据导入工具。
- Tools — 提供集群部署运维、元数据检查与备份恢复能力的 CLI 工具。
- Client — 官方多语言客户端 SDK,支持 Java、Python 与 Go。
独立图计算引擎
- Vermeer — 基于 Go 实现的高性能内存级图计算引擎,内置 15+ OLAP 核心算法。
- HugeGraph-Computer — 基于 BSP/Pregel 模型的 Java 分布式大规模图计算框架。
历史架构图
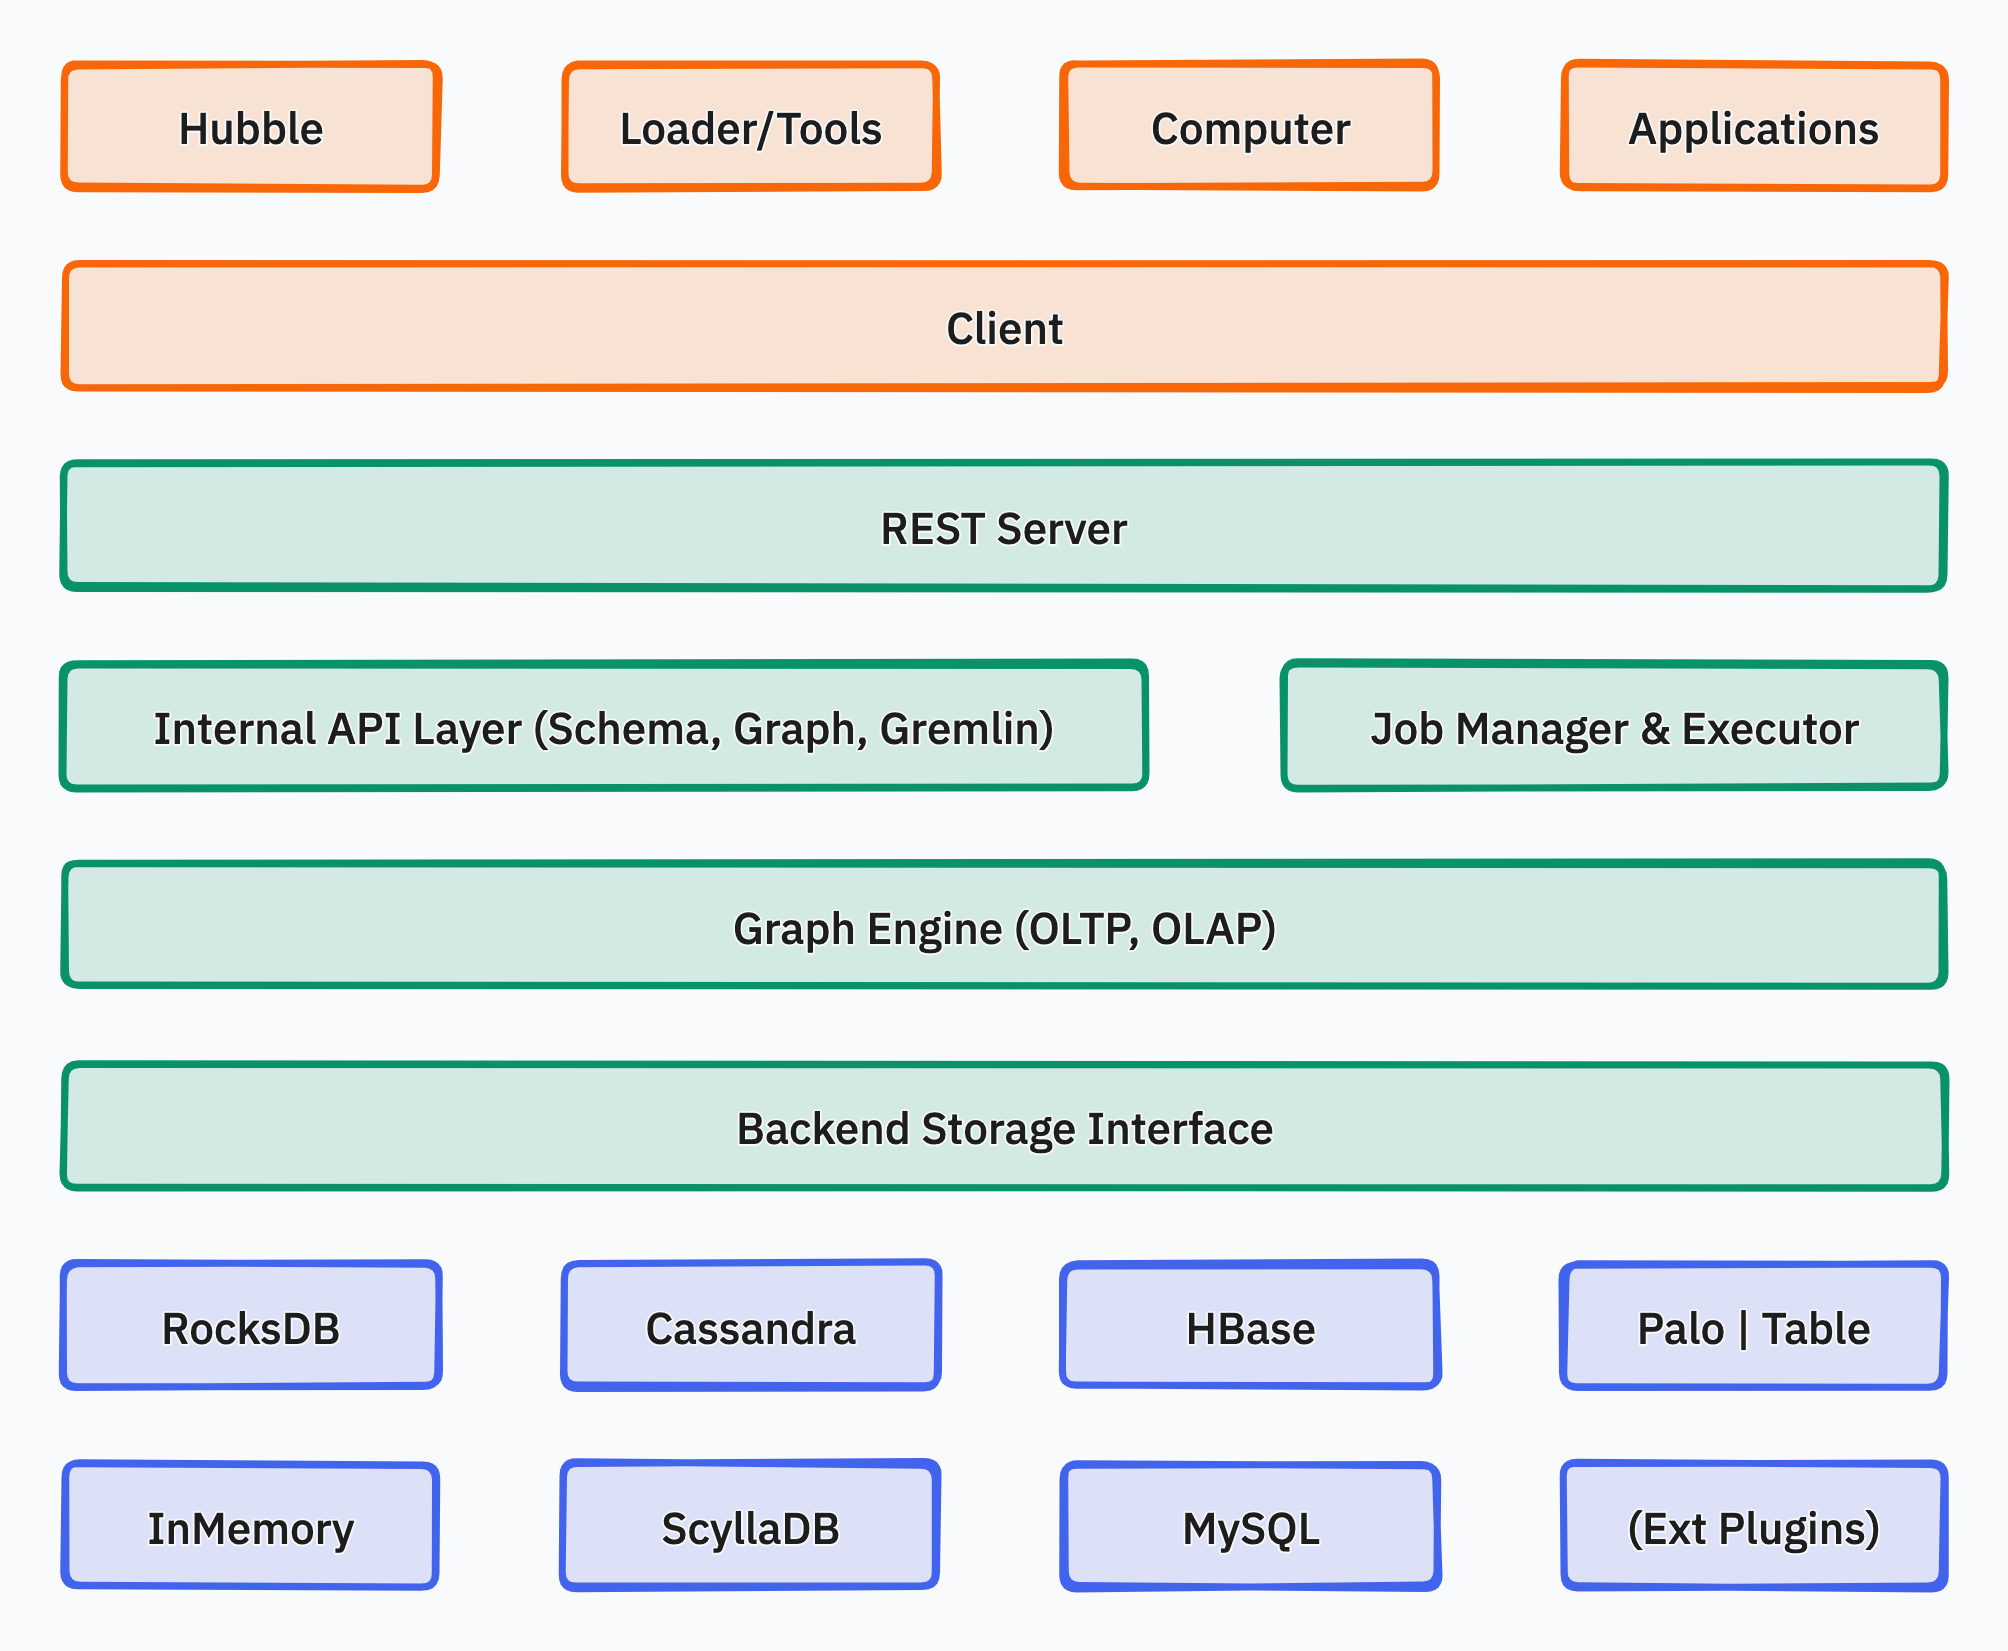
下图保留作历史参考,其中 Server 同时承担 OLTP 与 OLAP、以及多种旧后端的标注不代表 当前主线实现。
相关专题
介绍 HugeGraph Plugin 扩展机制、SPI 接口注册与自定义插件生命周期。
早期属性图模型设计背景、分区方案与历史实现考量。
1.1 - HugeGraph Plugin 机制及插件扩展流程
插件接入计划用于 1.8.0 的共享基础模块 API 时,请按Java/SPI 迁移指南调整并使用配套 artifacts 重新编译。 下方示例描述 1.7.0 API。
背景
- HugeGraph 不仅开源开放,而且要做到简单易用,一般用户无需更改源码也能轻松增加插件扩展功能。
- HugeGraph 支持多种内置存储后端,也允许用户无需更改现有源码的情况下扩展自定义后端。
- HugeGraph 支持全文检索,全文检索功能涉及到各语言分词,目前已内置 7 种分词器(ansj、hanlp、smartcn、jieba、jcseg、mmseg4j、ikanalyzer),也允许用户无需更改现有源码的情况下扩展自定义分词器。
可扩展维度
目前插件方式提供如下几个维度的扩展项:
- 后端存储
- 序列化器
- 自定义配置项
- 分词器
插件实现机制
- 提供 SPI 接口:HugeGraph 提供核心插件接口
HugeGraphPlugin,通过标准 Java SPI 机制支持运行时插件化发现。 - 静态注册入口:
HugeGraphPlugin提供了 4 个扩展项注册静态函数:registerOptions()、registerBackend()、registerSerializer()、registerAnalyzer()。 - 实现扩展接口:插件开发者实现相应的
OptionHolder、BackendStoreProvider、AbstractSerializer或Analyzer等核心接口。 - 插件注册并打包:实现
HugeGraphPlugin的register()方法完成类注册,配置META-INF/services/描述文件并打成 JAR 包。 - 部署生效:将编译出的 JAR 包放置在 HugeGraph Server 安装目录的
plugins/路径下,修改对应配置项后重启服务即可生效。
插件实现流程实例
1 新建一个 maven 项目
1.1 项目名称取名:hugegraph-plugin-demo
1.2 添加hugegraph-core Jar 包依赖
maven pom.xml 详细内容如下。hugegraph.version 应与要兼容的 Server 版本一致;此处以当前主线版本 1.7.0 为例:
2 实现扩展功能
2.1 扩展自定义后端
2.1.1 实现接口 BackendStoreProvider
- 可实现接口:
org.apache.hugegraph.backend.store.BackendStoreProvider - 或者继承抽象类:
org.apache.hugegraph.backend.store.AbstractBackendStoreProvider
以 RocksDB 后端 RocksDBStoreProvider 为例:
2.1.2 实现接口 BackendStore
BackendStore 的核心抽象方法如下(接口默认辅助方法略):
2.1.3 扩展自定义序列化器
序列化器必须继承抽象类:org.apache.hugegraph.backend.serializer.AbstractSerializer(implements GraphSerializer, SchemaSerializer) 主要接口的定义如下:
2.1.4 扩展自定义配置项
增加自定义后端时,可能需要增加新的配置项,实现流程主要包括:
- 增加配置项容器类,并实现接口
org.apache.hugegraph.config.OptionHolder - 提供单例方法
public static OptionHolder instance(),并在对象初始化时调用方法OptionHolder.registerOptions() - 增加配置项声明,单值配置项类型为
ConfigOption、多值配置项类型为ConfigListOption
以 RocksDB 配置项定义为例:
2.2 扩展自定义分词器
分词器需要实现接口org.apache.hugegraph.analyzer.Analyzer,以实现一个 SpaceAnalyzer 空格分词器为例。
3. 实现插件接口,并进行注册
插件注册入口为HugeGraphPlugin.register(),自定义插件必须实现该接口方法,在其内部注册上述定义好的扩展项。接口org.apache.hugegraph.plugin.HugeGraphPlugin定义如下:
并且 HugeGraphPlugin 提供了 4 个静态方法用于注册扩展项:
- registerOptions(String name, String classPath):注册配置项
- registerBackend(String name, String classPath):注册后端(BackendStoreProvider)
- registerSerializer(String name, String classPath):注册序列化器
- registerAnalyzer(String name, String classPath):注册分词器
下面以注册 SpaceAnalyzer 分词器为例:
4. 配置 SPI 入口
- 确保 services 目录存在:hugegraph-plugin-demo/resources/META-INF/services
- 在 services 目录下建立文本文件:org.apache.hugegraph.plugin.HugeGraphPlugin
- 文件内容如下:org.apache.hugegraph.plugin.DemoPlugin
5. 打 Jar 包
通过 maven 打包,在项目目录下执行命令mvn package,在 target 目录下会生成 Jar 包文件。使用时将该 Jar 包拷到plugins目录,重启服务即可生效。
1.2 - HugeGraph 设计理念
1. 属性图模型
版本说明:本页保留早期设计内容。属性图模型和顶点 ID 策略仍与 当前主线源码相符;图示、分区结论及事务实现描述按各节注明的范围阅读,不能直接当作当前部署或存储实现说明。
常见的图数据表示模型有两种,分别是RDF(Resource Description Framework)模型和属性图模型。 RDF和Property Graph都是最基础、最有名的图表示模式,都能够表示各种图的实体关系建模。 RDF是W3C标准,而Property Graph是工业标准,受到广大图数据库厂商的广泛支持。HugeGraph目前采用Property Graph。
HugeGraph采用属性图模型。下图以人物和图书为例,展示顶点与有向边各自的标签和属性;这是逻辑模型示意,不描述 当前主线的内部数据布局。
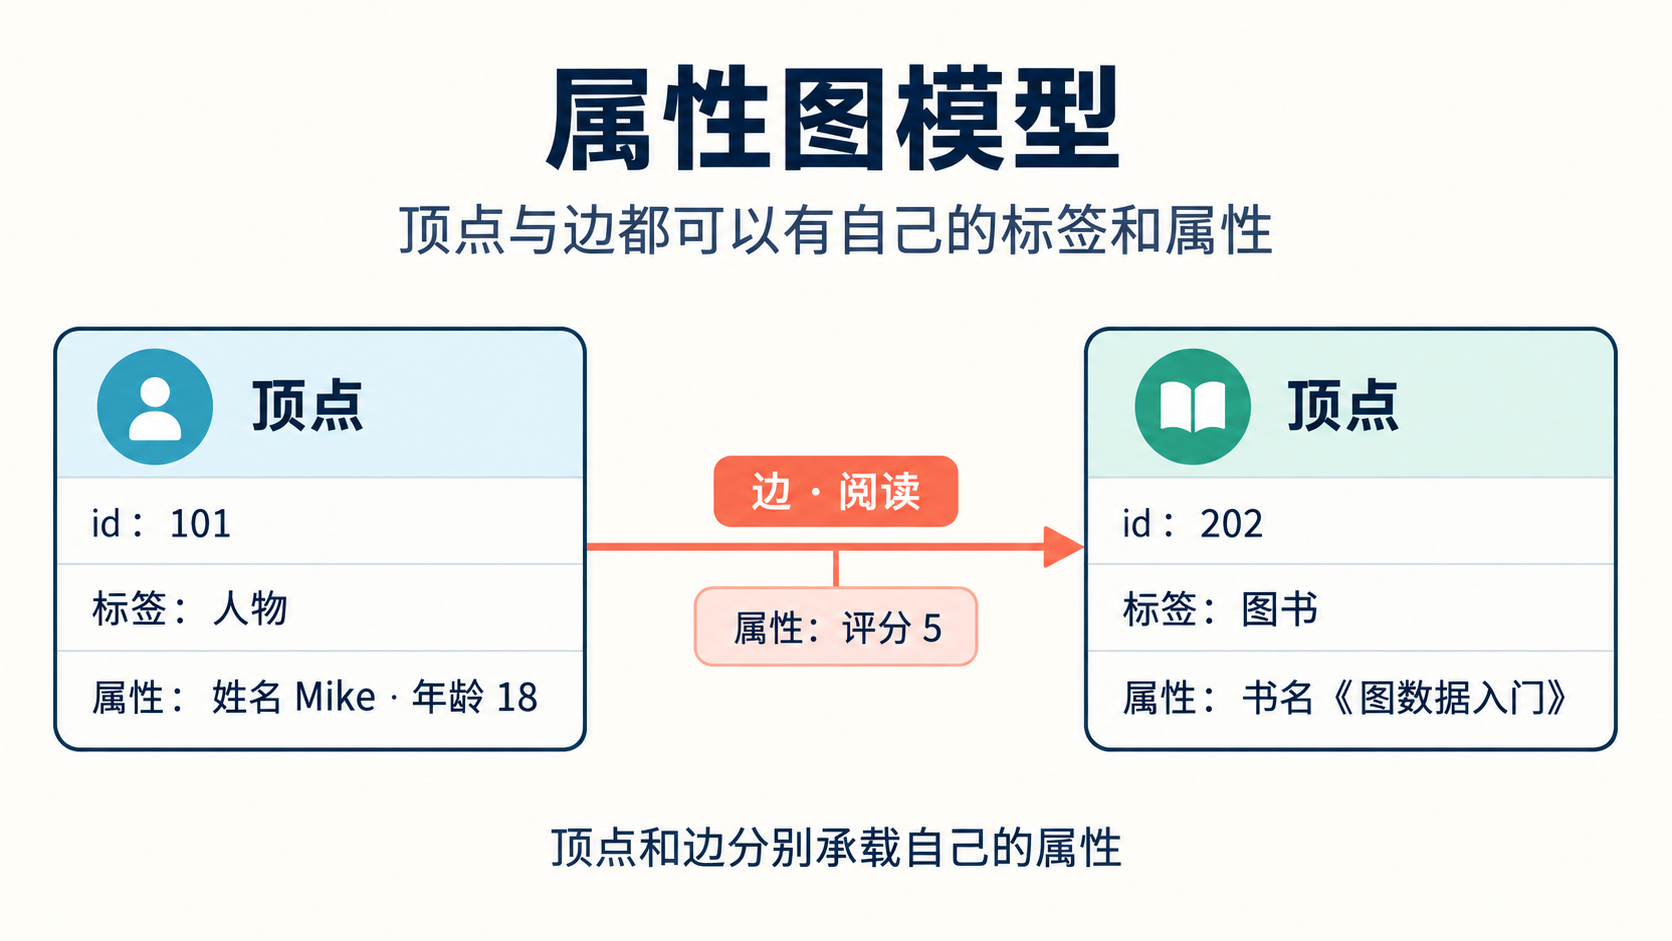
图:顶点和边分别携带自己的标签与属性。
在HugeGraph内部,每个顶点 / 边由唯一的 VertexId / EdgeId 标识,属性存储在对应点 / 边内部。而顶点与顶点之间的关系 / 映射则是通过边来存储的。
顶点属性值通过边指针方式存储时,如果要更新一个顶点特定的属性值直接通过覆盖写入即可,其弊端是冗余存储了VertexId;如果要更新关系的属性需要通过read-and-modify方式,先读取所有属性,修改部分属性,然后再写入存储系统,更新效率较低。 从经验来看顶点属性的修改需求较多,而边的属性修改需求较少,例如PageRank和Graph Cluster等计算都需要频繁修改顶点的属性值。
2. 图分区方案
版本说明:Edge Cut 与 Vertex Cut 的比较属于历史设计背景。当前主线的 PD 与 Store 源码没有把“HugeGraph 采用 Edge Cut”定义为实现契约,因此下文该结论不适用于描述 当前主线的实际分区与副本机制;当前分布式部署请参考 HStore 快速上手。
对于分布式图数据库而言,图的分区存储方式有两种:分别是边分割存储(Edge Cut)和点分割存储(Vertex Cut),如下图所示。使用Edge Cut方式存储图时,任何一个顶点只会出现在一台机器上,而边可能分布在不同机器上,这种存储方式有可能导致边多次存储。 使用Vertex Cut方式存储图时,任何一条边只会出现在一台机器上,而每相同的一个点可能分布到不同机器上,这种存储方式可能会导致顶点多次存储。
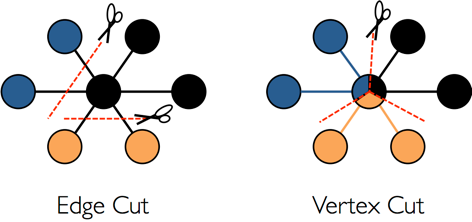
采用EdgeCut分区方案可以支持高性能的插入和更新操作,而VertexCut分区方案更适合静态图查询分析,因此EdgeCut适合OLTP图查询,VertexCut更适合OLAP的图查询。早期设计资料曾记载 HugeGraph 采用 Edge Cut。此处保留该历史结论,不将其视为当前分区实现说明。
3. VertexId 策略
HugeGraph的Vertex支持四种ID策略,在同一个图数据库中不同的VertexLabel可以使用不同的Id策略,目前HugeGraph支持的Id策略分别是:
- 自动生成(AUTOMATIC):使用Snowflake算法自动生成全局唯一Id,Long类型;
- 主键(PRIMARY_KEY):通过VertexLabel+PrimaryKeyValues生成Id,String类型;
- 自定义(CUSTOMIZE_STRING|CUSTOMIZE_NUMBER):用户自定义Id,分为String和Long类型两种,需自己保证Id的唯一性;
- 自定义UUID(CUSTOMIZE_UUID):用户自定义UUID形式的Id,需自己保证Id的唯一性;
默认的Id策略是AUTOMATIC,如果用户调用primaryKeys()方法并设置了正确的PrimaryKeys,则自动启用PRIMARY_KEY策略。启用PRIMARY_KEY策略后HugeGraph能根据PrimaryKeys实现数据去重。
- AUTOMATIC ID策略
- PRIMARY_KEY ID策略
- CUSTOMIZE_STRING ID策略
- CUSTOMIZE_NUMBER ID策略
- CUSTOMIZE_UUID ID策略
如果用户需要Vertex去重,有三种方案分别是:
- 采用PRIMARY_KEY策略,自动覆盖,适合大数据量批量插入,用户无法知道是否发生了覆盖行为
- 采用AUTOMATIC策略,read-and-modify,适合小数据量插入,用户可以明确知道是否发生覆盖
- 采用CUSTOMIZE_STRING或CUSTOMIZE_NUMBER策略,用户自己保证唯一
4. EdgeId 策略
当前实现提示:本节的四项组合是历史简化描述。当前
EdgeId还区分边方向及父、子边标签;其实际字段见 Server 源码中的EdgeId实现。需要依赖 ID 格式或持久化键时,应以对应版本源码为准。
HugeGraph的EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合而成。其中sortKey是HugeGraph的一个重要概念。在Edge中加入sortKey作为Edge的唯一标识的原因有两个:
- 如果两个顶点之间存在多条相同Label的边可通过
sortKey来区分 - 对于SuperNode的节点,可以通过
sortKey来排序截断。
由于EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合,多次插入相同的Edge时HugeGraph会自动覆盖以实现去重。需要注意的是如果批量插入模式下Edge的属性也将会覆盖。
另外由于HugeGraph的EdgeId采用自动去重策略,对于self-loop(一个顶点存在一条指向自身的边)的情况下HugeGraph认为仅有一条边,对于采用AUTOMATIC策略的图数据库(例如TitianDB )则会认为该图存在两条边。
HugeGraph的边仅支持有向边,无向边可以创建Out和In两条边来实现。
5. HugeGraph 事务概览
版本范围:下文关于 HugeGraph 隔离级别、线程绑定和后端原子性的描述保留为历史实现说明。各后端的事务隔离与失败回滚边界应以对应实现为准,不应将下述历史描述当作跨后端保证。
TinkerPop事务概述
TinkerPop 事务是对数据库执行操作的工作单元,一个事务内的一组操作要么执行成功,要么全部失败。详细介绍请参考TinkerPop官方文档:http://tinkerpop.apache.org/docs/current/reference/#transactions
TinkerPop事务操作接口
- open 打开事务
- commit 提交事务
- rollback 回滚事务
- close 关闭事务
TinkerPop事务规范
- 事务必须显式提交后才可生效(未提交时修改操作只有本事务内查询可看到)
- 事务必须打开之后才可提交或回滚
- 如果事务设置自动打开则无需显式打开(默认方式),如果设置手动打开则必须显式打开
- 可设置事务关闭时:自动提交、自动回滚(默认方式)、手动(禁止显式关闭)等3种模式
- 事务在提交或回滚后必须是关闭状态
- 事务在查询后必须是打开状态
- 事务(非threaded tx)必须线程隔离,多线程操作同一事务互不影响
更多事务规范用例见:Transaction Test
HugeGraph事务实现
- 一个事务中所有的操作要么成功要么失败
- 一个事务只能读取到另外一个事务已提交的内容(Read committed)
- 所有未提交的操作均能在本事务中查询出来,包括:
- 增加顶点能够查询出该顶点
- 删除顶点能够过滤掉该顶点
- 删除顶点能够过滤掉该顶点相关边
- 增加边能够查询出该边
- 删除边能够过滤掉该边
- 增加/修改(顶点、边)属性能够在查询时生效
- 删除(顶点、边)属性能够在查询时生效
- 所有未提交的操作在事务回滚后均失效,包括:
- 顶点、边的增加、删除
- 属性的增加/修改、删除
示例:一个事务无法读取另一个事务未提交的内容
事务实现原理
- 服务端内部通过将事务与线程绑定实现隔离(ThreadLocal)
- 本事务未提交的内容按照时间顺序覆盖老数据以供本事务查询最新版本数据
- 底层依赖后端数据库保证事务原子性操作(如RocksDB的batch接口保证原子性)
注意
REST API 未提供独立的事务生命周期接口;写操作接口会在服务端调用相应的事务提交逻辑。
TinkerPop API允许打开事务,请求完成时会自动关闭(Gremlin Server强制关闭)
2 - 开发测试
本节汇总 HugeGraph 开发者在本地进行测试与环境集成的操作指南。
模块指引
指导开发者在本地搭建 HugeGraph Server 并运行 Toolchain 全量组件的单元测试与功能测试。
介绍从开发源码构建并启用可选 ToplingDB 运行时的配置与测试方法。
2.1 - HugeGraph工具链本地测试指南
本指南帮助开发者在本地运行 HugeGraph 工具链测试。
1. 核心概念
1.1 核心依赖:HugeGraph Server
工具链的集成测试和功能测试都依赖 HugeGraph Server,包括 Client、Loader、Hubble、Spark Connector、Tools 等组件。
1.2 测试类型
- 单元测试 (Unit Tests):测试单个函数/方法,不依赖外部服务
- API 测试 (ApiTestSuite):测试 API 接口,需要运行中的 HugeGraph Server
- 功能测试 (FuncTestSuite):端到端测试,需要完整的系统环境
2. 环境准备
2.1 系统要求
- 操作系统:Linux / macOS(Windows 使用 WSL2)
- JDK:>= 11,配置好
JAVA_HOME - Maven:>= 3.6
- Python:>= 3.11(仅 Hubble 测试需要)
2.2 克隆代码
3. 部署测试环境
方式选择
- 脚本部署:指定 Server Commit,可复现 CI 使用的服务端版本
- Docker 部署:适合快速检查;测试失败时应先核对镜像与 Toolchain 的兼容性
详细安装说明参考 社区文档
3.1 脚本部署
参数说明
$COMMIT_ID:指定 Server 源码的 Git Commit ID$DB_DATABASE/$DB_PASS:Loader JDBC 测试用的 MySQL 数据库名和密码
部署步骤
1. 安装 HugeGraph Server
- 脚本会启动 HTTP 8080 和 HTTPS 8443 两个实例,并配置
admin/pa认证。 - 执行前确认两个端口未被占用。
2. 安装可选依赖
3. 健康检查
3.2 Docker 部署
注意:Docker 镜像可能版本滞后,如遇兼容性问题请使用脚本部署
快速启动
docker-compose 配置(可选)
完整配置示例,包含 Server、MySQL、Hadoop 服务(需要 Docker Compose V2):
Hadoop 配置挂载
在与 docker-compose.yml 相同的目录下创建 ./config 文件夹用于挂载 Hadoop 配置文件。如果不需要 HDFS 测试,可以跳过此步骤。
📁 ./config/core-site.xml 内容:
📁 ./config/hdfs-site.xml 内容:
Docker 操作
4. 运行测试
各工具的测试流程:
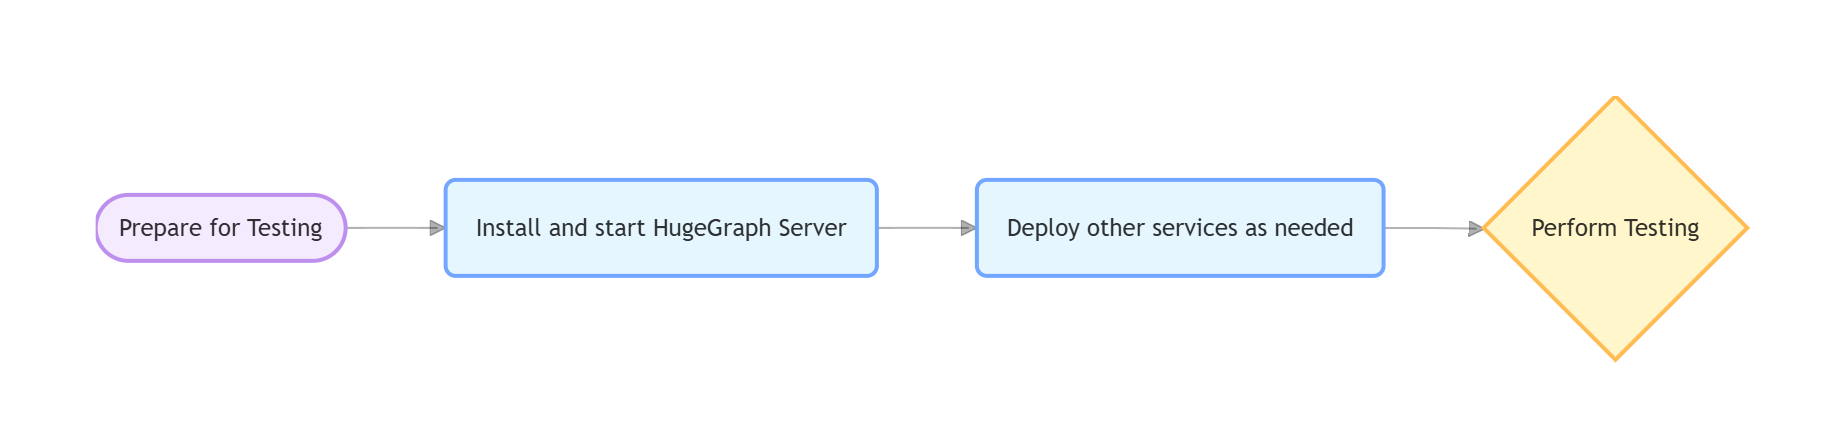
4.1 hugegraph-client
编译
依赖服务
启动 HugeGraph Server(参考 第3节)
Server 鉴权配置
ApiTest 需要认证。使用 3.1 节的脚本安装时无需重复配置;自行部署 Server 时,认证配置和测试凭证必须与测试代码一致。
运行测试
测试失败时检查 Server 日志:
logs/hugegraph-server.log
4.2 hugegraph-loader
编译
依赖服务
- 必需:HugeGraph Server
- 可选:Hadoop (HDFS 测试)、MySQL (JDBC 测试);Kafka 测试通过 Testcontainers 启动 Kafka 容器,因此还需要可用的 Docker daemon
运行测试
4.3 hugegraph-hubble
编译
依赖服务
1. 启动 Server(参考 第3节)
2. Python 环境
3. 构建并验证
运行测试
4.4 hugegraph-spark-connector
编译
运行测试
4.5 hugegraph-tools
编译
运行测试
5. 常见问题
服务连接问题
无法连接 Server、MySQL 或 Hadoop 时:
- 确认服务已启动(Server 必须在 8080 端口)
- 检查端口占用:
lsof -i:8080 - Docker 检查:
docker compose ps和docker compose logs
配置问题
找不到文件或参数错误时:
- 检查环境变量:
echo $COMMIT_ID - 脚本权限:
chmod +x hugegraph-*/assembly/travis/*.sh
HDFS 测试失败
- 确认 NameNode/DataNode 运行正常
- 检查 Hadoop 日志
- 验证 HDFS 连接:
hdfs dfsadmin -report
JDBC 测试失败
- 确认 MySQL 运行正常
- 验证数据库连接:
mysql -u root -p$DB_PASS - 检查 MySQL 日志
6. 参考资料
- HugeGraph GitHub 仓库:https://github.com/apache/hugegraph
- HugeGraph 工具链 GitHub 仓库:https://github.com/apache/hugegraph-toolchain
- HugeGraph Server 文档:https://hugegraph.apache.org/cn/docs/quickstart/hugegraph/hugegraph-server/
- CI 配置:
.github/workflows/*-ci.yml - 依赖服务安装脚本:
hugegraph-*/assembly/travis/
2.2 - ToplingDB 开发版集成
开发版接口:本文适用于开启可选 ToplingDB 运行时的开发构建版本。 已有发行版和镜像标签不代表支持本文接口,采用前须完成运行时验证。
确认数据库所属组件
HugeGraph 默认使用标准 RocksDB。对持有本地存储的每个进程分别启用 Topling:
| 组件 | 业务 provider 配置 | 启动命令 |
|---|---|---|
| 独立 RocksDB Server | 每个选用的 graph properties 文件中设置 rocksdb.provider=topling | bin/start-hugegraph.sh |
| PD | conf/application.yml 的 rocksdb 下设置 provider: topling | bin/start-hugegraph-pd.sh |
| Store | conf/application-pd.yml 的 rocksdb 下设置 provider: topling | bin/start-hugegraph-store.sh |
独立 Server 保持 backend=rocksdb;HStore Server 使用 backend=hstore,不需要本地 Topling 运行时。
同一 Server 进程中的本地 RocksDB 图必须使用相同 provider。业务配置必须与启动脚本选择的运行时一致。
构建并准备标准发行包
在源码仓库根目录,使用 Java 17 和 Maven 3.6.3 或更新版本构建普通发行包:
从可信制品渠道取得 Topling Easy Migrate JNI JAR 及其 SHA-256。准备环境需要 Java 17 JDK、Linux x86_64、sha256sum、unzip、od、ldd 和 GNU mv。
还须满足所选 JAR 的 native 依赖,包括其要求的 glibc 和 libaio。
先停止组件,解压一份新的标准发行包,再从该组件目录执行:
脚本校验复制后的 JAR 哈希、Topling Java 标识、唯一的 Linux x86_64 JNI 条目、ELF 架构及 native 依赖。
安装前还会用所选 JNI 打开临时数据库,确认 EasyMigrate 配置实际改变了持久化的写缓冲区大小;类标识和哈希匹配但不支持该配置入口的构建会被拒绝。
此探针不代表已有数据兼容性或所有生产配置均已验证。校验记录绑定已测试的 JAR 和 native 库,启动时拒绝缺失或失效的记录;从旧准备脚本升级时请重新准备一份新发行包。
默认/标准模式启动时会拒绝继承的 RocksDB JNI 预载库,Topling 模式则拒绝与所选 JNI 竞争的预载库;其他预载库继续保留。
它将 topling/rocksdbjni.jar、对应 native 库和可选网页资源放在 lib 之外。已有 topling 目录时会拒绝准备;更换运行时请使用另一份已停止的新发行包。
按实际部署需要,为 Server、PD 和 Store 分别执行准备步骤。
将持久数据放在发行包之外
更换 provider 不会转换已有数据库。为 Topling 使用独立、初始为空的目录,并保留标准 provider 的数据。 预先创建服务账号可写的持久目录,将其放在源码检出、构建输出和解压后的发行包目录之外。注意:每个图必须使用互不相同的独立数据与 WAL 目录,避免目录冲突:
| 组件 | 配置文件及配置项 | 持久路径示例 |
|---|---|---|
| Server 数据 | Graph properties:rocksdb.data_path | /srv/hugegraph/topling/server/<graph>/data |
| Server WAL | Graph properties:rocksdb.wal_path | /srv/hugegraph/topling/server/<graph>/wal |
| PD | conf/application.yml:pd.data-path | /srv/hugegraph/topling/pd |
| Store 数据 | conf/application.yml:app.data-path | /srv/hugegraph/topling/store/data |
| Store Raft | conf/application.yml:app.raft-path | /srv/hugegraph/topling/store/raft |
独立 Server 的每个选用图配置都需修改,例如 conf/graphs/hugegraph.properties(若配置多个图,请将路径中的 hugegraph 替换为对应图名):
Server 的数据和 WAL 路径都要设置,且不同图之间不能共享同一路径。若 WAL 仍使用发行包内的默认路径,重新构建或替换发行包时可能丢失该目录。 运行时或发行包更新时,保留外部数据、WAL 和 Raft 根目录。
PD 和 Store 应在上表对应的 provider 配置文件中修改已有 rocksdb 映射,保留其余选项:
持久路径另在 conf/application.yml 中配置,同时保留正常的网络地址和集群配置。
准备完成后的 runtime 目录权限为 0755,普通资源文件为 0644,因此使用另一个服务账号也能读取 JNI。该账号还需要组件上级目录的遍历权限;prepare 不会修改上级目录权限。
选择运行时并启动验证
在每个持有 Topling 数据库的组件启动终端中,显式选择运行时:
启动脚本默认使用该组件的 conf/toplingdb.yaml,也可用 TOPLINGDB_EASY_MIGRATE_CONF=/absolute/path/config.yaml 显式覆盖。
发行包中的 native 配置关闭 HTTP 服务,并保留 Java 写入路径要求的 memtable_as_log_index=false。
请按机器条件调整该文件;它与业务 provider、数据目录配置分别生效。
独立 Server 使用全新图时,首次启动前先初始化一次存储:
bin/init-store.sh、bin/dump-store.sh 与 bin/start-hugegraph.sh 使用同一显式运行时选择。
HStore 按 PD、Store、Server 的顺序启动。在同一 shell 中启动 HStore Server 前,执行 unset TOPLINGDB_ROCKSDB_PROVIDER
(或 export TOPLINGDB_ROCKSDB_PROVIDER=rocksdb);不要在该 Server 上启用本地 Topling。
业务 provider 与实际运行时不一致时,组件会在开库前拒绝启动。
采用前须确认实际 RocksDB Java 类和进程加载的 JNI 库来自准备好的运行时。在专用数据目录中验证真实写入、读取、正常停止和重启; HStore 还需通过 Server 执行图操作,覆盖 PD 和 Store 链路。仅构建成功、启动成功或通过标准 JNI 单元测试,不能证明 Topling 运行时已验收。
停止或切回标准 RocksDB
先停止新业务,再使用正常停止脚本。HStore 依次执行 Server 的 bin/stop-hugegraph.sh、Store 的 bin/stop-hugegraph-store.sh、
PD 的 bin/stop-hugegraph-pd.sh,等待前一个进程退出后再停止其依赖。强制终止进程不能作为正常 native 资源清理的证明。
切回标准 RocksDB 前先停止组件,取消 TOPLINGDB_ROCKSDB_PROVIDER,并把业务 provider 改回 rocksdb。
使用对应的标准 provider 数据和 WAL 路径,不要指向已被 Topling 修改的数据库。
专用 Topling 发行包、Docker/Compose 打包、通用生命周期改造及可重试快照恢复分别后续交付。 本文覆盖普通发行包的启动脚本;自定义 IDE 和嵌入式入口需要自行准备运行时并完成验证。
3 - 备份与恢复
描述
Backup 将一张图的 Schema、顶点和边导出为 JSON 数据,Restore 将这些数据导入目标图。 它们是 HugeGraph-Tools 的命令,适合图迁移、升级后的恢复及图合并。
Backup
备份可在任意图模式下执行。建议在导出前暂停源图的写入操作,以确保 Schema、顶点和边的数据一致性(分批读取不提供全局事务快照)。
注意:backup -t all 仅导出图的 Schema 和图数据,不包含系统配置文件与用户权限。
Restore
恢复数据前,需先根据目标图的状态切换恢复模式。日常读写处于 NONE 模式;注意:LOADING 模式不能用于 restore。
| 目标 | 模式 | Schema ID | 顶点和边 ID |
|---|---|---|---|
| 恢复到没有 Schema 和数据的新图 | RESTORING | 使用备份中的 ID | 使用备份中的 ID |
| 合并到已有图 | MERGING | 使用目标图的 Schema ID,必要时新建 | 部分 ID 随目标 Schema 重算,见下文 |
MERGING 中,PRIMARY_KEY 顶点 ID 按目标 label ID 重新生成,关联边的端点与 ID 随之调整。
AUTOMATIC 和自定义顶点 ID 保留。合并会复用同名 Schema,先检查双方的定义是否兼容,以及保留的顶点 ID 是否冲突。
它不提供任意 Schema 冲突或数据冲突的自动解决策略。先在独立目标图验证,再合并正式数据。
使用方法
准备与 Server 版本匹配的 HugeGraph-Tools,在 Tools 根目录执行以下命令。
本例从 8080 的源图恢复到 8081 的空目标图。两个 Server 和目标图应已创建并启动;可将变量改成实际地址及图名。
启用认证时,在每条 Tools 命令的子命令前加入 --user <user> --password <password>,并使用具备对应图读写和模式管理权限的账号。
详细参数及凭据使用方式见 Tools 参考。
Backup
暂停源图写入后,备份全部 Schema、顶点和边。
显式指定的 -d 就是备份目录,不会自动附加图名。为每次备份使用独立目录,避免混入旧文件。
保留完整目录,包括压缩文件;Restore 可读取 Tools 支持的 JSON 备份格式。
Restore
以下流程使用 RESTORING。合并时改为 MERGING,并先完成上面的兼容性检查。
操作期间暂停目标图业务写入。
查看并记录原模式,再切换。
正常业务图应处于
NONE。将查询返回的值填入ORIGINAL_MODE,例如下方的NONE。若另一项维护正在使用RESTORING、MERGING或LOADING,先协调该任务,不要覆盖其模式。恢复数据。
检查命令输出与各类型的导入结果。若发生错误,请先保留备份目录与日志,并检查目标图的数据状态。 Restore 不会自动回滚已写入的数据,切勿在部分恢复的图上盲目重跑。
还原原模式。
使用第一步记录的
ORIGINAL_MODE还原模式。无论恢复成功还是失败,最后都必须将图模式还原为原有模式(通常为
NONE)。 若恢复失败,先保留现场并排查日志,待重新准备目标图后再恢复业务写入。
还原模式后,对比两端的顶点数和边数。
两组计数结果应保持完全一致。建议进一步通过 Schema API 核对元数据定义, 并抽样检查顶点和边的属性与端点关联,确保业务数据的完整性。
帮助
更多关于压缩、并发和分类型备份的参数说明,见 Tools 参考。 在跨大版本恢复前,建议先在测试环境中验证备份文件的兼容性。
Backup/Restore使用和实现的API说明
Backup
Backup 使用 Schema、顶点和边的列表 GET API 导出数据。
Restore
Restore 使用 Schema、顶点和边的创建 API 导入数据。模式对应的 ID 行为见前面的选择表。
RESTORING 允许指定 Schema ID;MERGING 不允许指定 Schema ID。两种模式均允许保留 AUTOMATIC 顶点 ID。
普通 NONE 模式不接受这些恢复操作所需的 ID 设置。
查看某个图的模式
启用鉴权时需要图读取权限(space_member 或该图的所有者)。
Method & Url
Response Status
Response Body
合法图模式为 NONE、RESTORING、MERGING 和 LOADING。
设置某个图的模式
启用鉴权时需要图空间管理权限(space);管理员可按权限继承规则满足。
Method & Url
Request Body
合法图模式为 NONE、RESTORING、MERGING 和 LOADING。
Response Status
Response Body
4 - HugeGraph Docker 集群部署指南
概述
HugeGraph 通过 Docker-Compose 可快速运行完整的分布式集群版(PD + Store + Server)。该方式适用于 Linux 和 Mac。
前置条件
- Docker Engine 20.10+ 或 Docker Desktop 4.x+
- Docker Compose v2
- Mac 运行 3 节点集群时,建议分配至少 12 GB 内存(设置 → 资源 → 内存)。[其他平台根据实际情况调整]
已测试环境:Linux(原生 Docker)和 macOS(Docker Desktop with ARM M4)
Compose 文件
在 HugeGraph 主仓库 docker/ 目录下提供了四个 compose 文件:
| 文件 | 服务 | 适用场景 |
|---|---|---|
docker-compose.yml | 1 个 RocksDB Server + 1 个 Hubble | 默认的单机快速启动,推荐从这里开始 |
docker-compose-hstore.yml | 1 PD + 1 Store + 1 Server + 1 Hubble | 分布式本地开发 |
docker-compose-3pd-3store-3server.yml | 3 PD + 3 Store + 3 Server + 1 Hubble | HA 参考与评估 |
docker-compose.dev.yml | (仅覆盖文件) | 最小 HStore 拓扑的源码构建覆盖,始终与 docker-compose-hstore.yml 一起使用 |
单机拓扑使用 hugegraph/hugegraph:${HUGEGRAPH_VERSION:-latest};HStore 拓扑使用对应的 hugegraph/pd、hugegraph/store 和 hugegraph/server tag。Hubble 由 ${HUBBLE_IMAGE:-hugegraph/hubble:latest} 单独选择。
注: 后续步骤皆为假设你本地已拉取
hugegraph主仓库代码 (至少是 docker 目录)
本页的 HStore 与 HA Compose 操作按当前主线文件编写,必须使用从同一主线源码构建的 PD、Store 和 Server 镜像;不要把这些 Compose 文件与 1.7.0 标签的 HStore 组件镜像混用。单机示例单独固定 hugegraph/hugegraph:1.7.0 镜像标签。
鉴权环境
以下 .env 模板对应当前主线 Compose。尖括号内容和 replace-with-your-password 都是占位,必须替换为真实值后才能载入或启动;可参考主线 docker/README.md 的鉴权环境步骤生成 .env,并先替换其中的管理员密码占位:
在主线 HStore 和 HA 拓扑中,HG_PD_AUTH_SECRET_KEY 是 PD REST Basic 鉴权密码,所有 PD 节点、Server 和 Hubble 都必须使用同一个值。当前主线 PD Docker 镜像要求设置该密钥。Hubble 不会直接读取 .env,启动前还要用该值生成拓扑对应的本地配置文件,见下文。不要提交 .env 或生成的 .local.properties。
HUGEGRAPH_ADMIN_PASSWORD 非空时会以 PASSWORD 启用 Server 鉴权,Hubble 通过 Server API 自动识别该模式;该密码只在首次初始化内置 admin 账号。不设置或设为空值则关闭鉴权,这只适用于可信的本地环境。
当前主线 Compose 会把 HUGEGRAPH_AUTH_TOKEN_SECRET 传给 HG_SERVER_AUTH_TOKEN_SECRET。同一密钥可让主线多 Server 副本验证相同 token,并在容器重建后继续验证已签发 token;HA Compose 还要求显式提供该密钥。hugegraph/hugegraph:1.7.0 单机镜像的 Docker 入口脚本只根据 PASSWORD 开启鉴权,不读取 HG_SERVER_AUTH_TOKEN_SECRET,因此不要把 .env 中该变量视为该镜像的固定 JWT 配置。若在 1.7.0 中需要固定 JWT secret,请在其认证图配置 conf/graphs/hugegraph.properties 中显式设置 auth.token_secret,并确保该配置随容器替换保留;认证图路径及密钥生成说明见鉴权配置指南。
之后修改 HUGEGRAPH_ADMIN_PASSWORD 不会轮换已有密码,请使用用户 API 修改。
生产环境的组件访问控制
生产环境必须按 Server 认证与授权配置 为图 API 启用 Server Auth,启用并维护 Server IP 白名单、按最小权限授权,并保留、限制读取 Server audit-*.log。PD 的 REST 凭据与 PD/Store 的 gRPC、Raft、REST 网络边界独立配置;Server Auth 不会保护这些端口。仅向集群节点和受信运维入口开放 PD/Store 端口。
单节点快速启动
本节固定使用 hugegraph/hugegraph:1.7.0 单机镜像标签;HStore/HA 示例使用当前主线构建镜像,不能照搬本节的版本号。
验证:
Hubble 默认只发布在宿主机回环地址(127.0.0.1:8088)。只有在 HTTPS 反向代理和可信网络管控之后才应设置 HUBBLE_PUBLISH_HOST。
最小 HStore 快速启动(当前主线镜像)
从 HugeGraph Server 主线仓库根目录构建 PD、Store 和 HStore Server 镜像:
从仓库根目录执行以下命令进入 docker/,载入 .env 并生成最小拓扑所需的 Hubble 配置。缺少 hstore.local.properties 时,Compose 不会为只读 bind mount 自动创建有效配置;先生成文件再启动:
验证:
若要从本地源码构建该拓扑而不是拉取镜像,可加上开发覆盖文件,并在后续所有生命周期命令中同时带上这两个文件:
覆盖文件为本地构建生成 dev 标签的镜像;如果已经按上文构建 local 标签镜像,则使用基础 Compose 文件和 HUGEGRAPH_VERSION=local 启动,不要同时混用两个版本标签。
3 节点集群快速启动(当前主线镜像)
HA Compose 文件不包含源码构建覆盖层。先按最小 HStore 一节从同一主线源码构建 hugegraph/pd:local、hugegraph/store:local 和 hugegraph/server:local,然后在 docker/ 目录载入 .env,生成 HA Hubble 配置并启动:
HA Hubble bind-mount conf/hubble/hstore-ha.local.properties;必须在启动前生成。该文件与最小 HStore 使用的 hstore.local.properties 分开生成,但两者从同一 .env 读取同一个 HG_PD_AUTH_SECRET_KEY。
默认内置的启动顺序:
- PD (节点)最先启动,且必须通过
/v1/health健康检查 - Store (节点)在所有 PD 健康后再启动
- Server (节点)在所有 Store + PD 健康后最后启动
验证集群正常:PD 的 /v1/health 和 /v1/ready 是无需认证的探针;查询 Store 注册和分区数据属于受保护的 PD REST 管理接口,需用用户名 hg 和 .env 中的 HG_PD_AUTH_SECRET_KEY 进行 Basic 认证。
开启鉴权后,图列表接口应拒绝匿名请求并接受管理员:
另外两个 Server 分别在 8081 和 8082 上提供服务,其余 PD 和 Store 节点分别在 8621/8622 和 8521/8522。
环境变量参考
以下 PD、Store、Server 和 Compose 变量表描述当前主线镜像入口及 Compose 文件,不是 hugegraph/hugegraph:1.7.0 单机镜像的环境变量契约。PD 和 Store 的入口脚本会把各自的变量拼成 SPRING_APPLICATION_JSON,并在启动时打印部分非敏感配置摘要;PD 密钥不会打印在该摘要中。docker logs 可用于核对日志列出的配置项,但不要以日志中未显示密钥来判断是否生效。Server 的入口脚本则直接改写 conf/graphs/hugegraph.properties 和 conf/rest-server.properties 中的键。
PD 变量
| 变量 | 必填 | 默认值 | 映射配置 |
|---|---|---|---|
HG_PD_GRPC_HOST | 是 | (无) | grpc.host |
HG_PD_RAFT_ADDRESS | 是 | (无) | raft.address |
HG_PD_RAFT_PEERS_LIST | 是 | (无) | raft.peers-list |
HG_PD_INITIAL_STORE_LIST | 是 | (无) | pd.initial-store-list |
HG_PD_GRPC_PORT | 否 | 8686 | grpc.port |
HG_PD_REST_PORT | 否 | 8620 | server.port |
HG_PD_DATA_PATH | 否 | /hugegraph-pd/pd_data | pd.data-path |
HG_PD_INITIAL_STORE_COUNT | 否 | 1 | pd.initial-store-count |
HG_PD_AUTH_SECRET_KEY | 是(当前主线 Docker) | 无 | auth.secret-key;PD REST Basic 密码,也供 Server 与 Hubble 使用 |
已弃用的别名:
GRPC_HOST→HG_PD_GRPC_HOST、RAFT_ADDRESS→HG_PD_RAFT_ADDRESS、RAFT_PEERS→HG_PD_RAFT_PEERS_LIST、PD_INITIAL_STORE_LIST→HG_PD_INITIAL_STORE_LIST。只有当新名称未设置时才会把旧名称映射过去,并打印一条警告日志。任一必填变量缺失时,入口脚本以退出码 2 退出。
Store 变量
| 变量 | 必填 | 默认值 | 映射配置 |
|---|---|---|---|
HG_STORE_PD_ADDRESS | 是 | (无) | pdserver.address |
HG_STORE_GRPC_HOST | 是 | (无) | grpc.host |
HG_STORE_RAFT_ADDRESS | 是 | (无) | raft.address |
HG_STORE_GRPC_PORT | 否 | 8500 | grpc.port |
HG_STORE_REST_PORT | 否 | 8520 | server.port |
HG_STORE_DATA_PATH | 否 | /hugegraph-store/storage | app.data-path |
HG_STORE_ROCKSDB_TOTAL_MEMORY_SIZE | 否 | 无 | rocksdb.total_memory_size,auto 或字节数 |
已弃用的别名:
PD_ADDRESS→HG_STORE_PD_ADDRESS、GRPC_HOST→HG_STORE_GRPC_HOST、RAFT_ADDRESS→HG_STORE_RAFT_ADDRESS
RocksDB 缓存使用堆外内存。未设置 HG_STORE_ROCKSDB_TOTAL_MEMORY_SIZE 时,系统将优先根据容器内存限制(cgroup)自动计算;未配置容器限制时则按宿主机内存推导。
由于默认 Docker Compose 未限制容器内存,各 Store 均会以宿主机整机容量估算;若单机部署多个 Store,建议显式配置容器内存限制,或直接为该变量指定字节数。
此外,Store 启动脚本默认会根据系统空闲内存分配 JVM 堆与直接内存(上限各 2 GiB)。建议结合容器规格,通过 JAVA_OPTS 显式约束 JVM 内存(例如容器为 4 GiB 时配置 JAVA_OPTS="-Xmx1g -XX:MaxDirectMemorySize=512m")。详细推导公式见 HStore 配置参考。
Server 变量
与 PD、Store 不同,Server 入口脚本没有必填变量:只有实际设置了的变量才会被写入配置文件。但分布式部署至少需要 HG_SERVER_BACKEND 和 HG_SERVER_PD_PEERS。
| 变量 | 默认值 | 映射配置 |
|---|---|---|
HG_SERVER_BACKEND | 模板取值(rocksdb,在 hugegraph/server 镜像中为 hstore) | conf/graphs/hugegraph.properties 中的 backend |
HG_SERVER_PD_PEERS | (无) | hugegraph.properties 和 rest-server.properties 中的 pd.peers |
HG_SERVER_USE_PD | false | rest-server.properties 中的 usePD |
HG_SERVER_CLUSTER | hg-test | rest-server.properties 中的 cluster |
HG_SERVER_REST_URL | http://0.0.0.0:8080(镜像中已设置) | restserver.url |
HG_SERVER_URLS_TO_PD | http://0.0.0.0:8080 | server.urls_to_pd:本 Server 注册到 PD 的地址列表(逗号分隔),代替 restserver.url;仅在 server.deploy_in_k8s 为 true 时生效;每个地址都要自带 http:// 前缀,系统只会给第一个地址补上;其中的空白字符会被去除 |
HG_SERVER_DEPLOY_IN_K8S | false | rest-server.properties 中的 server.deploy_in_k8s |
HG_SERVER_MIN_FREE_MEMORY | 64(MB) | restserver.min_free_memory |
HG_SERVER_INIT_STORE_ENABLED | true | init_store.enabled;元数据由存储侧管理的 PD/HStore 部署应设为 false |
HG_SERVER_AUTH_TOKEN_SECRET | 设置了 PASSWORD 时自动生成 | 两个配置文件中的 auth.token_secret,至少 32 字节 |
HG_SERVER_REQUIRE_AUTH_TOKEN_SECRET | false | 为 true 时,只设置 PASSWORD 而未设置 HG_SERVER_AUTH_TOKEN_SECRET 则拒绝启动 |
PASSWORD | (无) | auth.admin_pa,并执行 bin/enable-auth.sh 开启鉴权模式 |
PRELOAD | (无) | 为 true 时从 scripts/example.groovy 预加载示例图 |
JAVA_OPTS | 镜像中已设置 | 传给 bin/start-hugegraph.sh -j |
HG_SERVER_STARTUP_TIMEOUT_S | 120(秒) | 传给 bin/start-hugegraph.sh -t,允许范围为 1–86400;详见下文的 Server 启动等待超时 |
STORE_REST | store:8520 | wait-partition.sh 轮询的 Store REST 地址,仅 hstore 后端使用 |
HG_SERVER_PD_REST_ENDPOINT | 由 pd.peers 把 :8686 改写为 :8620 得到 | wait-storage.sh 轮询的 PD REST 地址 |
PD_AUTH_USER | store | wait-storage.sh 访问 PD REST API 的 Basic 用户名 |
PD_AUTH_PASSWORD | 空 | PD REST Basic 密码;启用 PD REST 鉴权时须与 HG_PD_AUTH_SECRET_KEY 相同 |
WAIT_PARTITION_TIMEOUT_S | 120 | 分区轮询超时;包含下文修复的构建还会限制最终诊断 |
包含鉴权属性修复的 master 镜像会保留显式签名密钥中的空格、反斜杠和 Unicode,各 Server 副本应使用同一密钥。
如果旧镜像曾错误读取这类密钥,升级时应重新显式提供原本想使用的 HG_SERVER_AUTH_TOKEN_SECRET;仅复用旧配置仍会保留错误读取后的密钥。
若实际生效的密钥改变,须重新登录获取 token。上文所述 1.7.0 镜像限制仍适用。
旧镜像在初始化程序继承 C locale 时,可能错误初始化 Unicode 管理员密码。升级或再次设置 PASSWORD 不会修复已有账号存储的密码,
须由仍可登录的管理员通过用户 API修改。若已无可用管理员身份,本修复不提供自动恢复;应保留现有数据,安排账号恢复后再升级。
已弃用的别名:
BACKEND→HG_SERVER_BACKEND、PD_PEERS→HG_SERVER_PD_PEERS
wait-storage.sh 最多等待 300 秒直到出现状态为 Up 的 Store。该时长写死在脚本中,无法通过环境变量调整。
在当前 master Server 构建中,HStore 启动时,分区轮询和最终
/v1/partitions 诊断分别使用独立的 WAIT_PARTITION_TIMEOUT_S 预算。旧构建仅限制轮询时间,最终诊断请求没有超时。
使用默认配置时,最终响应停滞会在 120 秒后超时;设为 0 会禁用 GNU timeout 的时限。
入口脚本在等待 Java 进程前会先等待 wait-partition.sh。若 Java 进程在分区轮询阶段提前退出,轮询仍可能消耗完整超时预算后入口脚本才感知到退出;
若轮询成功,后续的最终诊断也可能再次消耗完整的超时预算。信号触发的关闭仍可正常中断检查。
HG_SERVER_INIT_STORE_ENABLED 和 HG_SERVER_DEPLOY_IN_K8S 只接受 HugeConfig 能识别的写法(忽略大小写):y、t、yes、on、true、n、f、no、off、false。其他取值(包括 0 和 1)都会让入口脚本终止。
入口脚本在初始化成功后写入 docker/init_complete,后续启动会跳过重新初始化,但仍会再执行一次 bin/init-store.sh,以便关闭状态下每次启动都重新校验配置。
Compose 变量
以下变量由 Compose 文件读取,而非入口脚本:
| 变量 | 默认值 | 用途 |
|---|---|---|
HUGEGRAPH_VERSION | latest | Server、PD 和 Store 的镜像 tag |
HUGEGRAPH_PULL_POLICY | missing | 上述镜像的 pull_policy,使用 never 可保留本地构建的镜像 |
HUBBLE_IMAGE | hugegraph/hubble:latest | Hubble 镜像,与 HUGEGRAPH_VERSION 独立选择 |
HUBBLE_PULL_POLICY | missing | Hubble 镜像的 pull_policy |
HUBBLE_PUBLISH_HOST | 127.0.0.1 | Hubble 8088 端口发布到的宿主机网卡 |
HUGEGRAPH_ADMIN_PASSWORD | (无) | 以 PASSWORD 传给 Server |
HUGEGRAPH_AUTH_TOKEN_SECRET | (无) | 当前主线 Compose 以 HG_SERVER_AUTH_TOKEN_SECRET 传给 Server;1.7.0 镜像不读取该变量 |
HG_PD_AUTH_SECRET_KEY | (无) | HStore 拓扑 PD REST Basic 密码;由 Compose 传给 PD 和 Server,并用于生成 Hubble 本地配置 |
端口参考
3 节点集群发布的端口:
| 服务 | 宿主机端口 | 容器端口 | 用途 |
|---|---|---|---|
| pd0 | 8620 | 8620 | REST API |
| pd0 | 8686 | 8686 | gRPC |
| pd1 | 8621 | 8620 | REST API |
| pd1 | 8687 | 8686 | gRPC |
| pd2 | 8622 | 8620 | REST API |
| pd2 | 8688 | 8686 | gRPC |
| store0 | 8500 | 8500 | gRPC |
| store0 | 8510 | 8510 | Raft |
| store0 | 8520 | 8520 | REST API |
| store1 | 8501 | 8500 | gRPC |
| store1 | 8511 | 8510 | Raft |
| store1 | 8521 | 8520 | REST API |
| store2 | 8502 | 8500 | gRPC |
| store2 | 8512 | 8510 | Raft |
| store2 | 8522 | 8520 | REST API |
| server0 | 8080 | 8080 | Graph API |
| server1 | 8081 | 8080 | Graph API |
| server2 | 8082 | 8080 | Graph API |
| hubble | 8088 | 8088 | Hubble 界面,默认绑定 127.0.0.1 |
单机拓扑只发布 8080 和 8088;最小 HStore 拓扑发布 8620(PD REST)、8520(Store REST)、8080 和 8088。PD Raft 使用网络内的 8610,所有拓扑都不对外发布。
故障排查
容器 OOM 退出(exit code 137):将 Docker Desktop 内存增加到 12 GB 以上 (或调整被 kill 的启动 jvm 内存设置)
Raft 选举超时:检查所有 PD 节点的
HG_PD_RAFT_PEERS_LIST是否一致。验证连通性:docker exec hg-pd0 ping pd1分区分配未完成:在
docker/目录先载入.env,再用 PD REST Basic 认证检查 Store:3 个 Store 都显示
"state":"Up"后,PD 才能为集群完成分区分配。连接被拒:确保
HG_*环境变量使用容器主机名(pd0、store0),而非127.0.0.1数据在意料之外地保留了下来:
docker compose down会保留命名卷。要同时删除该拓扑的数据,请使用docker compose down -v升级到 master 构建的镜像后出现
Permission denied:基于当前 master 构建的 PD、Store 和 Server 镜像以非 root 用户hugegraph(UID/GID10001)运行。 旧镜像以 root 运行,写入的卷仍归 root 所有。先执行docker compose down(不要用down -v),对每个数据卷执行一次属主变更,再重新启动:不要对运行中的容器直接执行
up -d升级:Compose 会重新挂载保存旧镜像应用目录(归 root 所有)的匿名卷。请先执行down,或使用up -d --renew-anon-volumes。 作为 bind mount 的宿主机目录必须对 UID10001可写;旧镜像写入过的目录需要执行sudo chown -R 10001:10001 <dir>,因为其中的文件仍归 root 所有。在 Kubernetes 上,Pod 安全上下文需要fsGroup: 10001,Helm Chart 已为 PD 和 Store 设置,参见 Helm 升级和验证。
查看运行时日志:使用 docker logs <container-name>(如 docker logs hg-pd0)可直接查看日志,无需进入容器。基于当前 master 构建的 PD、Store 以及两个 Server 镜像(hugegraph/hugegraph 和 HStore 的
hugegraph/server)都设置了 STDOUT_MODE=true,服务日志会输出到容器 stdout。对 Server 而言,Hadoop、ZooKeeper、SOFA、Netty 和 Commons 的 WARN 及以上日志也会输出到 stdout;Hadoop、Netty 和 Commons 的
INFO 日志以及审计日志、慢查询日志仍只写入文件,ZooKeeper 和 SOFA 不输出 WARN 以下的日志。/hugegraph-server/logs 中包含 hugegraph-server.log、JVM
崩溃日志(hs_err_pid*.log)和内存溢出时的堆转储(heapdump_*/java_pid*.hprof,每次启动一个目录,Server 及其启动的 JVM 分别写入各自的文件,除非某个 JVM 复用了同一次启动中先前的 PID;如果无法创建该目录,转储会直接写入
/hugegraph-server/logs)。两个镜像都声明了 VOLUME /hugegraph-server,因此 docker restart 和 Compose 重新创建容器都会保留这些文件;docker compose down 会留下这个匿名卷,下一次 up 不会再挂载它,之后执行
down -v 也不会删除它(请在 down 之前用 docker inspect 记下卷名,再用 docker volume rm <name> 删除;docker volume prune 会同时删除 Docker
主机上所有其他未使用的匿名卷),所以请使用具名卷或绑定挂载来保留这些文件。Kubernetes 每次重启都会新建容器,因此需要在 /hugegraph-server/logs 挂载 emptyDir 或 PersistentVolumeClaim。请为每个 Pod 使用单独的卷,或在共享 PVC 上为每个
Pod 使用单独的目录(subPathExpr: $(POD_NAME),并通过 Downward API 从 metadata.name 传入 POD_NAME;Helm Chart 两者都没有设置):崩溃文件的名字各不相同,但日志文件本身的名字是固定的。只有当存储支持多个节点同时读写挂载(通常是
ReadWriteMany)时,不同节点上的 Pod 才能共享同一个 PVC;ReadWriteOnce 的 PVC 只能被一个节点读写挂载,否则请为每个 Pod 使用单独的 PVC。Helm Chart 目前还不会挂载日志卷。堆转储可能和 JVM 堆一样大,而且每次启动都会使用新目录,因此反复内存溢出的
Server 会把卷写满;请按需要保留的转储数量规划卷大小,并确保不超过 ephemeral-storage 限制或 emptyDir 的 sizeLimit(被驱逐时 emptyDir 会连同转储一起删除),也不要使用 medium: Memory。存活探针失败后,容器最早可能在转储开始后约
(failureThreshold - 1) × periodSeconds + timeoutSeconds 被重启,kubelet 最多再等待 terminationGracePeriodSeconds
就会终止它;请让这段时间长于写入一次堆转储所需的时间,否则在写转储的过程中重启会留下不完整的文件。启动脚本从不删除转储或 heapdump_* 目录,因为 computer 任务的 JVM 可能在 Server 退出后仍在使用它;每次启动到 Java 阶段都会留下一个目录,除非发生内存溢出否则为空。在该次启动的
HugeGraph JVM 都已退出后可以删除旧目录,但不要动正在运行的 Server 最新的那个目录。要对所有 JVM 关闭堆转储,请在容器的环境变量中设置 JAVA_TOOL_OPTIONS=-XX:-HeapDumpOnOutOfMemoryError(可以使用 docker run -e,或在
Compose 中 Server 服务的 environment: 里添加,自带的 Compose 文件没有设置它,或在 Kubernetes 中使用 env;只在宿主机 shell 中导出不会生效),这样会保留镜像默认的 JAVA_OPTS;把该参数加到 JAVA_OPTS 中只对 Server
自身的 JVM 生效,而且会替换镜像默认值(-XX:+UseContainerSupport -XX:MaxRAMPercentage=50 ...),需要把这些参数一并写上。
版本范围:上文描述的是基于当前 master 构建的镜像。1.7.0 及更早的镜像都没有设置
STDOUT_MODE,包括上文使用的单机镜像hugegraph/hugegraph:1.7.0:docker logs只能看到入口脚本的输出,服务日志仍在容器内的logs/中(Server 为logs/hugegraph-server.log)。
容器监控与健康检查
版本说明:本节描述当前主线 Docker 镜像的行为,不包含在
1.7.0镜像中。可使用上文从主线构建并标记为local的镜像,或包含这些改动的latest镜像。
进程监控模型
此前,三个 Docker 入口脚本均以 tail -f /dev/null 结尾,即使 Java 进程崩溃,容器仍会保持运行状态。由于容器从未退出,Docker 的 restart: unless-stopped 策略也不会触发。
现在,入口脚本直接监控 Java 进程:
- PD 和 Store 容器:入口脚本向启动脚本传入
-d false参数,启动脚本通过exec直接替换为 Java 进程。容器进程即为 Java 进程,当 Java 退出(崩溃或正常关闭)时,容器立即退出,Docker 的重启策略随即触发。 - Server 容器:入口脚本持有前台 launcher 并等待 Java。服务就绪后保留 Java 的实际退出码,包括
0、42和SIGKILL对应的137。SIGTERM和SIGINT请求协作关闭、回收持有的就绪/分区检查进程,并在关闭后分别返回143和130。 - 所有镜像中的 PID 1 均为
dumb-init,负责将 Docker 信号转发给入口脚本进程。
Server 启动等待超时
HG_SERVER_STARTUP_TIMEOUT_S 设置 Docker 入口脚本等待 REST 就绪的期限,未设置时默认 120 秒。取值必须是不带前导零的十进制整数,范围为 1–86400 秒。空字符串、0、负数、小数和超出范围的值都会使入口脚本记录错误并以退出码 1 退出。
入口脚本也通过 bin/start-hugegraph.sh -t 传入该值;前台 launcher 本身等待 Java,不轮询 REST。
启动期限失败、或 Java 在就绪前以 0 退出时,入口脚本返回 1;提前以非零码退出则保留该退出码。
此时长不包括此前的存储初始化或等待后端就绪的时间。关闭时可以中断就绪和分区检查;启动期限失败会请求终止 Java 并返回,不增加无限等待。
未响应终止请求的 Java 进程仍依靠容器终止完成最终清理。
例如,在 HugeGraph 仓库的 docker/ 目录下,将单机 Server 的启动等待时间增加到 300 秒(Compose 文件会将该变量传入容器):
该设置与 Docker 健康检查的 start_period、interval、timeout 和 retries 相互独立。健康检查参数决定何时将容器标记为 unhealthy;仅增加健康检查的等待时间,不会延长 Server 启动脚本的等待期限。调整此变量也不会自动修改健康检查参数,启动较慢时应分别检查这两组设置。
健康检查端点
所有四个 Docker 镜像现已内置 HEALTHCHECK 指令。docker ps 将显示真实的健康状态。在 90 秒的启动期内,检查失败不计入统计;此后,连续三次失败将把容器标记为 unhealthy。
| 镜像 | 健康检查端点 | 端口 | 参数 |
|---|---|---|---|
hugegraph/hugegraph(单机 RocksDB Server) | GET /versions | 8080 | --interval=15s --timeout=10s --start-period=90s --retries=3 |
hugegraph/server(HStore Server) | GET /versions | 8080 | 同上 |
hugegraph/pd | GET /v1/health | 8620 | 同上 |
hugegraph/store | GET /v1/health | 8520 | 同上 |
Compose 文件在此之上还定义了自己的健康检查,因此 --wait 和 depends_on: condition: service_healthy 不依赖镜像内置的检查。Compose 中的检查使用更短的启动期(视服务和拓扑为 30 到 120 秒)和更多的重试次数。
注意:
start-hugegraph.sh中的-m true标志(基于 cron 的监控)仅适用于虚拟机/裸机部署,Docker 镜像中未安装也不使用该功能。Docker 用户应依赖内置的HEALTHCHECK和 Docker 重启策略。
5 - FAQ
部署与启动
如何选择 RocksDB 或 HStore
开发测试或中小规模单机部署推荐选择 Server + RocksDB,部署轻便且性能优异。当数据规模较大(如 TB/PB 级)、需要水平扩容或多副本高可用时,推荐部署 HStore 分布式集群(PD + Store + Server)。
1.7.0 支持 RocksDB、HStore、HBase 和 Memory。Cassandra、ScyllaDB、MySQL、PostgreSQL 等旧后端需使用低于 1.7.0 的版本。 部署步骤见 Server 快速开始。
启动时出现 core dumped 怎么查
先执行 java -version 确认 JDK 版本:HugeGraph master 分支(以 1.8 为基线)要求 Java 17,1.7.0 要求 Java 11(已不再支持 Java 8)。
若 JDK 版本正确,进一步查看 Server 日志及 JVM 崩溃日志(hs_err_pid*.log),排查是否由于系统架构不匹配、依赖的动态库(如 RocksDB JNI)缺失或系统内存不足引起。
哪些后端需要 init-store
使用 RocksDB 或 HBase 等本地持久化后端时,首次启动前必须执行 bin/init-store.sh 进行初始化。Memory(内存后端)和 HStore(分布式后端)无需执行此脚本,HStore 的存储由 PD 和 Store 统一管理。
注意:backend 与 serializer 必须配套使用(例如 RocksDB 配套 binary),不可随意替换。若服务启动后提示无法连接后端,请优先检查是否完成初始化以及后端存储配置是否正确。
init-store 报 GLIBCXX 版本缺失怎么办
出现以下报错表示当前系统的 libstdc++ 版本过低,缺少 RocksDB JNI 本地库所需的符号:
解决方法:核对发行包支持的系统架构,升级系统的 libstdc++(或安装较新的 GCC 运行库),或者直接使用官方提供的 Docker 镜像运行。
应该使用哪个 Server 启动脚本
当前发行包统一使用 bin/start-hugegraph.sh,GremlinServer 与 REST Server 会在同一个进程中启动。旧版本文档中的 start-restserver.sh 和 start-gremlinserver.sh 已废弃。
启动脚本会加载哪些图
脚本名称与加载的图无关。Server 默认会扫描并加载 conf/graphs 目录下的所有图配置(可在 conf/rest-server.properties 中的 graphs 修改该目录)。每张本地图使用独立的配置文件,修改配置后需重启 Server。
注:graph.load_from_local_config 默认为 false(控制构造阶段预加载),不能用来禁止启动时加载本地图。详见服务端配置说明。
连接与查询
curl 返回乱码怎么办
批量顶点和边接口默认会返回 gzip 压缩数据。使用 curl 请求时加上 --compressed 参数即可自动解压:
若开启了认证,需同时传入凭据。若返回内容仍不符合预期,请检查 HTTP 状态码、Content-Type 与 Content-Encoding,不要把 JSON 报错直接管道传给 gunzip。
按顶点 ID 查询却找不到顶点
先从已有查询结果中确认 id 的实际格式和类型:字符串 ID 需要 JSON 双引号,数值 ID 不需要。例如字符串 ID 1:marko 的 JSON 格式应为 "1:marko"。
在把 ID 放入 URL 路径时,必须对包含双引号在内的完整字符串进行 URL 编码。若 ID 含有特殊字符,不能仅补双引号而遗漏编码:
| 字符 | URL 编码 |
|---|---|
+ | %2B |
| 空格 | %20 |
/ | %2F |
? | %3F |
% | %25 |
# | %23 |
& | %26 |
= | %3D |
" | %22 |
按类型查询顶点或边时超时
当某个标签下的数据量很大时,全量扫描很容易耗尽资源导致超时。建议优化方式:
- 加上
limit()限制返回记录数; - 使用分页机制分批读取;
- 配合具体属性过滤,并确保对应属性已建立索引,避免全表扫描。
REST 请求正常,Gremlin 返回 500
REST 接口正常仅说明 HTTP 入口可用,Gremlin 执行返回 500 通常有以下原因:
- Gremlin Server 连接异常:检查
conf/rest-server.properties中的gremlinserver.url是否指向可达的 Gremlin 端口(默认8182,对应conf/gremlin-server.yaml); - 语句语法或逻辑错误:例如未加索引导致遍历被拦截;
- 认证凭据缺失或过期。
建议查看 logs/hugegraph-server.log 中的异常堆栈定位具体报错。
REST 请求返回 HTTP 415
发送带请求体的 POST/PUT 请求时,需在请求头中指定 Content-Type: application/json,并确保请求体是合法的 JSON 格式。
导入与数据维护
Loader 出现 Socket Timeout
导入超时通常由于单批次写入过大或并发压力过高导致。建议:
- 适当调小
--batch-size(如由 500 降为 200); - 适当降低并发线程数;
- 调大
--timeout并配置重试机制。参数说明见 Loader 指南。
如何清空一张图
管理员可调用以下接口清空指定图的 Schema、顶点、边和索引(执行前请务必确认目标图并做好备份):
请求需携带 confirm_message 查询参数,值必须严格等于 I'm sure to delete all data(需进行 URL 编码)。完整调用方式见 Graph API。
清理底层存储后,为什么仍提示 Schema 已存在
Server 在内存中维护了 Schema 缓存。如果直接绕过 Server 清理底层存储(如清空 RocksDB 目录或 HBase 表),Server 缓存与实际存储将出现不一致。 若已手动清理底层,必须重启 Server。日常清理建议使用官方提供的 Clear 图 API。
建模与 ID
顶点或边 ID 超过长度限制
为保证底层存储与索引性能,HugeGraph 对 ID 长度作了如下限制(按编码后的字节数计算):
- 顶点 ID:最长 16384 字节(16 KB);
- 边 ID:最长 65536 字节(64 KB)。
建议使用简洁的业务唯一标识作为主键,避免在 ID 中拼接大段文本。注:属性索引值超过 32 字节时会自动转为哈希存储,不会报错超长。
是否支持嵌套属性
目前不支持嵌套属性(复杂对象或嵌套 Map)。如果需要表达多层级关系,建议将嵌套对象拆分成独立的顶点,通过边与主体顶点相连。
一个边类型能连接多组顶点类型吗
支持。创建 EdgeLabel 时,对每一组起点和终点类型分别调用一次 link(sourceLabel, targetLabel) 即可。
例如“投资”关系可以同时连接“个人 → 企业”和“企业 → 企业”。旧版 sourceLabel() 与 targetLabel() 只支持单一配对,现已废弃。
其他问题可搜索 Server issues 或 Toolchain issues。
6 - 报告安全问题
报告 Apache HugeGraph 的安全问题
生产环境安全要求
HugeGraph 默认不启用用户认证。生产环境必须启用认证与授权、将 white_ip.status 设为 enable 并启用和维护 IP 白名单,同时按最小权限为账号授权;不得将 Gremlin、Cypher 等查询接口直接暴露到公网。白名单管理方式见 IP 白名单 API。生产部署还必须隔离 Server 进程,可使用 Docker 或 Kubernetes 等容器环境。
Server 标准配置将鉴权代理的审计记录写入 audit-*.log。部署时必须保留并限制这些日志的读取权限。auth.audit_log_rate 只控制每用户的最大日志输出速率,不是审计日志的启停开关。
漏洞报告范围
近期社区已收到较多关于图查询语言灵活性的安全反馈。在 HugeGraph 安全体系整体重构完成前,对于在不启用或跳过 Auth 系统/避开授权身份的前提下执行 DSL 查询的情况,此类已知风险将不再单独视为新漏洞进行处理。
如果在已开启 Auth 系统的环境中仍能以匿名或未授权身份访问并利用漏洞,或者成功绕过 IP 白名单 / 逃逸容器造成严重越权或底层系统破坏,仍属于高危安全漏洞,欢迎向社区报告。
遵循 ASF 的规范,HugeGraph 社区对解决修复项目中的安全问题保持非常积极和开放的态度。
我们强烈建议用户首先向我们的独立安全邮件列表报告此类问题,相关详细的流程规范请参考 ASF SEC 守则。
请注意,安全邮件组适用于报告未公开的安全漏洞并跟进漏洞处理的过程。常规的软件 Bug/Error 报告应该使用 Github Issue/Discussion 或是 HugeGraph-Dev 邮箱组。发送到安全邮件组但与安全问题无关的邮件将被忽略。
独立的安全邮件 (组) 地址为: security@hugegraph.apache.org
安全漏洞处理大体流程如下:
- 报告人私下向 Apache HugeGraph SEC 邮件组报告漏洞 (尽可能包括复现的版本/相关说明/复现方式/影响范围等)
- HugeGraph 项目安全团队与报告人私下合作/商讨漏洞解决方案 (初步确认后可申请
CVE编号予以登记) - 项目创建一个新版本的受漏洞影响的软件包,以提供修复程序
- 合适的时间可公开漏洞的大体问题 & 描述如何应用修复程序 (遵循 ASF 规范,公告中不应携带复现细节等敏感信息)
- 正式的 CVE 发布及相关流程同 ASF-SEC 页面
已发现的安全漏洞 (CVEs)
HugeGraph 主仓库 (Server/PD/Store)
- CVE-2024-27348: HugeGraph-Server - Command execution in gremlin
- CVE-2024-27349: HugeGraph-Server - Bypass whitelist in Auth mode
- CVE-2024-43441: HugeGraph-Server - Fixed JWT Token (Secret)
- CVE-2025-26866: HugeGraph-Server - RAFT and deserialization vulnerability
HugeGraph-Toolchain 仓库 (Hubble/Loader/Client/Tools/..)
- CVE-2024-27347: HugeGraph-Hubble - SSRF in Hubble connection page
7 - 1.8.0 共享基础模块迁移指南
1.8.0 共享基础模块迁移会改变 Java import 和扩展接口的签名,Server、PD、Store 也需要一起升级。 先根据集成方式找出受影响代码,再重新构建应用,并在部署前检查已有数据。
先确定需要调整的部分
| 你的集成方式 | 需要准备什么 |
|---|---|
| Java 代码使用 Server 的 ID、schema 元数据、查询或索引 | 调整 import 和受影响签名,使用配套的 1.8.0 依赖包重新编译。 |
自定义序列化器、HugeGraph 实现或元素子类 | 按下方说明修改 SPI 契约和共享元素状态的适配。 |
| 自定义 Gremlin import 或脚本 | 替换旧 IdGenerator 类名,并验证发行包中的 Gremlin 服务启动。 |
| Hubble、Java client 或 Computer 集成 | 配套依赖包可用后,应用对应的异常类调整。 |
| HStore 部署 | 对齐 PD 命名空间,检查旧的 Store 重建索引,同步升级所有写入端。 |
| Loader 或其他仅通过 REST 调用的集成 | 保留独立 client DTO,按实际使用情况迁移受影响的 Java 调用。 |
该共享基础模块重构面向 1.8.0 目标版本。 升级时请使用配套的 Server、PD、Store 发行包及下游依赖。 Java 映射和兼容性样本见源码迁移指南。
共享代码现在由谁维护
此前 Server core 和 struct 分别维护了部分 ID、schema 类型、查询、元素和编解码实现。
迁移后,这些共享类型统一由一个模块维护,Server 和 Store 使用同一份实现。
hugegraph-core 继续运行图引擎,hugegraph-struct 提供共享模型和编解码,hugegraph-common 提供通用工具。
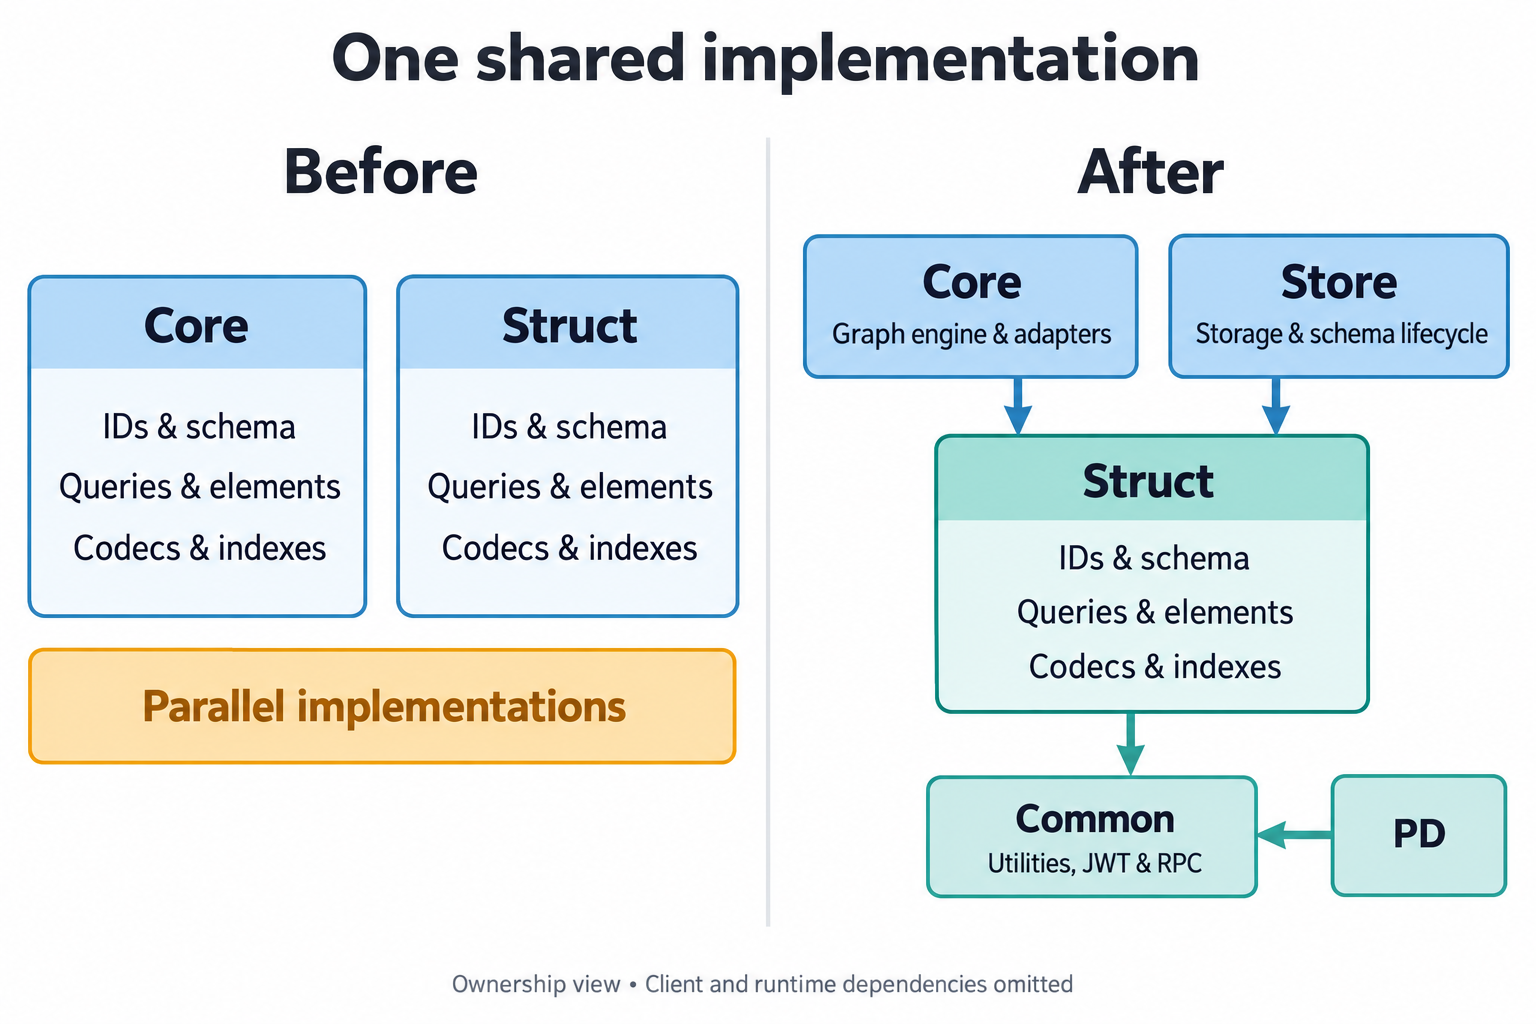
Core 保留图执行和适配器,Store 保留存储和 schema 生命周期,struct、common 统一维护共享实现。 箭头描述共享职责,不包含完整依赖树。
| 维护模块 | 职责 |
|---|---|
| struct | ID、schema 元数据、类型码、查询、基础元素、属性和字节编解码、索引构建及分词器 |
| core | 事务、遍历、任务、schema 修改、后端适配器及索引更新编排 |
| Store | 通过 SchemaGraph/SchemaDriver 管理基于 PD 的 schema 访问、监听器和缓存生命周期 |
| common | JWT 签名与校验、共享认证常量和 RPC 配置接口 |
Server 的 HStore 适配器仍需要 PD、Store 客户端,Store 保留网络、PD 客户端及存储库。 PD、Store 不应依赖 core,struct 不应依赖 core 或 PD 客户端。
Core、Store 实现 HugeGraphSupplier,提供 schema、配置和时钟访问能力。
共享基础元素持有状态和邻接关系,HugeVertex、HugeEdge 保留引擎行为及基于同一状态的包装对象身份。
属性修改、克隆、删除、过期和加载状态都应通过这份共享状态传递。
Core 序列化器保留后端适配逻辑,委托共享代码完成编解码。
共享索引和 OLAP 选择接收调用方提供的 schema 候选及结果接收器,事务写入和后端能力检查仍由 core 执行。
调整 Java 源码和 SPI 实现
先检查代码实际使用的类型。以下 ID 构造调用保留相同的字符串值,只需要迁移 import。
调整前,使用 1.7.0 core API
调整后,使用共享 API
调整源码后,重新编译应用和插件。迁移后的类型同时改变了方法描述符,仅修改 import 不能让旧的已编译 jar 具备二进制兼容性。 被移除的 core 类没有通用兼容包。插件示例仍描述 1.7.0 API,接入迁移后的 API 时按下表调整。
| 原 Java 入口 | 迁移后的入口 |
|---|---|
org.apache.hugegraph.backend.id 中下方列出的共享类型 | org.apache.hugegraph.id.* |
org.apache.hugegraph.schema.* 元数据 | org.apache.hugegraph.struct.schema.* |
org.apache.hugegraph.backend.query 中下方列出的共享类型 | org.apache.hugegraph.query.* |
org.apache.hugegraph.backend.query.serializer.* | org.apache.hugegraph.query.serializer.* |
org.apache.hugegraph.backend.store.Shard | org.apache.hugegraph.backend.Shard |
org.apache.hugegraph.backend.store.BackendEntry.BackendColumn | org.apache.hugegraph.backend.BackendColumn |
org.apache.hugegraph.structure.HugeIndex | org.apache.hugegraph.structure.Index |
| 后端序列化器中的共享字节与编码逻辑 | org.apache.hugegraph.serializer.* |
Core HugeException | org.apache.hugegraph.exception.HugeException |
org.apache.hugegraph.SchemaGraph/SchemaDriver | org.apache.hugegraph.store.schema.* |
ID 包只迁移 Id、IdGenerator、EdgeId、IdUtil、SplicingIdGenerator。
SnowflakeIdGenerator 保留在 core 的 org.apache.hugegraph.backend.id,继续使用原 import。
查询包迁移 Query、ConditionQuery、Condition、IdQuery、IdPrefixQuery、IdRangeQuery、BatchConditionQuery、Aggregate。
QueryResults、ConditionQueryFlatten、EdgesQueryIterator、QueryBatch、QueryResultContext 保留在 core 的
org.apache.hugegraph.backend.query,继续使用原 import。
SchemaManager、Schema 修改 builder 和后端专用序列化器仍在 core,需按实际受影响类型应用表中的映射。
客户端 REST DTO 保持独立,包括 Toolchain 的 org.apache.hugegraph.structure.graph.Shard。
| 扩展点 | 实现需要怎样调整 |
|---|---|
HugeGraph.sameAs(HugeGraph) | Override 改为 sameAs(org.apache.hugegraph.HugeGraphSupplier),没有旧签名的重载。 |
GraphSerializer.writeIndex/readIndex | 接收或返回共享 org.apache.hugegraph.structure.Index,并调整调用方。 |
自定义 HugeElement 子类 | 通过 element() 提供共享 BaseElement,通过 wrapProperty 适配属性。 |
元素适配器继续使用共享状态,不要恢复已移除的引擎状态字段,也不要新增一套邻接集合。
Gremlin classImports 和脚本需将 org.apache.hugegraph.backend.id.IdGenerator 改为 org.apache.hugegraph.id.IdGenerator。
启动发行包中的 Gremlin 服务,验证仅存在于配置中的类名引用;Java 编译不会检查这些引用。
RPC 接口 org.apache.hugegraph.rpc.RpcServiceConfig4Client 和 RpcServiceConfig4Server 统一由 common 维护。
类名和签名保持不变,无需因这项迁移调整 RPC import 或配置。
org.apache.hugegraph.auth.TokenGenerator 也由 common 维护,调用方提供签名密钥,并将 JWT 失败转换为各服务的响应。
Common 的 JWT 依赖为 optional,直接使用 JWT 的模块需声明所需库。
使用配套依赖包时调整下游异常
| 原下游入口 | 替换为 |
|---|---|
Hubble org.apache.hugegraph.exception.HugeException | org.apache.hugegraph.exception.HubbleException |
Java client org.apache.hugegraph.exception.NotSupportException | org.apache.hugegraph.exception.ClientNotSupportException |
Hubble 自带的 org.apache.hugegraph.license.MachineInfo | 保留 import,使用 common 的实现。 |
与 import 一起修改构造调用和 catch。HubbleException 保留 RuntimeException 父类和字符串构造器。
ClientNotSupportException 保留 ClientException 父类及 message/cause、message/arguments 构造器。
Computer 的 HgkvDirImpl 是受影响的 client 异常调用方。Struct 中名称相近的异常具有不同契约。
Loader 的 REST 边界和独立 client DTO 无需整体改为 struct。
Toolchain、Computer 调整仍是未发布的下游交接内容,需要配套发布、构建和发行包类路径检查。 检查构建后的 jar 以及源码,排除残留或传递依赖引入的同名类副本。
准备同步升级服务
将 Server、PD、Store 一起升级到配套发行包,本次迁移不支持混合版本滚动升级。 以下步骤适用于配套发行包已可用的部署。
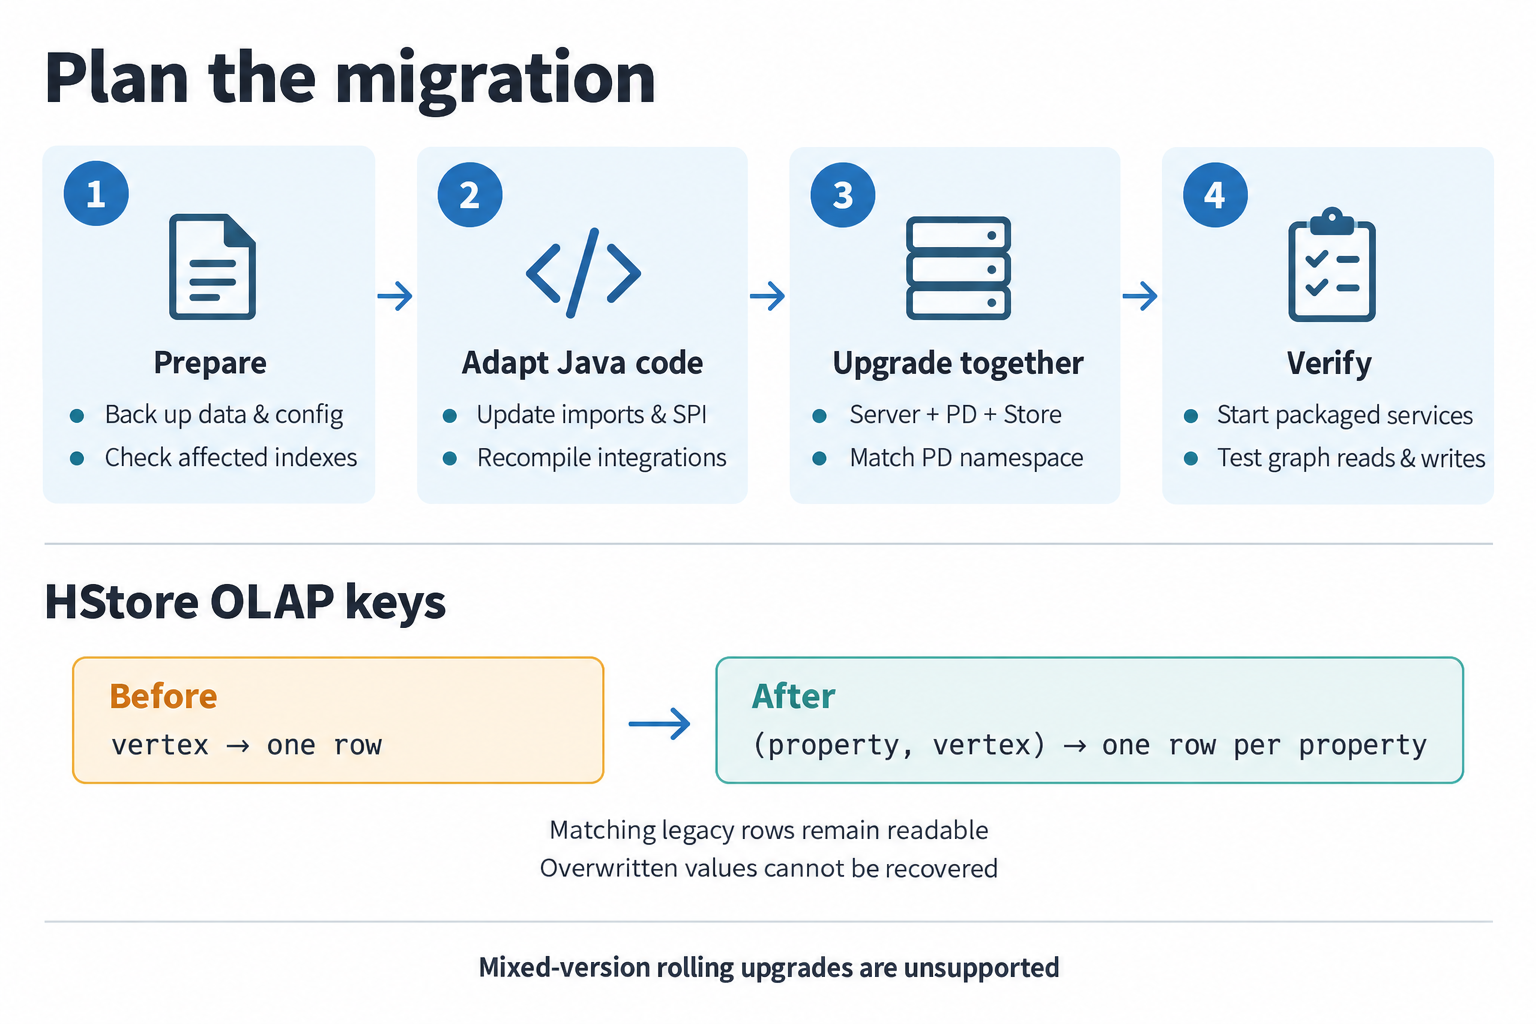
先备份数据和配置、检查受影响索引,再修改 import、SPI 并重新编译,随后同步升级配套服务、对齐 PD 命名空间。 最后验证发行包服务及图数据读写。OLAP 从每个顶点一行改为每个属性和顶点一行;匹配的旧行仍可读取,覆盖丢失的值不能恢复,不支持混合版本滚动升级。
- 按已有备份恢复流程备份图数据,并保留部署配置。
- 准备配套的 Server、PD、Store 发行包,以及重新构建的插件和实际需要的下游集成。
- 按下方配置对齐元数据命名空间,保留既有底层图名称。
- 在验证环境演练,启动发行包中的服务,读取历史数据,执行受影响查询和写入。
- 暂停写入后同步升级部署。所有 Server、Store 写入端使用配套发行包且检查通过后,再恢复写入。
本次整合不会自动重写图数据、重建索引或恢复历史项。演练时需检查下方兼容性场景。
对齐 PD 元数据命名空间
Store 的 pd.cluster 默认值为 hg,在 Store application.yml 中按以下方式设置。
对应环境变量为 PD_CLUSTER。
| Server 模式 | 必须与 Store pd.cluster 一致的配置 |
|---|---|
usePD=true | Server 的 cluster |
usePD=false | 图配置的 pd.cluster |
命名空间用于 schema、图配置、缓存监听和 TTL 清理器元数据。
同一个 Server 进程内的所有 HStore 图必须使用同一元数据命名空间。
usePD=false 时,首先打开的 HStore 图会用自身的 pd.cluster 绑定进程级 MetaManager。
后续图显式配置的冲突 pd.cluster 会记录警告并被忽略,不会建立独立命名空间。
同一个 Store 进程不能在冲突命名空间之间共享 schema driver。
保留 backend graphspace/store/table 名称,例如 DEFAULT/hugegraph/g;REST 标识 DEFAULT-hugegraph 不是元数据 key。
检查数据兼容性
| 数据或行为 | 保留或调整的行为 |
|---|---|
| 已存储的 ID 和属性 | 保留既有类型码、ID 与属性字节,以及配置默认值。 |
| 字符串 ID 比较 | 统一采用 Java UTF-16 顺序,包括从 UTF-8 字节加载的 ID;存储字节不变。 |
| 查询 JSON 和受支持的 Kryo 数据 | 类型迁移后仍需兼容解码历史 Java 类名。 |
| Schema map | 保留 wire 字段和 ID 身份;主键及 edge sort-key 列表保留顺序和重复项。 |
| Schema 端点 | 可读取匹配的冗余元数据和旧版仅含端点字段的 map;拒绝冲突或格式错误的端点。 |
| 普通 schema 索引 | Server 创建的 key 保留 key/name-TTL 布局。 |
| 带正过期时间的 Store SYSTEM-label 索引 | 保留稳定 key 和旧版 13 字节 value 封装,label 读取端识别这个有明确边界的封装。 |
Core SYSTEM-label 写入端保留原有字节。这次迁移不为这些 key 添加 TTL 后缀,也不改变前缀删除行为。 原本不支持的仅凭索引重建元素功能仍不支持。
元素分类通过 BaseVertex.TypeContext 保留生产方上下文。
| 上下文 | 既有系统顶点分类 |
|---|---|
STORAGE | ~variables 是任务数据。 |
ENGINE | ~server、~role_data 是服务端数据,~variables 是普通顶点数据。 |
| 两者 | ~task、~taskresult 都是任务数据。 |
引擎 wrapper 选择 ENGINE,独立 storage 元素保留 STORAGE,使表路由沿用既有行为。
重建受影响的旧长文本索引
旧 Store IndexBuilder 将长文本值截短为 20 个字符,Server 查询使用完整值及其 hash。
共享 builder 现在采用 Server 契约。旧的截短索引行仍可解码,但不会自动匹配完整值查询。
若部署曾通过 Store 重建索引,应找出受影响索引,必要时从图数据重新构建。 本次迁移不自动重建索引,也不能恢复缺失的历史项。普通 Server 创建的索引 key 沿用原有契约。
验证 HStore OLAP 读取和删除
新 OLAP 行使用 [property ID][vertex ID] key,让同一顶点的多个 OLAP 属性可以共存。
旧行只以 vertex ID 作为 key,其 value 无需重写仍可读取。
| 操作 | 组合 key 与旧 key 的处理方式 |
|---|---|
| 读取某个属性 | 优先读取其组合 key;旧 vertex-only 行的 value 包含请求的 property ID 时,才回退读取。 |
| 删除某个属性 | 移除其组合行和匹配的旧行,保留其他属性。 |
| 读取旧写入端已经覆盖丢失的属性 | 本次修复无法恢复丢失的值。 |
恢复写入前,升级全部 Server、Store 写入端。旧写入端可能更新旧行,新读取端仍优先读取已经存在的组合行。 混合版本 OLAP 写入不在支持的升级契约内。
验证发行包服务和集成
运行受影响的 Java/SPI 测试,再检查 RocksDB、HStore 查询、认证、Store schema 与过滤行为,以及共享元素状态传播。 覆盖历史 ID、schema、属性和索引样本、分页、TTL、OLAP 场景。 核查解析后的依赖和发行 jar,排除禁止的模块依赖或重复 HugeGraph 类,并启动实际发行包中的服务,不依赖类路径顺序规避冲突。 构建和依赖清单的前置条件见贡献指南。
实现、网站文档和下游依赖包仍需配套发布。 根据配套发行包、依赖包和运行结果决定采用迁移的时间;只编译源码或跳过测试的构建不足以确认可用性。
8 - HugeGraph 1.8.0 Gremlin 迁移与兼容性指南
HugeGraph 1.8.0 将底层图遍历与查询框架从 Apache TinkerPop 3.5.1 升级至 TinkerPop 3.8.1,运行环境统一要求 Java 17(服务端与构建),并将脚本引擎升级至 Groovy 4.0.25。
此次升级引入了部分语言层面的破坏性变更(Breaking Changes)。下文优先列出最常用且行为发生变化的核心语法与改写方案,以便快速排查和迁移;次常用选项及底层协议等边缘细节整理在文末的全量细则速查表。
- 本指南适用于从 1.7.0(或更早版本)升级至 1.8.0 的用户。
- 1.8.0 依然保留了 Groovy 脚本引擎支持,既有的多行脚本、变量定义及 Java 闭包等大多数逻辑仍可正常运行。
最常用的 5 大语法与行为变化
以下 5 项改动在已有业务查询中最为高频。前 3 项若不改写,在 HugeGraph 1.8 中会直接抛出异常;后 2 项不报错,但会静默改变返回结果(自动剔除缺失属性的元素或放行未匹配分支),需重点排查。
1. has(key, traversal) 重载删除(高危:查询执行报错)
- 影响说明:
在 TinkerPop 3.8.0 中,
has(String, Traversal)和has(T, Traversal)重载被彻底移除。 在 Groovy 脚本引擎下,旧写法会退化命中has(String, Object)重载。在 HugeGraph 1.8 中,由于图引擎将has()谓词下推至后端存储检索,并通过TraversalUtil.validPropertyValue()对属性值进行强类型校验,会直接抛出类型不匹配异常:- 属性过滤如
g.V().has('age', __.is(gt(30)))抛出:IllegalArgumentException: Invalid data type of query value '[IsStep(gt(30))]', expect INT for 'age', actual got class org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.DefaultGraphTraversal - 标签过滤如
g.V().has(T.label, __.is('person'))抛出:HugeException: The label type must be number or string, but got 'class org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.DefaultGraphTraversal'(注:仅在纯内存 TinkerGraph 上会静默返回空数组[],而在 HugeGraph 1.8 上会严格报错)。
- 属性过滤如
- 典型旧写法:
- 推荐改写方案:
2. store() 彻底删除 & aggregate() Scope 重载移除
- 影响说明:
- 旧版中用于惰性边走边收集副作用的
store('x')步骤已被完全删除,在 3.8.1 中直接报错MissingMethodException: No signature of method: ...store()。 aggregate(Scope, 'x')的带 Scope 重载也被删除(包括aggregate(local, 'x')和aggregate(global, 'x'))。
- 旧版中用于惰性边走边收集副作用的
- 典型旧写法:
- 推荐改写方案:
3. 丢弃输入步骤 none() 更名为 discard()
- 影响说明:
在 TinkerPop 3.5.1 中,
none()为 traversal 步骤,用于丢弃流中输入(如g.V().hasLabel('person').none()返回[])。 3.8.1 中该操作更名为discard()。 同时 3.8 引入了新的集合谓词步骤none(P)(用于检查集合是否没有元素满足条件)。若在 3.8.1 中直接调用无参none(),会立即抛出异常:IllegalArgumentException: Input predicate to none step can't be null. - 推荐改写方案:
4. by() 属性缺失行为变严(可能导致排序丢点、投影丢字段、路径丢失)
- 影响说明:
TinkerPop 3.6+ 统一了
by()调制器的缺失值处理(去除了原先部分默认补 null 的策略)。在 3.8.1 中,当by()依赖的属性不存在时:- 排序
order().by('age'):缺少age属性的顶点直接被过滤掉(旧版可能保留在开头或末尾)。 - 投影
project('name', 'age').by('name').by('age'):若某个顶点缺少age,返回的 Map 中将直接不包含age键(旧版会返回age: null)。 - 路径
path().by('age'):路径上若有任一节点缺少该属性,整条路径将被直接丢弃。
- 排序
- 推荐改写方案:
如果业务要求在属性缺失时仍保留元素并填入默认值(如
null或默认占位值),需在by()中使用coalesce()显式保底:
5. 分支条件 choose() 语义收敛
- 影响说明:
- 缺失属性处理:当选择子遍历依赖的属性缺失时,TinkerPop 3.5.1 会直接抛出异常:
IllegalArgumentException: The provided traverser does not map to a value: v[3]->[PropertiesStep([age],value)]。 在 3.8.1 中,缺少对应属性的元素不再报错,而是默认原样放行穿透。 - 单分支执行:当多个
option()条件同时命中时,旧版可能会把多个匹配分支全部执行;新版只执行第一个命中的分支。 - 默认放行机制:如果没有任何一个
option()匹配,新版默认将输入元素原样向下游放行(3.5.1 则会过滤掉)。
- 缺失属性处理:当选择子遍历依赖的属性缺失时,TinkerPop 3.5.1 会直接抛出异常:
- 推荐改写方案:
- 如需在多个条件同时命中时全部执行,请使用
union()配合filter()。 - 如需在无匹配或属性缺失时将元素过滤抛弃,需显式声明
Pick.none与Pick.unproductive分支:
- 如需在多个条件同时命中时全部执行,请使用
1.8 新增步骤与内置函数(TinkerPop 3.8)
TinkerPop 3.8 引入了原生日期操作函数与步骤,这些能力在 3.5.1(HugeGraph 1.7.0)中并不存在:
日期步骤(datetime()、dateAdd()、dateDiff())
datetime():构造日期时间对象或取得服务器当前时间。在 3.8 中返回java.time.OffsetDateTime(如datetime('2026-10-19T00:00:00Z'))。dateAdd():对日期进行加减运算。dateDiff():计算两个日期的差值,返回差值的毫秒数(例如相隔 1 天的结果为86400000ms)。- 代码示例:
服务端配置与客户端连接兼容
1. conf/gremlin-server.yaml 序列化器配置
在 TinkerPop 3.8 中,序列化器从 gremlin-driver(org.apache.tinkerpop.gremlin.driver.ser.*)包迁移到了 gremlin-util(org.apache.tinkerpop.gremlin.util.ser.*)包。
请勿直接复制 1.7.0 的 gremlin-server.yaml 并仅替换类名!
推荐直接使用 HugeGraph 1.8.0 发行包自带的 conf/gremlin-server.yaml,再将自定义端口、认证等配置合并进去。
HugeGraph 需要专用的 Builder 与 Registry:GraphBinary 必须配置 builder: org.apache.hugegraph.io.HugeGraphTypeSerializerRegistryBuilder
才能序列化 HugeGraph 的 Id、Schema、Blob 与枚举类型(否则会抛出 IOException: Serializer for type ... not found);
无类型 GraphSON V1 需要添加 org.apache.hugegraph.io.HugeGraphSONV1MessageIoRegistry。
旧配置类名 (driver.ser.*) | 1.8.0 对应类名 (util.ser.*) | 所需 Builder / Registry | 说明 |
|---|---|---|---|
GraphBinaryMessageSerializerV1 | org.apache.tinkerpop.gremlin.util.ser.GraphBinaryMessageSerializerV1 | builder: org.apache.hugegraph.io.HugeGraphTypeSerializerRegistryBuilderioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry] | 推荐,默认高效二进制协议 |
GraphSONMessageSerializerV1d0 | org.apache.tinkerpop.gremlin.util.ser.GraphSONUntypedMessageSerializerV1 | ioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry, org.apache.hugegraph.io.HugeGraphSONV1MessageIoRegistry] | 保持无类型 GraphSON V1 |
GraphSONMessageSerializerV2d0 | org.apache.tinkerpop.gremlin.util.ser.GraphSONMessageSerializerV2 | ioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry] | 标准 Typed GraphSON V2 |
GraphSONMessageSerializerV3d0 | org.apache.tinkerpop.gremlin.util.ser.GraphSONMessageSerializerV3 | ioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry] | 标准 Typed GraphSON V3 |
| (1.8 新增) | org.apache.tinkerpop.gremlin.util.ser.GraphSONUntypedMessageSerializerV2 | ioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry] | 无类型 GraphSON V2 (types=false) |
| (1.8 新增) | org.apache.tinkerpop.gremlin.util.ser.GraphSONUntypedMessageSerializerV3 | ioRegistries: [org.apache.hugegraph.io.HugeGraphIoRegistry] | 无类型 GraphSON V3 (types=false) |
2. HugeGraph Client 1.5.0 能否平滑使用?
- 结论:基础数据 CRUD 与 Schema 操作可以继续使用;Gremlin 查询与鉴权管理需要升级或适配。
- 服务端在 1.8.0 中增加了向前兼容层,使用
hugegraph-client:1.5.0进行常规顶点/边 CRUD 和 Schema 操作均可正常连通。 - 限制说明:
- Gremlin 查询别名:Client 1.5.0 的
gremlin().execute()发送旧版图别名(graph=<graph>与g=__g_<graph>),而 1.8.0 服务端仅绑定了 GraphSpace 命名空间的别名(DEFAULT-<graph>与__g_DEFAULT-<graph>),且服务端/gremlin会原样透传请求体,因此 1.5.0 客户端的 Gremlin 查询会因别名未识别而失败。如需在 1.8.0 下执行 Gremlin 查询,请升级客户端或改用 HTTP 接口显式传递正确的 aliases。 - Auth 鉴权路径:1.8.0 将用户与鉴权体系重构至 GraphSpace 维度(
graphspaces/{graphspace}/auth/users),Client 1.5.0 的graphs/{graph}/auth/...路径并不包含在此重定向范围内,鉴权管理操作需升级 Client。 - Gremlin 脚本语法:客户端所发送的 Gremlin 脚本字符串均在服务端的 3.8.1 引擎中执行,必须按上述规则适配 3.8 语法。
- Gremlin 查询别名:Client 1.5.0 的
全量细则速查表
除上述高频变化外,TinkerPop 3.5.1 → 3.8.1 还包含若干深层优化与边缘语义调整。如遇特定场景异常,请查阅下表对应项:
附录 1:写入与 Upsert(mergeV / mergeE)
在 HugeGraph 1.8.0(自 TinkerPop 3.6.0 起引入)中可使用标准的 mergeV() 与 mergeE() 执行图数据 Upsert 操作:
- M01:
onCreate的属性 Map 严格继承主匹配 Map,不允许用冲突值覆盖主匹配条件(如匹配条件是name: 'A',onCreate不能设name: 'B')。 - M02:
mergeE不再隐式拿上游顶点填补端点,必须在 Map 中指明(Direction.OUT)与(Direction.IN),或使用option(Merge.outV, ...)显式绑定。 - M03: 静态
onCreateMap 与 match 检索匹配条件发生键值冲突时,在构造阶段就会被严格校验,而非等到运行时才报错。 - M04:
onMatch子遍历在 3.8 中接收的是当前已匹配到的 Element 对象,而非最开始输入的 Map。若需引用外部输入参数,请在 merge 前通过.as('input')保存引用,内部通过select('input')取值。
附录 2:遍历内部高级步骤与集合行为
- B07 (
local()拆 bulk):带 bulk 计数的 Traverser 经过local()子遍历时会被展开为单个对象处理。若需统计频次,建议使用groupCount()。 - B09 (
range(local)集合解包):对列表截取单元素(如limit(local, 1)),新版始终返回 Collection 包装(如[1]),若业务必须获取标量,请在后续追加.unfold()。 - B11 (
sum()返回类型):整数流的sum()结果可能直接返回 Integer 而不是 Long(若无溢出),建议 Java 端统一使用Number接收。 - B14 (
split()步骤):HugeGraph 1.8 新增步骤。空字符串分隔符将拆分为单字符列表(如'abc'拆分为['a','b','c'])。 - B15 (
asString()步骤):HugeGraph 1.8 新增步骤。asString()接收到 null 时会抛出IllegalArgumentException,如需兼容 null 请配合choose()显式处理。
附录 3:多语言客户端差异(GLV)
- Python:步骤名避免与 Python 关键字冲突,全面使用下划线后缀(如
filter_()、id_()、range_()、max_()等),推荐使用 snake_case(如has_label)。 - JavaScript:返回的集合从 Array 转为真正的 ECMAScript
Set(通过.size、.has()操作);移除废弃的connectOnStartup选项,需使用await connection.open()。 - .NET:byte 类型严格按有符号整数(sbyte)序列化。
- Go:BigDecimal/BigInt 解析对齐,必须始终检查
Next()的 error 返回。
附录 4:底层协议与序列化边界
- C03 (OLTP 元素属性携带):远程查询返回的 Vertex/Edge 默认携带属性,不再仅是轻量引用的 id/label。若只关注特定业务字段,建议显式通过
project()或valueMap()投影,避免网络负载膨胀。 - C06 (GraphSON 载荷安全限制):新增数字长度(默认 10,000)、字符串长度(默认 20,000,000)与嵌套深度(默认 1,000)反序列化上限,避免深层 JSON 导致 OOM。
附录 5:HugeGraph 适配与能力边界
- 元属性保持不支持(Unchanged):HugeGraph 严格遵循自有 Schema 体系,历来不支持 TinkerPop 的属性元数据(属性上的属性)。
向顶点属性写入 metadata 始终会抛出
VertexProperty.Exceptions.metaPropertiesNotSupported()或NotSupportException("nested property"),1.8.0 行为与历史版本完全一致。 - 图计算限制:
supportsComputer()仍为false,依赖GraphComputer的步骤(如pageRank()、peerPressure())不能在 OLTP 引擎上直接执行,建议使用 HugeGraph 的专门算法 API 或 Vermeer 组件。 - 统一列表特性:
supportsUniformListValues()现返回false;图中的 List 属性依然由 HugeGraph 内部 Schema (valueList()) 提供完整支持。