这是本节的多页打印视图。
点击此处打印 .
返回本页常规视图 .
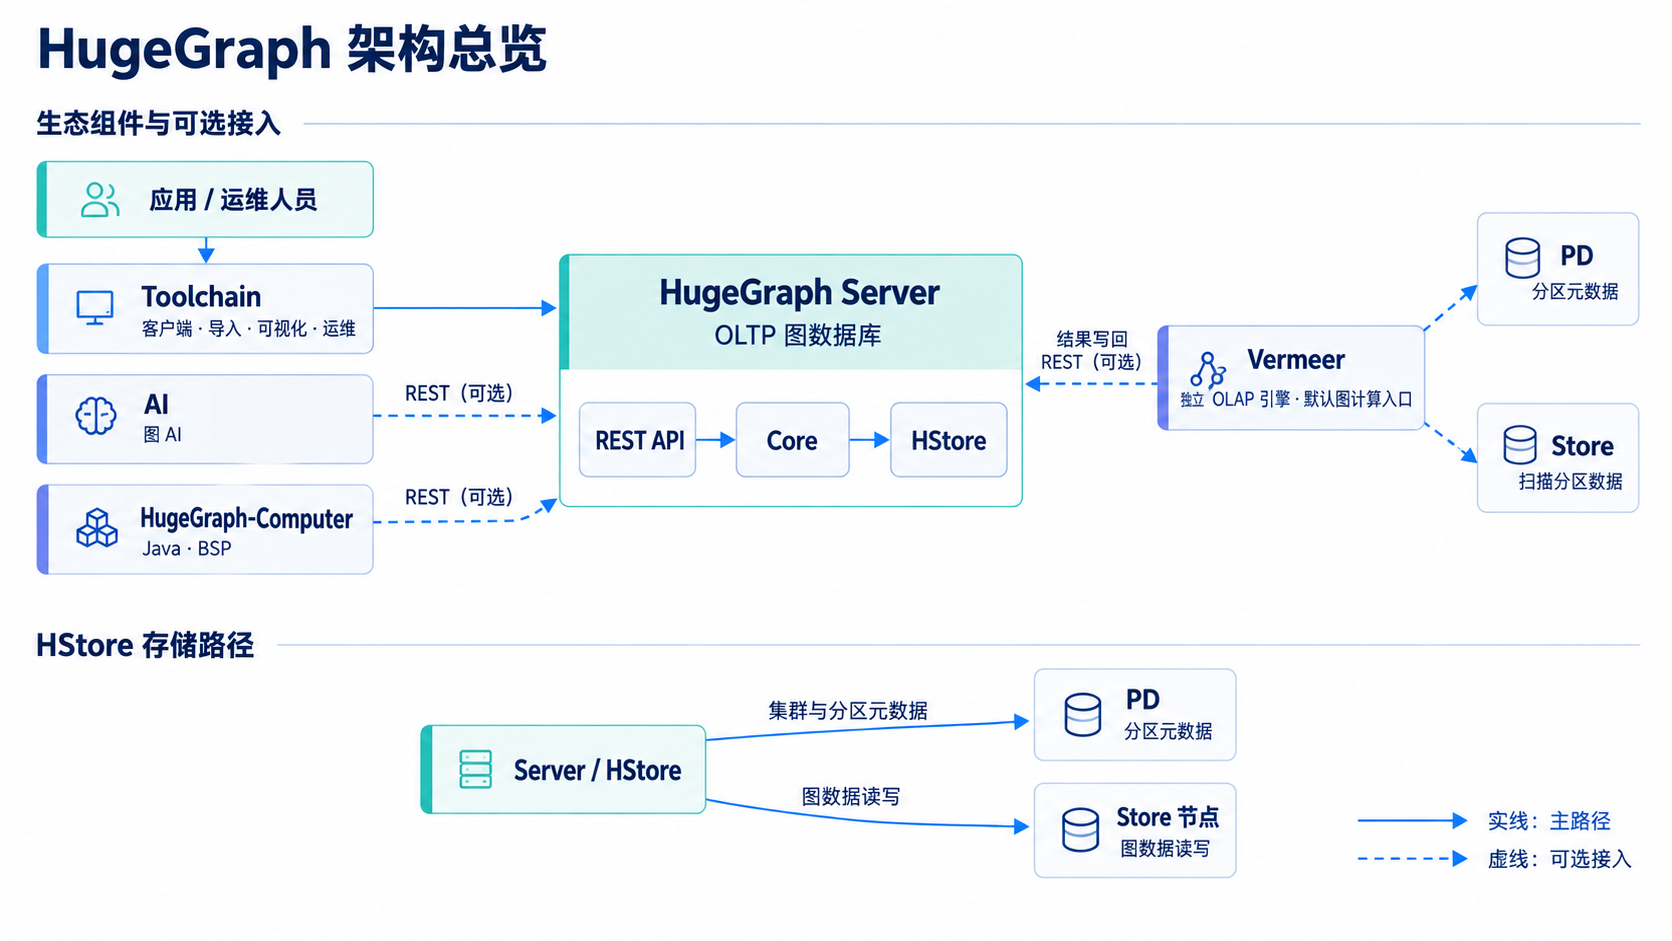
HugeGraph 架构概览 全栈组件 HugeGraph 生态由职责不同的图数据库、图计算、图 AI 和工具链组件组成。HugeGraph Server 提供 OLTP 图数据库服务;HugeGraph-Computer 与 Vermeer 是独立的 OLAP 图计算引擎;HugeGraph-AI 提供图 AI 能力。Toolchain 中的客户端、数据导入、可视化和运维工具为应用及运维人员提供配套入口。
图:Server 以 HStore 后端为例;RocksDB、HBase 等独立后端见下方 Mermaid。Vermeer 和 HugeGraph-Computer 是独立的 OLAP 引擎,虚线表示可选接入。
生态接入 flowchart TB
Apps["应用 / 运维"] --> Toolchain["Toolchain"] --> Server["Server REST API"]
AI["AI"] -. REST .-> Server
Computer["Computer"] -. REST .-> Server
Vermeer["Vermeer"] -. PD .-> PD["PD"]
Vermeer -. 扫描 .-> Store["Store"]
Vermeer -. 写回 .-> Server虚线表示可选的 HugeGraph 接入,不代表所有 AI、Computer 或 Vermeer 任务都必须连接 Server、PD 或 Store。Computer 和 AI 通过 Server REST API 读写图数据。Vermeer 的 HugeGraph 输入模式向 PD 查询分区元数据,并直接向 Store 扫描 HStore 分区;选择 HugeGraph 结果输出时,再通过 Server REST API 写回结果。
Server 内部结构 flowchart TB
API["REST API / Gremlin"] --> Core["Core"] --> Adapter["后端适配"]
Adapter --> RocksDB["RocksDB"]
Adapter --> HBase["HBase"]
Adapter --> HStore["HStore"]
HStore --> PD["PD"]
HStore --> Store["Store"]Server 的 REST API 和 Gremlin 接口把请求交给 Core,再由存储后端适配器执行读写。RocksDB 和 HBase 是独立后端;HStore 适配器从 PD 获取集群元数据和分区信息,并向 Store 节点发送图数据操作。PD 管理集群元数据与分区,不承载图数据读写路径。
当前 Server 提供 RocksDB、HBase、HStore 和内存后端实现。内存后端主要用于测试或临时使用,不属于正式持久化部署选项;生产部署方式见 Server 快速上手 。
Toolchain 的主要组件如下:
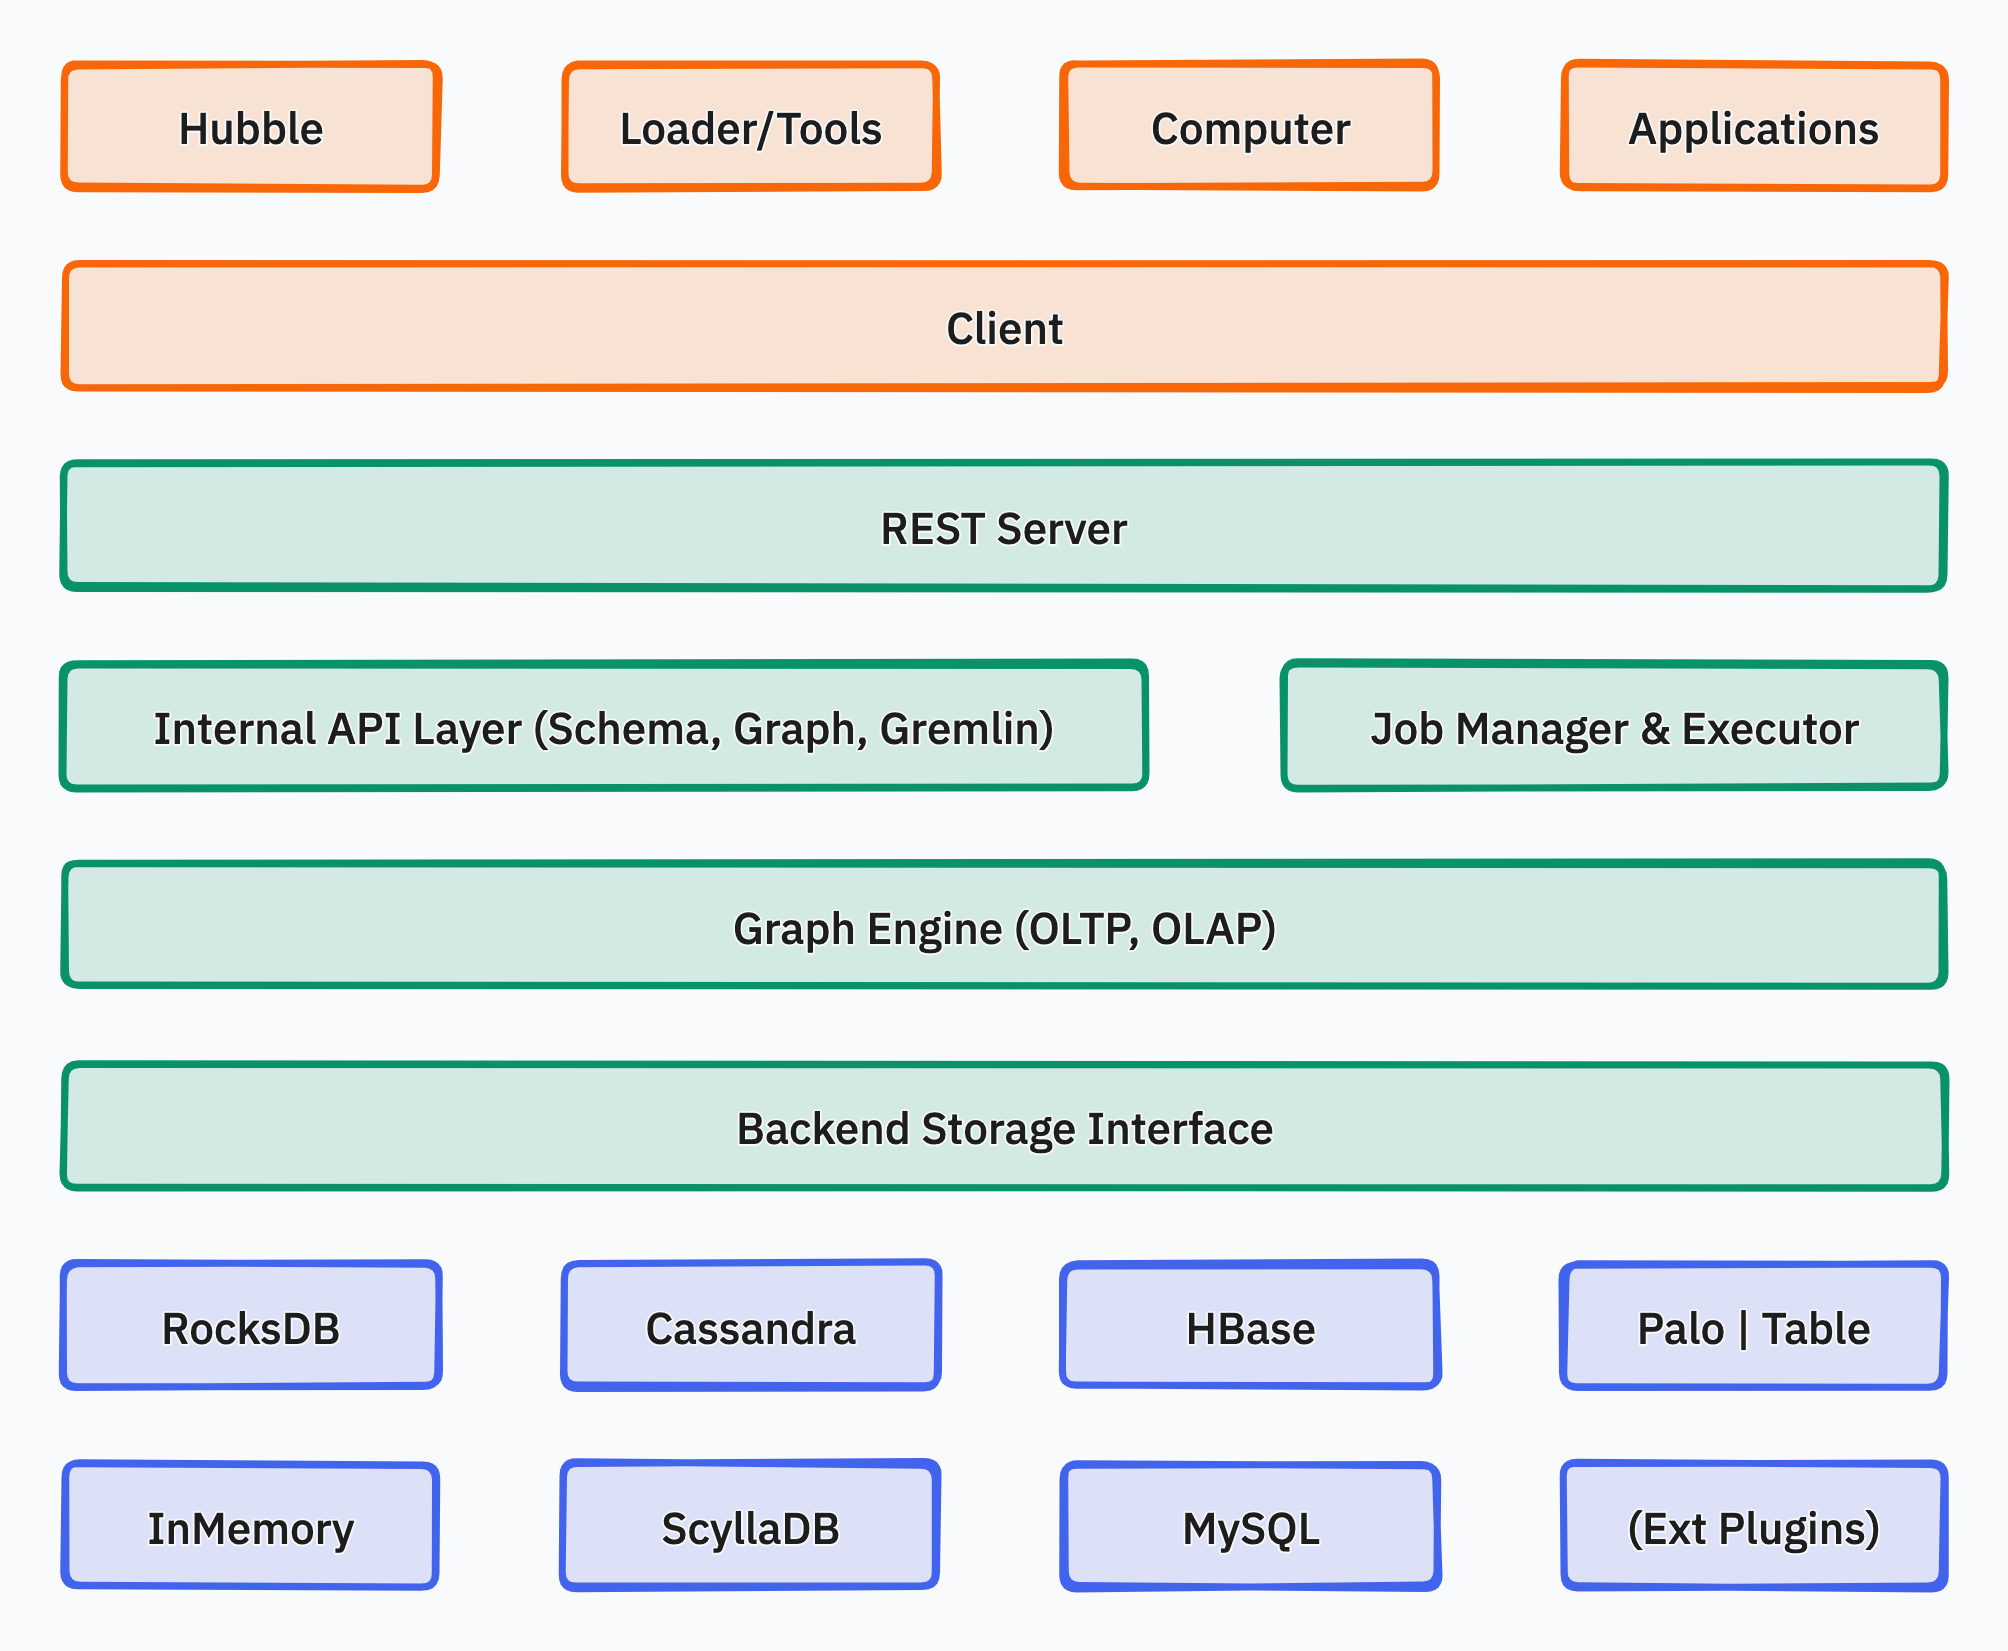
Hubble — Web 交互式图可视化与一站式管理工作台。Loader — 支持多源、断点续传的高性能批量图数据导入工具。Tools — 提供集群部署运维、元数据检查与备份恢复能力的 CLI 工具。Client — 官方多语言客户端 SDK,支持 Java、Python 与 Go。独立图计算引擎 历史架构图 下图保留作历史参考,其中 Server 同时承担 OLTP 与 OLAP、以及多种旧后端的标注不代表 当前主线实现。
相关专题 1 - HugeGraph Plugin 机制及插件扩展流程 插件接入计划用于 1.8.0 的共享基础模块 API 时,请按Java/SPI 迁移指南 调整并使用配套 artifacts 重新编译。
下方示例描述 1.7.0 API。
背景 HugeGraph 不仅开源开放,而且要做到简单易用,一般用户无需更改源码也能轻松增加插件扩展功能。 HugeGraph 支持多种内置存储后端,也允许用户无需更改现有源码的情况下扩展自定义后端。 HugeGraph 支持全文检索,全文检索功能涉及到各语言分词,目前已内置 7 种分词器(ansj、hanlp、smartcn、jieba、jcseg、mmseg4j、ikanalyzer),也允许用户无需更改现有源码的情况下扩展自定义分词器。 可扩展维度 目前插件方式提供如下几个维度的扩展项:
插件实现机制 提供 SPI 接口 :HugeGraph 提供核心插件接口 HugeGraphPlugin,通过标准 Java SPI 机制支持运行时插件化发现。静态注册入口 :HugeGraphPlugin 提供了 4 个扩展项注册静态函数:registerOptions()、registerBackend()、registerSerializer()、registerAnalyzer()。实现扩展接口 :插件开发者实现相应的 OptionHolder、BackendStoreProvider、AbstractSerializer 或 Analyzer 等核心接口。插件注册并打包 :实现 HugeGraphPlugin 的 register() 方法完成类注册,配置 META-INF/services/ 描述文件并打成 JAR 包。部署生效 :将编译出的 JAR 包放置在 HugeGraph Server 安装目录的 plugins/ 路径下,修改对应配置项后重启服务即可生效。插件实现流程实例 1 新建一个 maven 项目 1.1 项目名称取名:hugegraph-plugin-demo 1.2 添加hugegraph-core Jar 包依赖 maven pom.xml 详细内容如下。hugegraph.version 应与要兼容的 Server 版本一致;此处以当前主线版本 1.7.0 为例:
1 <?xml version="1.0" encoding="UTF-8"?>
2
3 <project xmlns= "http://maven.apache.org/POM/4.0.0"
4 xmlns:xsi= "http://www.w3.org/2001/XMLSchema-instance"
5 xsi:schemaLocation= "http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd" >
6
7 <modelVersion> 4.0.0</modelVersion>
8 <groupId> org.apache.hugegraph</groupId>
9 <artifactId> hugegraph-plugin-demo</artifactId>
10 <version> 1.0.0</version>
11 <packaging> jar</packaging>
12
13 <name> hugegraph-plugin-demo</name>
14
15 <properties>
16 <hugegraph.version> 1.7.0</hugegraph.version>
17 </properties>
18
19 <dependencies>
20 <dependency>
21 <groupId> org.apache.hugegraph</groupId>
22 <artifactId> hugegraph-core</artifactId>
23 <version> ${hugegraph.version}</version>
24 </dependency>
25 </dependencies>
26 </project> 2 实现扩展功能 2.1 扩展自定义后端 2.1.1 实现接口 BackendStoreProvider 可实现接口:org.apache.hugegraph.backend.store.BackendStoreProvider 或者继承抽象类:org.apache.hugegraph.backend.store.AbstractBackendStoreProvider 以 RocksDB 后端 RocksDBStoreProvider 为例:
1 public class RocksDBStoreProvider extends AbstractBackendStoreProvider {
2
3 protected String database () {
4 return this . graph (). toLowerCase ();
5 }
6
7 @Override
8 protected BackendStore newSchemaStore ( HugeConfig config , String store ) {
9 return new RocksDBStore . RocksDBSchemaStore ( this , this . database (), store );
10 }
11
12 @Override
13 protected BackendStore newGraphStore ( HugeConfig config , String store ) {
14 return new RocksDBStore . RocksDBGraphStore ( this , this . database (), store );
15 }
16
17 @Override
18 protected BackendStore newSystemStore ( HugeConfig config , String store ) {
19 return new RocksDBStore . RocksDBSystemStore ( this , this . database (), store );
20 }
21
22 @Override
23 public String type () {
24 return "rocksdb" ;
25 }
26
27 @Override
28 public String driverVersion () {
29 return "1.11" ;
30 }
31 } 2.1.2 实现接口 BackendStore BackendStore 的核心抽象方法如下(接口默认辅助方法略):
1 public interface BackendStore {
2 // Store name
3 String store ();
4
5 // Stored version
6 String storedVersion ();
7
8 // Database name
9 String database ();
10
11 // Get the parent provider
12 BackendStoreProvider provider ();
13
14 // Get the system schema store
15 SystemSchemaStore systemSchemaStore ();
16
17 // Whether it is the storage of schema
18 boolean isSchemaStore ();
19
20 // Open/close database
21 void open ( HugeConfig config );
22 void close ();
23 boolean opened ();
24
25 // Initialize/clear database
26 void init ();
27 void clear ( boolean clearSpace );
28 boolean initialized ();
29
30 // Delete all data of database (keep table structure)
31 void truncate ();
32
33 // Add/delete data
34 void mutate ( BackendMutation mutation );
35
36 // Query data
37 Iterator < BackendEntry > query ( Query query );
38 Iterator < Iterator < BackendEntry >> query ( Iterator < Query > queries ,
39 Function < Query , Query > queryWriter ,
40 HugeGraph hugeGraph );
41 Number queryNumber ( Query query );
42
43 // Transaction
44 void beginTx ();
45 void commitTx ();
46 void rollbackTx ();
47
48 // Get metadata by key
49 < R > R metadata ( HugeType type , String meta , Object [] args );
50
51 // Backend features
52 BackendFeatures features ();
53
54 // Increase next id for specific type
55 void increaseCounter ( HugeType type , long increment );
56
57 // Get current counter for a specific type
58 long getCounter ( HugeType type );
59 } 2.1.3 扩展自定义序列化器 序列化器必须继承抽象类:org.apache.hugegraph.backend.serializer.AbstractSerializer(implements GraphSerializer, SchemaSerializer) 主要接口的定义如下:
1 public interface GraphSerializer {
2 BackendEntry writeVertex ( HugeVertex vertex );
3 BackendEntry writeOlapVertex ( HugeVertex vertex );
4 BackendEntry writeVertexProperty ( HugeVertexProperty <?> prop );
5 HugeVertex readVertex ( HugeGraph graph , BackendEntry entry );
6 BackendEntry writeEdge ( HugeEdge edge );
7 BackendEntry writeEdgeProperty ( HugeEdgeProperty <?> prop );
8 HugeEdge readEdge ( HugeGraph graph , BackendEntry entry );
9 CIter < Edge > readEdges ( HugeGraph graph , BackendEntry bytesEntry );
10 BackendEntry writeIndex ( HugeIndex index );
11 HugeIndex readIndex ( HugeGraph graph , ConditionQuery query , BackendEntry entry );
12 BackendEntry writeId ( HugeType type , Id id );
13 Query writeQuery ( Query query );
14 }
15
16 public interface SchemaSerializer {
17 BackendEntry writeVertexLabel ( VertexLabel vertexLabel );
18 VertexLabel readVertexLabel ( HugeGraph graph , BackendEntry entry );
19 BackendEntry writeEdgeLabel ( EdgeLabel edgeLabel );
20 EdgeLabel readEdgeLabel ( HugeGraph graph , BackendEntry entry );
21 BackendEntry writePropertyKey ( PropertyKey propertyKey );
22 PropertyKey readPropertyKey ( HugeGraph graph , BackendEntry entry );
23 BackendEntry writeIndexLabel ( IndexLabel indexLabel );
24 IndexLabel readIndexLabel ( HugeGraph graph , BackendEntry entry );
25 } 2.1.4 扩展自定义配置项 增加自定义后端时,可能需要增加新的配置项,实现流程主要包括:
增加配置项容器类,并实现接口org.apache.hugegraph.config.OptionHolder 提供单例方法public static OptionHolder instance(),并在对象初始化时调用方法OptionHolder.registerOptions() 增加配置项声明,单值配置项类型为ConfigOption、多值配置项类型为ConfigListOption 以 RocksDB 配置项定义为例:
1 public class RocksDBOptions extends OptionHolder {
2
3 private RocksDBOptions () {
4 super ();
5 }
6
7 private static volatile RocksDBOptions instance ;
8
9 public static synchronized RocksDBOptions instance () {
10 if ( instance == null ) {
11 instance = new RocksDBOptions ();
12 instance . registerOptions ();
13 }
14 return instance ;
15 }
16
17 public static final ConfigOption < String > DATA_PATH =
18 new ConfigOption <> (
19 "rocksdb.data_path" ,
20 "The path for storing data of RocksDB." ,
21 disallowEmpty (),
22 "rocksdb-data/data"
23 );
24
25 public static final ConfigOption < String > WAL_PATH =
26 new ConfigOption <> (
27 "rocksdb.wal_path" ,
28 "The path for storing WAL of RocksDB." ,
29 disallowEmpty (),
30 "rocksdb-data/wal"
31 );
32
33 public static final ConfigListOption < String > DATA_DISKS =
34 new ConfigListOption <> (
35 "rocksdb.data_disks" ,
36 false ,
37 "The optimized disks for storing data of RocksDB. " +
38 "The format of each element: `STORE/TABLE: /path/disk`." +
39 "Allowed keys are [g/vertex, g/edge_out, g/edge_in, " +
40 "g/vertex_label_index, g/edge_label_index, " +
41 "g/range_int_index, g/range_float_index, " +
42 "g/range_long_index, g/range_double_index, " +
43 "g/secondary_index, g/search_index, g/shard_index, " +
44 "g/unique_index, g/olap]" ,
45 null ,
46 String . class ,
47 ImmutableList . of ()
48 );
49 } 2.2 扩展自定义分词器 分词器需要实现接口org.apache.hugegraph.analyzer.Analyzer,以实现一个 SpaceAnalyzer 空格分词器为例。
1 package org.apache.hugegraph.plugin ;
2
3 import java.util.Arrays ;
4 import java.util.HashSet ;
5 import java.util.Set ;
6
7 import org.apache.hugegraph.analyzer.Analyzer ;
8
9 public class SpaceAnalyzer implements Analyzer {
10
11 @Override
12 public Set < String > segment ( String text ) {
13 return new HashSet <> ( Arrays . asList ( text . split ( " " )));
14 }
15 } 3. 实现插件接口,并进行注册 插件注册入口为HugeGraphPlugin.register(),自定义插件必须实现该接口方法,在其内部注册上述定义好的扩展项。接口org.apache.hugegraph.plugin.HugeGraphPlugin定义如下:
1 public interface HugeGraphPlugin {
2
3 String name ();
4
5 void register ();
6
7 String supportsMinVersion ();
8
9 String supportsMaxVersion ();
10 } 并且 HugeGraphPlugin 提供了 4 个静态方法用于注册扩展项:
registerOptions(String name, String classPath):注册配置项 registerBackend(String name, String classPath):注册后端(BackendStoreProvider) registerSerializer(String name, String classPath):注册序列化器 registerAnalyzer(String name, String classPath):注册分词器 下面以注册 SpaceAnalyzer 分词器为例:
1 package org.apache.hugegraph.plugin ;
2
3 public class DemoPlugin implements HugeGraphPlugin {
4
5 @Override
6 public String name () {
7 return "demo" ;
8 }
9
10 @Override
11 public void register () {
12 HugeGraphPlugin . registerAnalyzer ( "demo" , SpaceAnalyzer . class . getName ());
13 }
14
15 @Override
16 public String supportsMinVersion () {
17 return "1.7.0" ;
18 }
19
20 @Override
21 public String supportsMaxVersion () {
22 return "1.8.0" ;
23 }
24 } 4. 配置 SPI 入口 确保 services 目录存在:hugegraph-plugin-demo/resources/META-INF/services 在 services 目录下建立文本文件:org.apache.hugegraph.plugin.HugeGraphPlugin 文件内容如下:org.apache.hugegraph.plugin.DemoPlugin 5. 打 Jar 包 通过 maven 打包,在项目目录下执行命令mvn package,在 target 目录下会生成 Jar 包文件。使用时将该 Jar 包拷到plugins目录,重启服务即可生效。
2 - HugeGraph 设计理念 1. 属性图模型 版本说明 :本页保留早期设计内容。属性图模型和顶点 ID 策略仍与 当前主线源码相符;图示、分区结论及事务实现描述按各节注明的范围阅读,不能直接当作当前部署或存储实现说明。
常见的图数据表示模型有两种,分别是RDF(Resource Description Framework)模型和属性图模型。 RDF和Property Graph都是最基础、最有名的图表示模式,都能够表示各种图的实体关系建模。
RDF是W3C标准,而Property Graph是工业标准,受到广大图数据库厂商的广泛支持。HugeGraph目前采用Property Graph。
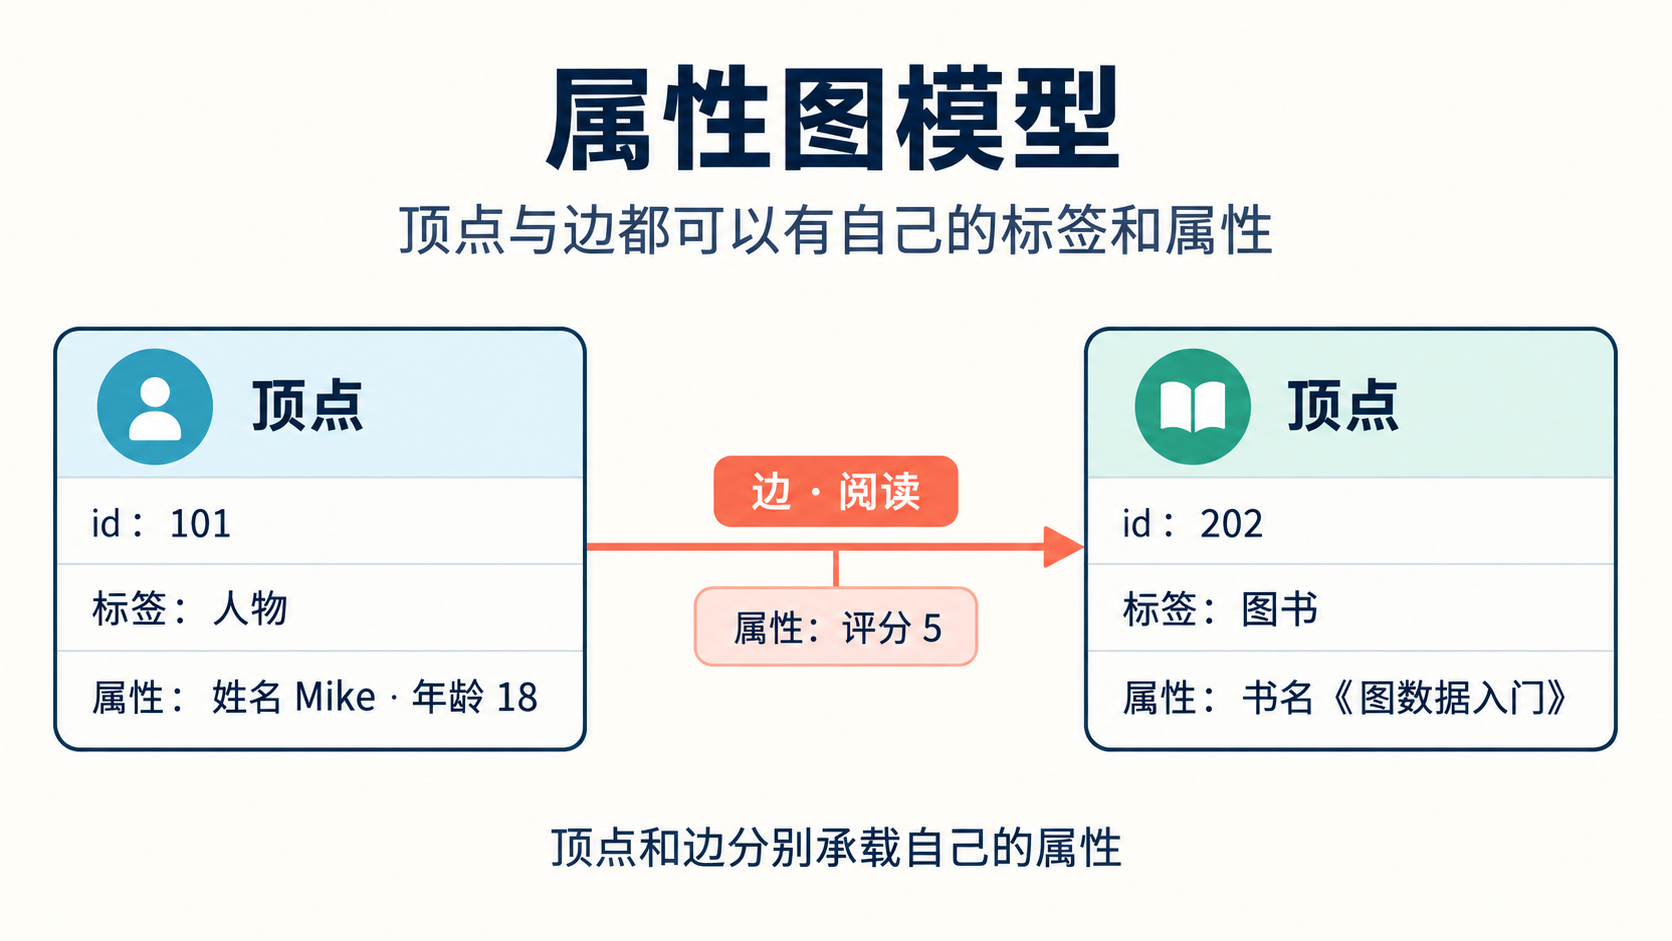
HugeGraph采用属性图模型。下图以人物和图书为例,展示顶点与有向边各自的标签和属性;这是逻辑模型示意,不描述 当前主线的内部数据布局。
图:顶点和边分别携带自己的标签与属性。
在HugeGraph内部,每个顶点 / 边由唯一的 VertexId / EdgeId 标识,属性存储在对应点 / 边内部。而顶点与顶点之间的关系 / 映射则是通过边来存储的。
顶点属性值通过边指针方式存储时,如果要更新一个顶点特定的属性值直接通过覆盖写入即可,其弊端是冗余存储了VertexId;如果要更新关系的属性需要通过read-and-modify方式,先读取所有属性,修改部分属性,然后再写入存储系统,更新效率较低。
从经验来看顶点属性的修改需求较多,而边的属性修改需求较少,例如PageRank和Graph Cluster等计算都需要频繁修改顶点的属性值。
2. 图分区方案 版本说明 :Edge Cut 与 Vertex Cut 的比较属于历史设计背景。当前主线的 PD 与 Store 源码没有把“HugeGraph 采用 Edge Cut”定义为实现契约,因此下文该结论不适用于描述 当前主线的实际分区与副本机制;当前分布式部署请参考 HStore 快速上手 。
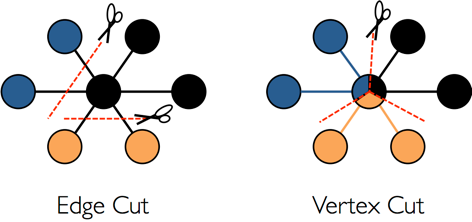
对于分布式图数据库而言,图的分区存储方式有两种:分别是边分割存储(Edge Cut)和点分割存储(Vertex Cut),如下图所示。使用Edge Cut方式存储图时,任何一个顶点只会出现在一台机器上,而边可能分布在不同机器上,这种存储方式有可能导致边多次存储。
使用Vertex Cut方式存储图时,任何一条边只会出现在一台机器上,而每相同的一个点可能分布到不同机器上,这种存储方式可能会导致顶点多次存储。
采用EdgeCut分区方案可以支持高性能的插入和更新操作,而VertexCut分区方案更适合静态图查询分析,因此EdgeCut适合OLTP图查询,VertexCut更适合OLAP的图查询。早期设计资料曾记载 HugeGraph 采用 Edge Cut。此处保留该历史结论,不将其视为当前分区实现说明。
3. VertexId 策略 HugeGraph的Vertex支持四种ID策略,在同一个图数据库中不同的VertexLabel可以使用不同的Id策略,目前HugeGraph支持的Id策略分别是:
自动生成(AUTOMATIC):使用Snowflake算法自动生成全局唯一Id,Long类型; 主键(PRIMARY_KEY):通过VertexLabel+PrimaryKeyValues生成Id,String类型; 自定义(CUSTOMIZE_STRING|CUSTOMIZE_NUMBER):用户自定义Id,分为String和Long类型两种,需自己保证Id的唯一性; 自定义UUID(CUSTOMIZE_UUID):用户自定义UUID形式的Id,需自己保证Id的唯一性; 默认的Id策略是AUTOMATIC,如果用户调用primaryKeys()方法并设置了正确的PrimaryKeys,则自动启用PRIMARY_KEY策略。启用PRIMARY_KEY策略后HugeGraph能根据PrimaryKeys实现数据去重。
AUTOMATIC ID策略 1 schema . vertexLabel ( "person" )
2 . useAutomaticId ()
3 . properties ( "name" , "age" , "city" )
4 . create ();
5 graph . addVertex ( T . label , "person" , "name" , "marko" , "age" , 18 , "city" , "Beijing" ); PRIMARY_KEY ID策略 1 schema . vertexLabel ( "person" )
2 . usePrimaryKeyId ()
3 . properties ( "name" , "age" , "city" )
4 . primaryKeys ( "name" , "age" )
5 . create ();
6 graph . addVertex ( T . label , "person" , "name" , "marko" , "age" , 18 , "city" , "Beijing" ); CUSTOMIZE_STRING ID策略 1 schema . vertexLabel ( "person" )
2 . useCustomizeStringId ()
3 . properties ( "name" , "age" , "city" )
4 . create ();
5 graph . addVertex ( T . label , "person" , T . id , "123456" , "name" , "marko" , "age" , 18 , "city" , "Beijing" ); CUSTOMIZE_NUMBER ID策略 1 schema . vertexLabel ( "person" )
2 . useCustomizeNumberId ()
3 . properties ( "name" , "age" , "city" )
4 . create ();
5 graph . addVertex ( T . label , "person" , T . id , 123456 , "name" , "marko" , "age" , 18 , "city" , "Beijing" ); CUSTOMIZE_UUID ID策略 1 schema . vertexLabel ( "person" )
2 . useCustomizeUuidId ()
3 . properties ( "name" , "age" , "city" )
4 . create ();
5 graph . addVertex ( T . label , "person" , T . id , UUID . randomUUID (), "name" , "marko" , "age" , 18 , "city" , "Beijing" ); 如果用户需要Vertex去重,有三种方案分别是:
采用PRIMARY_KEY策略,自动覆盖,适合大数据量批量插入,用户无法知道是否发生了覆盖行为 采用AUTOMATIC策略,read-and-modify,适合小数据量插入,用户可以明确知道是否发生覆盖 采用CUSTOMIZE_STRING或CUSTOMIZE_NUMBER策略,用户自己保证唯一 4. EdgeId 策略 当前实现提示 :本节的四项组合是历史简化描述。当前 EdgeId 还区分边方向及父、子边标签;其实际字段见 Server 源码中的 EdgeId 实现。需要依赖 ID 格式或持久化键时,应以对应版本源码为准。
HugeGraph的EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合而成。其中sortKey是HugeGraph的一个重要概念。在Edge中加入sortKey作为Edge的唯一标识的原因有两个:
如果两个顶点之间存在多条相同Label的边可通过sortKey来区分 对于SuperNode的节点,可以通过sortKey来排序截断。 由于EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合,多次插入相同的Edge时HugeGraph会自动覆盖以实现去重。需要注意的是如果批量插入模式下Edge的属性也将会覆盖。
另外由于HugeGraph的EdgeId采用自动去重策略,对于self-loop(一个顶点存在一条指向自身的边)的情况下HugeGraph认为仅有一条边,对于采用AUTOMATIC策略的图数据库(例如TitianDB )则会认为该图存在两条边。
HugeGraph的边仅支持有向边,无向边可以创建Out和In两条边来实现。
5. HugeGraph 事务概览 版本范围 :下文关于 HugeGraph 隔离级别、线程绑定和后端原子性的描述保留为历史实现说明。各后端的事务隔离与失败回滚边界应以对应实现为准,不应将下述历史描述当作跨后端保证。
TinkerPop事务概述 TinkerPop 事务是对数据库执行操作的工作单元,一个事务内的一组操作要么执行成功,要么全部失败。详细介绍请参考TinkerPop官方文档:http://tinkerpop.apache.org/docs/current/reference/#transactions
TinkerPop事务操作接口 open 打开事务 commit 提交事务 rollback 回滚事务 close 关闭事务 TinkerPop事务规范 事务必须显式提交后才可生效(未提交时修改操作只有本事务内查询可看到) 事务必须打开之后才可提交或回滚 如果事务设置自动打开则无需显式打开(默认方式),如果设置手动打开则必须显式打开 可设置事务关闭时:自动提交、自动回滚(默认方式)、手动(禁止显式关闭)等3种模式 事务在提交或回滚后必须是关闭状态 事务在查询后必须是打开状态 事务(非threaded tx)必须线程隔离,多线程操作同一事务互不影响 更多事务规范用例见:Transaction Test
HugeGraph事务实现 一个事务中所有的操作要么成功要么失败 一个事务只能读取到另外一个事务已提交的内容(Read committed) 所有未提交的操作均能在本事务中查询出来,包括:增加顶点能够查询出该顶点 删除顶点能够过滤掉该顶点 删除顶点能够过滤掉该顶点相关边 增加边能够查询出该边 删除边能够过滤掉该边 增加/修改(顶点、边)属性能够在查询时生效 删除(顶点、边)属性能够在查询时生效 所有未提交的操作在事务回滚后均失效,包括: 示例:一个事务无法读取另一个事务未提交的内容
1 static void testUncommittedTx ( final HugeGraph graph ) throws InterruptedException {
2
3 final CountDownLatch latchUncommit = new CountDownLatch ( 1 );
4 final CountDownLatch latchRollback = new CountDownLatch ( 1 );
5
6 Thread thread = new Thread (() -> {
7 // this is a new transaction in the new thread
8 graph . tx (). open ();
9
10 System . out . println ( "current transaction operations" );
11
12 Vertex james = graph . addVertex ( T . label , "author" ,
13 "id" , 1 , "name" , "James Gosling" ,
14 "age" , 62 , "lived" , "Canadian" );
15 Vertex java = graph . addVertex ( T . label , "language" , "name" , "java" ,
16 "versions" , Arrays . asList ( 6 , 7 , 8 ));
17 james . addEdge ( "created" , java );
18
19 // we can query the uncommitted records in the current transaction
20 System . out . println ( "current transaction assert" );
21 assert graph . vertices (). hasNext () == true ;
22 assert graph . edges (). hasNext () == true ;
23
24 latchUncommit . countDown ();
25
26 try {
27 latchRollback . await ();
28 } catch ( InterruptedException e ) {
29 throw new RuntimeException ( e );
30 }
31
32 System . out . println ( "current transaction rollback" );
33 graph . tx (). rollback ();
34 });
35
36 thread . start ();
37
38 // query none result in other transaction when not commit()
39 latchUncommit . await ();
40 System . out . println ( "other transaction assert for uncommitted" );
41 assert ! graph . vertices (). hasNext ();
42 assert ! graph . edges (). hasNext ();
43
44 latchRollback . countDown ();
45 thread . join ();
46
47 // query none result in other transaction after rollback()
48 System . out . println ( "other transaction assert for rollback" );
49 assert ! graph . vertices (). hasNext ();
50 assert ! graph . edges (). hasNext ();
51 } 事务实现原理 服务端内部通过将事务与线程绑定实现隔离(ThreadLocal) 本事务未提交的内容按照时间顺序覆盖老数据以供本事务查询最新版本数据 底层依赖后端数据库保证事务原子性操作(如RocksDB的batch接口保证原子性) 注意 REST API 未提供独立的事务生命周期接口;写操作接口会在服务端调用相应的事务提交逻辑。
TinkerPop API允许打开事务,请求完成时会自动关闭(Gremlin Server强制关闭)