这是本节的多页打印视图。 .
图查询语言
HugeGraph 支持两种主流图查询语言:Gremlin(命令式遍历语言)与 Cypher(声明式模式匹配语言)。
- Gremlin:Apache TinkerPop 的核心图遍历语言,语法灵活、表达力强,适合复杂拓扑路径探索与精细遍历控制。
- Cypher:openCypher 标准化的声明式语言,类似 SQL 的直观模式匹配(
MATCH ... WHERE ... RETURN),易读性强且便于 Neo4j 迁移。
语言指南与参考
Gremlin 遍历基础、CRUD 语法示例以及 TinkerPop 规范支持情况。
Cypher 声明式语法支持、读取与写入示例、执行机制与使用限制。
Cypher 子句与函数的覆盖矩阵、已知差异及未实现特性的规避方案。
Neo4j 与 HugeGraph 在图模型、ID 策略、多标签及查询语法上的核心差异对照与迁移步骤。
经典的 TitanDB“众神图”(Graph of the Gods,包含 12 个顶点)示例数据集,供编写查询时对照参考。
周边工具与相关入口
在不同场景下执行图查询的快捷入口:
- 命令行交互:通过 Gremlin Console 可以在终端中离线调试或连接 Server 提交脚本。
- Web 可视化探索:在 HugeGraph-Hubble 中在线执行 Gremlin / Cypher,进行图谱可视化与 Text2GQL 探索。
- HTTP REST 接口:直接通过 HTTP 请求提交查询,见 Gremlin REST API 与 Cypher REST API。
- 版本升级参考:从旧版本升级时,请查阅 Gremlin 与 TinkerPop 迁移指南,排查语法废弃与行为变化。
1 - HugeGraph Gremlin
概述
HugeGraph 原生支持 Apache TinkerPop3 的图遍历查询语言 Gremlin。 与关系型数据库使用的声明式 SQL 不同,Gremlin 是一种通用的图遍历与计算语言,能够精准控制图的拓扑路径探索,执行实体创建(Vertex 与 Edge)、属性修改、批量删除以及复杂的图分析。
HugeGraph 基于 TinkerPop 3.8.1 引擎构建。完整规范与语法参考请查阅 Apache TinkerPop 3.8.1 官方参考文档。 若习惯声明式模式匹配(类似 SQL 或 Neo4j 风格),HugeGraph 同时提供 Cypher 查询语言 支持。
TinkerPop 特性支持
HugeGraph 实现了 TinkerPop 规范核心接口,针对图存储、顶点、边以及属性数据类型的具体支持情况如下:
图级特性(Graph Features)
| 特性名称 | 含义与说明 | 支持情况 |
|---|---|---|
Computer | 是否支持基于 GraphComputer 的 OLAP 图计算引擎(HugeGraph 服务端专注实时 OLTP 遍历,大规模图计算由独立组件支持) | false |
Transactions | 是否支持事务机制(原生支持 ACID 事务提交与回滚) | true |
Persistence | 是否原生将数据持久化到磁盘介质(取决于所配置的底层存储后端,RocksDB/Cassandra/HBase 等均持久化存储) | 取决于后端 |
ThreadedTransactions | 是否支持通过 createThreadedTx() 在多个线程间共享同一个执行事务 | false |
ConcurrentAccess | 是否支持同一底层数据实例的多连接并发访问 | false |
顶点特性(Vertex Features)
| 特性名称 | 含义与说明 | 支持情况 |
|---|---|---|
UserSuppliedIds | 是否允许在创建顶点时由用户指定自定义标识符(HugeGraph 支持用户自定义、主键和自动生成等策略) | true |
NumericIds | 顶点内部标识符是否限定为纯数值类型 | false |
StringIds | 顶点内部标识符是否支持字符串类型 | true |
UuidIds | 顶点内部标识符是否原生限定为 UUID 格式 | false |
CustomIds | 顶点内部标识符是否支持复合自定义对象 | true |
AnyIds | 顶点内部标识符是否允许任意 Java 对象类型 | false |
AddProperty | 是否支持向顶点添加或动态更新属性 | true |
RemoveProperty | 是否支持从顶点移除已有属性 | true |
AddVertices | 是否支持向图中添加新顶点 | true |
MultiProperties | 单个顶点同一属性名下是否支持存储多个值(多值属性) | true |
DuplicateMultiProperties | 在启用多值属性时,是否允许存在相同的重复值 | true |
MetaProperties | 是否支持在属性上附加元属性(属性的属性) | false |
RemoveVertices | 是否支持从图中删除指定顶点 | true |
边特性(Edge Features)
| 特性名称 | 含义与说明 | 支持情况 |
|---|---|---|
UserSuppliedIds | 是否允许直接指定边标识符(HugeGraph 边 ID 自动由起点、标签、排序键与终点复合生成) | false |
NumericIds | 边内部标识符是否限定为纯数值类型 | false |
StringIds | 边内部标识符是否支持字符串类型 | true |
UuidIds | 边内部标识符是否限定为 UUID 格式 | false |
CustomIds | 边内部标识符是否支持复合自定义对象 | true |
AnyIds | 边内部标识符是否允许任意 Java 对象类型 | false |
AddProperty | 是否支持向边添加或动态更新属性 | true |
RemoveProperty | 是否支持从边移除已有属性 | true |
AddEdges | 是否支持在顶点之间建立边 | true |
RemoveEdges | 是否支持从图中删除指定边 | true |
数据类型支持(Data Type Features)
| 特性名称 | 含义与说明 | 支持情况 |
|---|---|---|
BooleanValues | 布尔类型属性(boolean) | true |
ByteValues | 单字节整数(byte) | true |
DoubleValues | 双精度浮点数(double) | true |
FloatValues | 单精度浮点数(float) | true |
IntegerValues | 32 位整型(int) | true |
LongValues | 64 位长整型(long) | true |
MapValues | 是否支持直接存储嵌套 Map 键值对对象 | false |
MixedListValues | 是否支持存储不同类型混合元素的列表 | false |
BooleanArrayValues | 布尔数组类型(boolean[]) | false |
ByteArrayValues | 二进制字节数组(byte[],常用于 Blob 或向量嵌入存储) | true |
DoubleArrayValues | 双精度浮点数组(double[]) | false |
FloatArrayValues | 单精度浮点数组(float[]) | false |
IntegerArrayValues | 整型数组(int[]) | false |
LongArrayValues | 长整型数组(long[]) | false |
SerializableValues | 是否支持直接存储任意 Java 序列化对象 | false |
StringArrayValues | 字符串数组(String[]) | false |
StringValues | 标准文本字符串类型(text/string) | true |
UniformListValues | 存储同类型元素的集合列表(由 Schema 中的 cardinality() 与 valueList() 机制原生支持) | false(由 Schema 支持) |
Gremlin 常用步骤参考
HugeGraph 支持 Gremlin 遍历规范定义的各项步骤。完整说明与高级遍历用法请参阅 TinkerPop 3.8.1 步骤参考。
| 步骤 | 说明 | 官方文档 |
|---|---|---|
addE | 在两个顶点之间添加有向边 | addE step |
addV | 向图中添加新顶点 | addV step |
and | 确保所有子遍历都产生有效输出 | and step |
as | 为步骤输出分配变量标签的调制器 | as step |
by | 与 group、order 等步骤配合使用的维度调制器 | by step |
coalesce | 返回首个产生结果的子遍历 | coalesce step |
constant | 生成指定常量值,常与 coalesce 配合使用 | constant step |
count | 统计遍历流中元素的总数量 | count step |
datetime | 构造日期时间对象或取得服务器当前时间(返回 OffsetDateTime) | datetime function |
dedup | 去除遍历流中的重复元素 | dedup step |
discard | 丢弃当前流中的遍历器输出 | discard step |
drop | 从图中彻底删除对应实体(顶点、边或属性) | drop step |
fold | 栅栏步骤,将流中所有项汇总折叠为一个 List | fold step |
group | 根据指定的键与投影调制器对数据进行分组聚合 | group step |
has | 属性与元素过滤,支持 hasLabel、hasId、hasNot 等变体 | has step |
inject | 将外部离散值直接注入当前遍历流中 | inject step |
is | 针对标量值执行布尔条件匹配与过滤 | is step |
limit | 限制遍历流返回的最大项数 | limit step |
local | 局部作用域执行子遍历,类似于局部子查询 | local step |
not | 对子遍历匹配结果取反(必须不满足条件) | not step |
optional | 尝试执行子遍历;若有输出则返回,否则保留输入元素 | optional step |
or | 确保至少有一个子遍历返回有效结果 | or step |
order | 按指定字段或比较规则对元素进行排序 | order step |
path | 收集并返回当前遍历所经过的历史完整路径 | path step |
project | 将多个调制结果投影为结构化 Map 映射 | project step |
properties | 获取指定键的 Property 实体对象 | properties step |
range | 基于下标范围进行切片截取(起始索引至结束索引) | range step |
repeat | 循环执行指定的子遍历步骤 | repeat step |
sample | 从当前流中进行随机抽样 | sample step |
select | 从历史路径或映射投影中提取特定标签的变量值 | select step |
mergeV | 按属性匹配顶点,存在则更新,不存在则创建(标准 Upsert 步骤) | mergeV step |
mergeE | 按属性与端点匹配边,存在则更新,不存在则创建(标准 Upsert 步骤) | mergeE step |
tree | 将遍历路径汇总聚合成树形层级结构 | tree step |
unfold | 将集合或数组结构展开为连续的流元素 | unfold step |
union | 并行执行多个子遍历并合并其输出结果 | union step |
V | 顶点检索与端点跳转基础步骤:V、E、out、in、both、outE、inE 等 | vertex steps |
where | 使用表达式或谓词(eq、neq、gt 等)进行条件筛选过滤 | where step |
2 - HugeGraph Cypher
概述
HugeGraph 支持 Cypher —— 最初由 Neo4j 创建、并由 openCypher 标准化的声明式图查询语言。Gremlin 是命令式的遍历语言,而 Cypher
只需描述想要的图模式(MATCH、WHERE、RETURN),由引擎决定如何执行。
HugeGraph 实现了对 openCypher 9 语法子集的支持,查询语句在服务端解析并无缝对接底层 TinkerPop 图遍历引擎。因此开发者可以使用直观的模式匹配语法,快速完成图数据的检索与写入。完整支持矩阵与限制参见 Cypher 兼容性。
何时用 Cypher、何时用 Gremlin
| 适合用 Cypher | 适合用 Gremlin |
|---|---|
| 正在从 Neo4j 迁移,或已熟悉 Cypher | 需要 HugeGraph 的完整功能面 |
需要声明式模式匹配(MATCH (a)-[:KNOWS]->(b)) | 需要精细的遍历控制、自定义步骤或 lambda |
| 查询以读模式和投影为主 | 需要图算法、OLAP 或 Cypher 未暴露的功能 |
凡是 Cypher 表达不了的,等价的 Gremlin 查询 总是可用 —— 下文示例同时给出两种写法。
调用 Cypher API
Cypher 语句通过 HugeGraph Server 的 REST 端点提交:
当服务端开启鉴权时,Cypher 请求需要携带 Authorization 请求头,支持 Authorization: Basic ...(标准 RFC 4648 Base64 编码,如 curl -u)或 Authorization: Bearer <token>(未携带认证信息的请求返回 401)。服务端未开启鉴权时无需携带此头。
完整请求/响应格式见 Cypher REST API 参考。
示例:
Java 客户端使用 CypherManager(见 hugegraph-client):
基础示例
以下示例基于包含 person(属性 name、age、city)和 knows 边的图模型。
执行前请注意:
- 属性过滤谓词(如
WHERE n.age > 30)通常需要对应的索引覆盖(如在person.age上建立RANGE索引)。 - 若顶点标签采用
PRIMARY_KEY策略或定义了非空属性,创建数据时需为必填属性和主键赋值;建议先分别创建顶点再建立关联边。
查询 — MATCH / WHERE / RETURN
创建 — CREATE
更新 — SET / REMOVE
删除 — DELETE / DETACH DELETE
聚合
等价的 Gremlin 写法
每条 Cypher 语句在内部都会被翻译为 Gremlin。当某个 Cypher 特性不受支持时,可直接编写遍历:
| Cypher | 等价 Gremlin |
|---|---|
MATCH (n:person) WHERE n.name='marko' RETURN n | g.V().hasLabel('person').has('name','marko') |
MATCH (a)-[:knows]->(b) RETURN b | g.V().out('knows') |
CREATE (n:person {name:'x'}) | g.addV('person').property('name','x') |
MATCH (n) DETACH DELETE n | g.V().drop() |
MATCH (n:person) RETURN count(n) | g.V().hasLabel('person').count() |
提示:可使用 EXPLAIN MATCH (n:person) RETURN n 查看对应的底层 Gremlin 遍历语句(位于返回结果的 translation 字段中),方便对照编写等价写法。PROFILE 暂不受支持。
使用限制
- 参数化查询规则:支持通过 JSON 请求体传递参数(
{"cypher": "...", "parameters": {...}},最多支持 16 个顶层参数; 更多属性可放入 Map 对象并显式引用)。引用了未声明的$param时会直接抛出执行错误;显式传入null是允许的。 - 高级语法覆盖边界:部分高级 openCypher 语法(如 map projection、部分复杂函数)当前暂不支持,未支持的结构会在解析校验阶段报错。
- 过程调用:HugeGraph 的图分析算法(最短路径、k-out、PersonalRank 等)通过独立的 Traverser REST API 或 Gremlin 提供,未暴露为 Cypher
CALL过程。 - 单请求单语句:每次请求仅支持执行一条 Cypher 语句,不支持多语句复合脚本。
执行或校验失败时,服务端会在响应的 status.attributes.errors 中返回包含 code、message 与 hint 的结构化错误详情。遇到功能缺口时,等价的 Gremlin 写法是官方推荐的替代方案。
延伸阅读
3 - Cypher 兼容性
概述与支持范围
HugeGraph 支持 openCypher 9 声明式图查询规范,支持在 TinkerPop 引擎之上直接执行模式匹配与图数据读写。 本页汇总 Cypher 请求形式、参数绑定规则、支持的语法子集与行为边界。
接口端点为 /graphspaces/{graphspace}/graphs/{graph}/cypher。常规语法示例与 Gremlin 对照参见 HugeGraph Cypher 指南。
请求形式与参数绑定
| 请求形式 | Content-Type | 说明 |
|---|---|---|
POST(推荐) | application/json | 请求体为 JSON 对象 {"cypher": "...", "parameters": {...}},支持参数绑定 |
POST | application/json | 请求体为原始 Cypher 文本字符串(用于无参数的纯文本语句) |
GET | — | 查询参数 ?cypher=<URL 编码语句>,适合简单只读查询 |
JSON 对象参数化请求示例:
参数绑定规则
- 参数格式:
cypher字段必须为非空字符串;parameters若提供必须为 JSON 对象(省略表示空参数表)。 - 参数数量:顶层
parameters最多接受 16 个键。若需要传入更多属性,可将相关字段组织为嵌套 Map 对象,并在 Cypher 语句中显式引用字段(例如$props.name)。 - 未绑定变量处理:语句中引用未提供的
$param时会直接抛出执行错误,拒绝执行(显式传入null是允许的)。 - 保留标记:引擎将
" cypher.null"(前导双空格)用作内部保留哨兵标记,绑定值中禁止传入该精确字符串。 - 错误响应:格式错误的请求体直接返回 HTTP 400 及标准错误结构;语法翻译与查询执行错误则返回 HTTP 200(响应体中包含
status.code: 400与空result),并在status.attributes.errors中提供包含code、message与hint的结构化错误详情。
语法与功能支持矩阵
| 分类 | 支持特性 | 说明 |
|---|---|---|
| 查询与模式 | 标签扫描、等值与范围过滤、逻辑组合(AND/OR/NOT)、单跳与多跳有向关系、正则匹配(=~ 全匹配) | 范围过滤等条件需预先建立相应索引 |
| 结果投影 | 节点与标量投影、别名(AS)、属性访问、嵌套结构、关系 ID、路径表达、空值(null)处理 | 返回结果映射为标准 JSON 格式 |
| 聚合与排序 | count、sum、min、max、avg、DISTINCT、ORDER BY、SKIP、LIMIT | 分页与聚合计算由引擎自动转换为对应图遍历步骤 |
| 数据写入 | 顶点与边 CREATE、属性 SET / REMOVE、边与顶点 DELETE / DETACH DELETE | 创建边前建议先为端点顶点赋值并创建,避免简写形式因非空约束或主键缺失失败 |
写入约束与注意事项
在包含非空属性或使用 PRIMARY_KEY 策略的 Schema 下,双顶点简写 CREATE (a)-[:knows]->(b) 会因未提供属性而触发非空属性校验失败(checkNonnullProperty)或主键缺失错误。
建议将顶点与边的创建语句分开执行,并显式为顶点填充所需属性。
暂未支持的范围
以下高级语法和特性在当前版本中尚未直接提供,建议改用 Gremlin 或相应 REST API:
- 复杂子句:
MERGE、UNION、变长路径匹配(*1..3); - 过程调用:
CALL dbms.*/CALL algo.*(请使用 Traverser REST API); - 模式定义:Cypher Schema DDL(请使用 Schema REST API);
- 协议与驱动:Bolt 协议与驱动(请使用 HTTP REST API 或 HugeGraph 客户端)。
4 - 从 Neo4j 迁移
概述
面向从 Neo4j 迁移或评估 HugeGraph 的开发者。HugeGraph 原生支持 openCypher 声明式查询语法, 但在图模型、Schema 规范、参数绑定和索引机制上与 Neo4j 存在差异。 具体语法与兼容性请参考 HugeGraph Cypher 与 Cypher 兼容性说明。
可以直接带过来的部分
| Neo4j 概念 | HugeGraph 对应 |
|---|---|
| 属性图模型(节点/关系/属性) | 相同 —— 顶点标签 / 边标签 / 属性 |
基础 Cypher:MATCH/WHERE/RETURN/CREATE/SET/DELETE | 直接可用(REST /cypher 端点或 Java 客户端 CypherManager),但须遵守下文的 Schema 与索引规则 |
简单聚合(count/sum/min/max/avg) | 直接可用 |
| 依赖图遍历的查询需求 | Gremlin 遍历或 traverser REST API(k-out、最短路、personalrank 等) |
需要改变习惯的部分
| 在 Neo4j 里 | 在 HugeGraph 里 |
|---|---|
CREATE INDEX / CREATE CONSTRAINT | 通过 IndexLabel REST API 创建属性索引;唯一性约束对应 UNIQUE 索引;节点键对应非可空属性加复合 UNIQUE 索引;属性存在约束对应 VertexLabel / EdgeLabel 上的非可空属性。注意 primary_keys 决定顶点标识,不是约束机制,重复 CREATE 直接覆盖旧记录 |
| 隐式 schema(属性随意添加) | 强 schema:先定义 VertexLabel/EdgeLabel/PropertyKey,再写数据 |
WHERE 中的属性谓词无需索引 | 起始顶点查找需要索引覆盖(除非对该标签全部主键做等值匹配):> / < 等范围比较需要 RANGE 类型的 IndexLabel。缺少覆盖索引时返回 HTTP 200(响应体 status.code 400 “未建索引"错误) |
参数化查询 $param | 支持 JSON 格式参数化请求(最多支持 16 个顶层参数,更多属性可通过嵌套 Map 传递);未声明的参数会报错 |
CALL dbms.* / CALL algo.* 过程 | 对应功能分散在 traverser、task 等 REST API |
| 驱动:Neo4j Bolt driver | hugegraph-client(CypherManager)或任意 HTTP 客户端 |
| 事务边界在 Cypher 语句内 | 每次请求一个语句;图到图的数据迁移使用 Apache SeaTunnel 3.0.0(首选,见下文),基于文件的批量导入使用 HugeGraph Loader |
PRIMARY_KEY 标签上 UNIQUE 索引不能包含该标签的全部主键(服务端会拒绝)。若需保留唯一性约束,请改用 CUSTOMIZE_STRING id 策略,以 Neo4j 节点 id 为键,再在业务键上建 UNIQUE 索引。
建议的迁移路径
盘点查询:对照 Cypher 兼容性说明 与 使用限制,梳理应用中的 Cypher 语句, 确认直接可用、需改写为 Gremlin 或需调用 REST API 的部分。
先建 schema:用 schema API 建好 VertexLabel/EdgeLabel/PropertyKey 和索引 —— HugeGraph 在写入前要求 schema 存在。
导入数据:首选路径是 Apache SeaTunnel 的
Neo4jConnector(Source)与HugeGraphConnector(Sink),直接运行 Neo4j Source → HugeGraph Sink —— 无需中间文件导出。 小数据集用 REST 也没问题;基于文件的大批量导入仍可使用 HugeGraph Loader。 HugeGraph 侧的环境准备、mappings配置与顶点/边导入示例见 通过 SeaTunnel Sink 导入图数据。SeaTunnel 连接器文档 说明了可依赖的能力:
- Neo4j Source 以显式字段
schema 读取 Cypher 查询结果,支持通过
tables_configs的多表读取。 - HugeGraph Sink
支持多映射 —— 顶点/边请使用推荐的
mappings配置,并遵循其 schema 创建行为。该 Sink 默认 遇到错误快速失败(batch_failure_fallback=false与max_insert_errors=0)。跳过失败记录为 可选配置(batch_failure_fallback=true);若开启,请在正式切换前捕获并核对跳过行,并比对数据总条数。 - HugeGraph Source 支持 schema 自动发现与多标签并行读取,使 HugeGraph 的导出与迁移工作流成为可能。
将 Neo4j 属性映射为 HugeGraph PropertyKey,并在导入前先定好顶点 ID 策略。Sink 对除
AUTOMATIC之外的每种顶点策略都要求idFields,边映射还需要分别设置sourceConfig.idFields与targetConfig.idFields,因此 Neo4j 查询必须返回承载 ID 的字段:idStrategy = "PRIMARY_KEY":在idFields中放入 Neo4j 业务键,边的端点也通过这些键字段表达。idStrategy = "CUSTOMIZE_STRING":仅选择它并不能保留 Neo4j 节点 id。请让 Neo4j 查询把要保留的 id 作为单独一列返回(用AS node_id等别名),在 Source 的schema.fields中声明该字段(必须与查询返回的字段一致), 把顶点的idFields设为该字段,并在sourceConfig.idFields与targetConfig.idFields中映射对应的边端点字段。
第 2 步预创建的标签必须使用同一策略——自动创建不会把已有的
PRIMARY_KEY标签改为CUSTOMIZE_STRING。 Sink 的mappings配置可以创建缺失的 PropertyKey、VertexLabel 和 EdgeLabel 定义,因此使用它时第 2 步中的这三类 定义可省略;但它不会创建 IndexLabel,查询所依赖的索引仍须单独创建(见上文“需要改变习惯的部分”表)。 若未显式指定frequency,自动创建 EdgeLabel 时默认采用SINGLE,相同类型且端点相同的多条平行关系(Parallel Relationships)会被覆盖合并为一条边。 若需保留 Neo4j 中的平行边,必须在边映射中显式指定frequency = "MULTIPLE",并配置稳定的业务区分字段作为sortKeys(HugeGraph 依赖 sortKeys 生成重边的唯一边 ID)。 先导入顶点、后导入边。建议在正式切换前,先在测试环境中使用业务数据样本完整验证导入流程。- Neo4j Source 以显式字段
schema 读取 Cypher 查询结果,支持通过
灰度切换:Cypher 能表达的查询保持不动,暂不支持的改写为 Gremlin(等价写法见 对照表)。
使用限制速查
- 语句与参数:不支持多语句脚本与
CALL过程;参数绑定最多支持 16 个顶层参数(更多属性可通过嵌套 Map 传递)。 - 未覆盖语法:兼容性矩阵中未涉及的高级 openCypher 结构属于未验证范围,可能在解析校验期报错;明确不支持的限制见前文说明。
- 回退方案:不受支持的查询结构通常可以改写为等价的 Gremlin 遍历 —— 详见 HugeGraph Cypher 对照表; Schema DDL 与存储过程请改用对应 REST API。
5 - HugeGraph Examples
1 概述
本示例将TitanDB Getting Started 为模板来演示 HugeGraph 的使用方法。通过对比 HugeGraph 和 TitanDB,了解 HugeGraph 和 TitanDB 的差异。
1.1 HugeGraph 与 TitanDB 的异同
HugeGraph 和 TitanDB 都是基于Apache TinkerPop3框架的图数据库,均支持Gremlin图查询语言,在使用方法和接口方面具有很多相似的地方。然而 HugeGraph 是全新设计开发的,其代码结构清晰,功能较为丰富,接口更为友好等特点。
HugeGraph 相对于 TitanDB 而言,其主要特点如下:
- HugeGraph 目前有 HugeGraph-API、HugeGraph-Client、HugeGraph-Loader、HugeGraph-Studio、HugeGraph-Spark 等完善的工具组件,可以完成系统集成、数据载入、图可视化查询、Spark 连接等功能;
- HugeGraph 具有 Server 和 Client 的概念,第三方系统可以通过 jar 引用、client、api 等多种方式接入,而 TitanDB 仅支持 jar 引用方式接入。
- HugeGraph 的 Schema 需要显式定义,所有的插入和查询均需要通过严格的 schema 校验,目前暂不支持 schema 的隐式创建。
- HugeGraph 充分利用后端存储系统的特点来实现数据高效存取,而 TitanDB 以统一的 Kv 结构无视后端的差异性。
- HugeGraph 的更新操作可以实现按需操作(例如:更新某个属性)性能更好。TitanDB 的更新是 read and update 方式。
- HugeGraph 的 VertexId 和 EdgeId 均支持拼接,可实现自动去重,同时查询性能更好。TitanDB 的所有 Id 均是自动生成,查询需要经索引。
1.2 人物关系图谱
本示例通过 Property Graph Model 图数据模型来描述希腊神话中各人物角色的关系(也被成为人物关系图谱),具体关系详见下图。
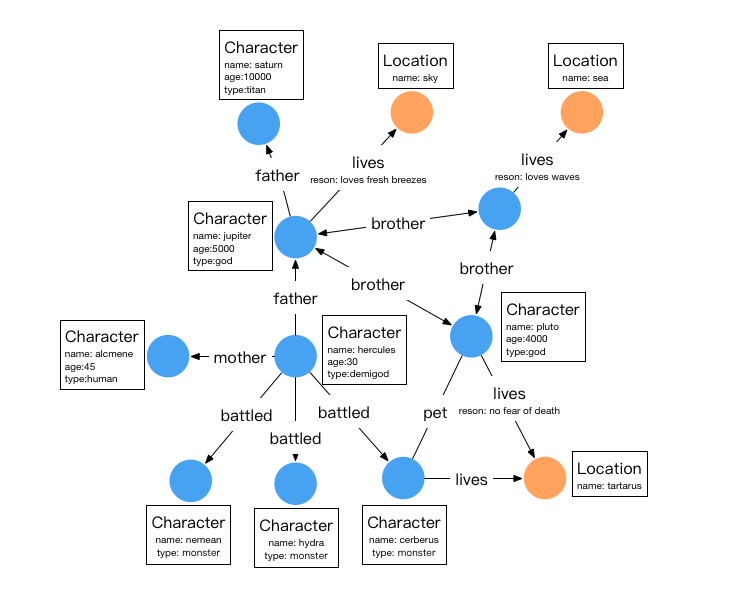
其中,圆形节点代表实体 (Vertex),箭头代表关系(Edge),方框的内容为属性。
该关系图谱中有两类顶点,分别是人物(character)和位置(location)如下表:
| 名称 | 类型 | 属性 |
|---|---|---|
| character | vertex | name,age,type |
| location | vertex | name |
有六种关系,分别是父子(father)、母子(mother)、兄弟(brother)、战斗(battled)、居住 (lives)、拥有宠物(pet)关于关系图谱的具体信息如下:
| 名称 | 类型 | source vertex label | target vertex label | 属性 |
|---|---|---|---|---|
| father | edge | character | character | - |
| mother | edge | character | character | - |
| brother | edge | character | character | - |
| battled | edge | character | character | time |
| pet | edge | character | character | - |
| lives | edge | character | location | reason |
一个 edge label 可以连接多对 source vertex label 和 target vertex label:创建时对每一对顶点标签各调用一次 link(sourceLabel, targetLabel) 即可。已废弃的 sourceLabel() 和 targetLabel() 构建方法只支持单一配对。
本例子将原TitanDB中的monster, god, human, demigod均使用相同的vertex label: character来表示, 同时增加属性type来标识人物的类型。edge label与原TitanDB保持一致。
2 Graph Schema and Data Ingest Examples
HugeGraph 需要显示创建 Schema,因此需要依次创建 PropertyKey、VertexLabel、EdgeLabel,如果有需要索引还需要创建 IndexLabel。
以下代码片段假定 Groovy 脚本已打开 HugeGraph 实例并将其绑定为 graph,同时设置遍历源 g = graph.traversal()。可从 Gremlin Console 本地模式示例开始;该页面的 scripts/example.groovy 会创建这两个变量。远程 Console 中的 g 是 Server 端遍历源别名,客户端本地没有 graph 对象;远程建模请使用本页之外的 Schema REST API。
2.1 Graph Schema
2.2 Graph Data
2.3 Indices
HugeGraph 默认是自动生成 Id,如果用户通过primaryKeys指定VertexLabel的primaryKeys字段列表后,VertexLabel的 Id 策略将会自动切换到primaryKeys策略。启用primaryKeys策略后,HugeGraph 通过vertexLabel+primaryKeys拼接生成VertexId ,可实现自动去重,同时无需额外创建索引即可以使用primaryKeys中的属性进行快速查询。例如 “character” 和 “location” 都有primaryKeys("name")属性,因此在不额外创建索引的情况下可以通过g.V().hasLabel('character') .has('name','hercules')查询 vertex。
3 Graph Traversal Examples
3.1 Traversal Query
1. Find the grandfather of hercules
也可以通过repeat方式:
2. Find the name of Hercules’s father
3. Find the characters with age > 100
4. Find who are pluto’s cohabitants
5. Find pluto can’t be his own cohabitant
6. Pluto’s Brothers
推荐使用HugeGraph-Hubble 通过可视化的方式来执行上述代码。另外也可以通过 HugeGraph-Client、HugeApi、GremlinConsole 和 GremlinDriver 等多种方式执行上述代码。
3.2 总结
HugeGraph 目前支持 Gremlin 的语法,用户可以通过 Gremlin / REST-API 实现各种查询需求。