这是本节的多页打印视图。 .
HugeGraph-AI
- 1: HugeGraph-LLM
- 2: HugeGraph-ML
- 3: HugeGraph-LLM 使用流程
- 4: 配置参考
- 5: HugeGraph-LLM REST API
- 6: Vermeer Python 客户端
- 7: HugeGraph-MCP
- 8: HugeGraph-LLM SDK 快速上手
hugegraph-ai 提供 HugeGraph 的 Python 客户端、图机器学习工具,以及面向知识图谱构建和 GraphRAG 的 LLM 工具。
Apache License 2.0 · Ask DeepWiki
模块
- hugegraph-llm-sdk:提供 Schema 设计、结构校验与属性图抽取审阅的独立 Python SDK。
- hugegraph-mcp:通过 MCP 向 AI 客户端提供图查询、Schema 和受控写入工具。
- hugegraph-llm:知识图谱构建、GraphRAG 和自然语言图查询。
- hugegraph-ml:从 HugeGraph 读取图数据并运行图学习模型。
- hugegraph-python-client:管理 Schema、图数据和 Gremlin 查询的 Python SDK。
- vermeer-python-client:调用 Vermeer 图计算服务的 Python SDK。
仓库使用 uv workspace,其成员是 hugegraph-llm-sdk、hugegraph-llm 和 hugegraph-python-client。hugegraph-ml 和 vermeer-python-client 是可编辑的路径依赖,不在 workspace members 中。当前仓库版本为 1.8.0。客户端源码目录叫 hugegraph-python-client,但发行包名是 hugegraph-python。
环境要求
- HugeGraph-AI 根目录 workspace:Python >= 3.12(支持 Python 3.12–3.14)
- HugeGraph-LLM 与 HugeGraph-LLM-SDK:Python >= 3.12(支持 Python 3.12–3.14)
- HugeGraph-ML:Python 3.10 或更高版本
- PyPI 上的
hugegraph-python1.5.0:Python 3.9 或更高版本;当前仓库源码随 workspace 使用 Python >= 3.12 - Vermeer Python 客户端:当前源码要求 Python 3.10 或更高版本;发行元数据仍声明
>=3.9,详见客户端页 uv0.7 或更高版本- HugeGraph Server 1.5.0 或更高版本;当前 workspace 的 Python 客户端会拒绝可探测到的更低版本
可选依赖组
根项目为每个模块声明一个 extra,另有几个组合项:
| Extra | 安装内容 |
|---|---|
llm | hugegraph-llm |
ml | hugegraph-ml |
python-client | hugegraph-python(源码目录 hugegraph-python-client) |
vermeer | vermeer-python-client |
dev | pytest、pytest-cov、coverage、pylint、ruff、mypy、ty、pre-commit |
nk-llm | hugegraph-llm、hugegraph-python-client,以及编译镜像所需的 Nuitka |
all | 四个模块包 |
hugegraph-llm 自身还声明了 vectordb extra,用于安装 pymilvus 和 qdrant-client。
Docker Compose 部署
仓库提供同时启动 HugeGraph Server 和 RAG 服务的 Compose 文件:
默认地址:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 界面:
http://localhost:8001
从源码启动 RAG 服务
uv sync 会在仓库根目录创建 .venv。从根目录安装可让 uv 一起解析 workspace 成员和路径依赖。当前仓库不跟踪 uv.lock;uv sync 会按 pyproject.toml 中的依赖声明和版本约束解析依赖。
安装 ML 依赖
示例脚本位于 hugegraph-ml/src/hugegraph_ml/examples/。
后续阅读
1 - HugeGraph-LLM
HugeGraph-LLM 用于知识图谱构建、GraphRAG 和自然语言图查询。演示服务把 Gradio 页面和 FastAPI 接口挂在同一个进程上,直接从源码启动时默认只监听本机 127.0.0.1:8001,可用 http://localhost:8001 访问。若显式启动源码入口且只需本机访问,可指定 --host 127.0.0.1;源码 Docker 镜像的 Dockerfile.llm 会覆盖默认值并监听 0.0.0.0:8001,不要在容器内改为 loopback,否则容器外无法通过映射端口访问。
生产环境必须为 HugeGraph-LLM 启用自身的登录认证(ENABLE_LOGIN=True,并替换 USER_TOKEN、ADMIN_TOKEN),同时在防火墙或网络入口设置来源 IP 白名单。HugeGraph Server 还必须单独开启认证与授权(见认证与授权说明)并保留 Server 审计日志(标准日志文件为 audit-*.log),为 GRAPH_USER 配置只具备该服务所需权限的账号。AI 服务 token 只认证 LLM 页面和 API,不能替代 HugeGraph Server 认证。
环境要求
AI 总结项目文档:Ask DeepWiki
- Python >= 3.12(支持 Python 3.12–3.14)
uv0.7 或更高版本- HugeGraph Server 1.5.0 或更高版本;当前 workspace 中的 Python 客户端会拒绝可探测到的更低版本
支持以下部署与运行方式:
- Docker Compose 部署 — 一键拉起 Server 与 HugeGraph-LLM 容器环境。
- Kubernetes 部署 — 基于 Helm 将 RAG 服务部署到 K8s 集群。
- 从源码启动 — 使用
uv配置 Python 环境并在本地运行 Gradio/FastAPI 服务。
Docker Compose 部署
在 HugeGraph-AI 仓库根目录准备环境文件:
启动后可访问:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 页面:
http://localhost:8001
Compose 文件会把 ${PROJECT_PATH}/hugegraph-llm/.env 挂载到容器内的 /home/work/hugegraph-llm/.env,因此该文件必须在容器启动前存在。资源目录 hugegraph-llm/src/hugegraph_llm/resources 也可以用同样方式挂载,该挂载默认被注释掉。
应用读取 GRAPH_URL,Compose 注入的 HUGEGRAPH_HOST 和 HUGEGRAPH_PORT 不会覆盖它;因此容器内要将 GRAPH_URL 设为 server:8080,并在 .env 中配置匹配 HugeGraph Server 的用户名和密码。
容器镜像
| 镜像 | 构建文件 | 内容 |
|---|---|---|
docker/Dockerfile.llm | 源码运行镜像构建配方,入口是 python -m hugegraph_llm.demo.rag_demo.app --host 0.0.0.0 --port 8001 | |
docker/Dockerfile.nk | 基于 nk-llm extra 用 Nuitka 编译的二进制镜像构建配方,入口是 ./app.dist/app.bin |
Compose 文件引用未指定标签的 hugegraph/rag,Docker 会使用默认的 latest 标签。scripts/build_llm_image.sh 则以 docker/Dockerfile.llm 在本地构建 hugegraph/graphrag:1.7.0。Compose 引用的 hugegraph/rag:latest 与本地构建的 hugegraph/graphrag:1.7.0 是不同镜像;本地构建不会自动替换 Compose 所用镜像。要在 Compose 中运行本地构建结果,需将 Compose 的 image 改为 hugegraph/graphrag:1.7.0。该脚本只构建镜像,不会推送。两个 Dockerfile 都声明 8001 端口、以非 root 用户 work 运行,并用 curl -f http://localhost:8001/ 做镜像健康检查;两者都为资源目录声明数据卷。
scripts/build_llm_image.sh 会用 docker/Dockerfile.llm 构建并打上 hugegraph/graphrag:1.7.0 标签。
Kubernetes 部署
docker/charts/hg-llm 是 RAG 服务的 Helm chart,部署 hugegraph/graphrag 镜像。默认发布 NodePort 类型的 Service,把节点端口 8039 和服务端口 8080 映射到容器端口 8001,名称固定为 hg-llm-service。Ingress 和水平自动扩缩容已定义但默认关闭。
该 chart 只部署 RAG 服务,不会部署 HugeGraph Server。挂载的 .env 中要把 GRAPH_URL 设为 Pod 可访问的 HugeGraph 地址,并配置匹配的用户名和密码。
chart 中 image.tag 仍默认为 v0.0.1。当前构建脚本生成的标签是本地 hugegraph/graphrag:1.7.0;部署前须确保同名镜像已推送到集群可访问的仓库,或已加载到集群节点,并将 chart 的标签和拉取策略设为匹配的值。
chart 的 values.yaml 中,.env 和提示词 YAML 的挂载默认被注释掉。提示词 YAML 可用 ConfigMap;.env 可能含有密钥和密码,应使用 Secret,并把 volumes 中 env-config 的 configMap 改为 secret。Secret 和提示词 ConfigMap 可分别创建:
随后取消 volumeMounts 段落的注释,并按需要启用提示词 ConfigMap 的 volumes 和挂载。Helm 模板会直接渲染 values.yaml 中的卷定义。
从源码启动
克隆源代码仓库:
安装依赖并激活虚拟环境:
启动 Web 应用服务:
自定义监听地址和端口:
设置 HG_DEV_RELOAD=1 可让 uvicorn 以自动重载方式启动,便于开发调试。
服务以 hugegraph-llm/.env 保存模型、HugeGraph 和登录配置。提示词放在 hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml。缺少文件时,配置代码会按默认值创建。
.env 路径按以下顺序解析:先看是否设置了 HUGEGRAPH_LLM_ENV_PATH;未设置时,从源码运行则使用 hugegraph-llm/.env;否则使用当前工作目录下的 .env。
主要功能
构建 RAG 索引
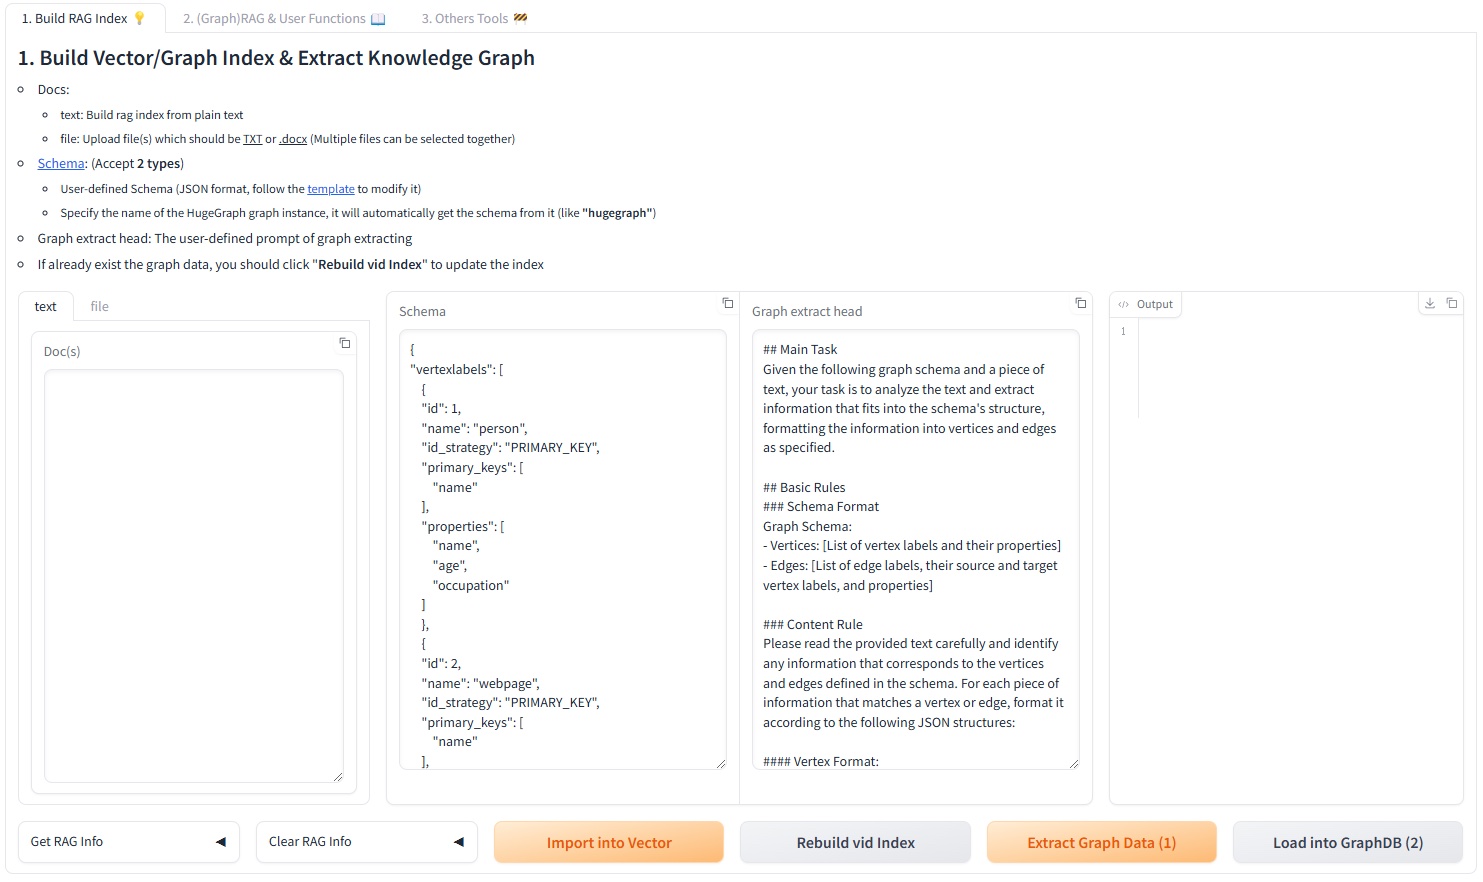
Web 页面的第一个标签页可以处理文本或文件,并执行以下操作:
- 切分文本并写入 chunk 向量索引。
- 按给定 Schema 从文本抽取顶点和边。
- 将抽取结果写入 HugeGraph,并更新顶点向量索引。
文本可以在 text 子页直接输入,也可以在 file 子页上传。上传支持 .txt、.docx 和 .pdf,并可一次选择多个文件。加密 PDF 以及没有可提取文本层的扫描件 PDF 会被拒绝。
Schema 可以是内联 JSON,也可以是现有图名。通过 REST API 使用图名时,必须同时传入匹配的 client_config.graph;内联 JSON 不会连接 HugeGraph,也不能附带 client_config。
该标签页还提供两个生成器。Graph Schema Generator 根据查询示例和少样本示例生成 Schema。Graph Extraction Prompt Generator 根据描述的场景和选定的参考示例生成抽取提示词。Graph Extraction Split Type 下拉框可在抽取前选择 document、paragraph 或 sentence 粒度。
GraphRAG
查询流程可以组合直接回答、chunk 向量召回和图召回。图召回先抽取关键词并匹配顶点,再尝试 Text2Gremlin;生成或执行失败时可回退到预定义的图遍历方式。请求参数可控制返回数量、向量距离阈值、模板数量和重排序方式。
同一标签页还有批量回归测试面板,可从 .xlsx 或 .csv 文件读取问题、逐条作答,并返回可下载的结果文件。上传控件旁提供模板文件下载。
Text2Gremlin
POST /text2gremlin 根据自然语言、图 Schema 和可选示例生成 Gremlin。自定义提示词必须保留 {query}、{schema}、{example} 和 {vertices} 四个占位符。
对应的页面标签可以先用问题与 Gremlin 对照文件(.json 或 .csv)构建示例向量索引。未上传文件时使用内置的 resources/demo/text2gremlin.csv。
图工具与管理工具
Graph Tools 标签页可直接执行 Gremlin 查询、手动触发图备份,以及初始化 HugeGraph 演示数据。Admin Tools 标签页在校验 ADMIN_TOKEN 后展示 logs/llm-server.log 的末尾内容,并可刷新或清空该文件。
进程运行期间还有两个后台任务:每天 01:00 执行图备份的定时任务,以及持续更新顶点 id 向量的任务。
模型与向量后端
聊天、信息抽取和 Text2Gremlin 可以分别使用 OpenAI 兼容接口、Ollama 或 LiteLLM。嵌入模型可独立选择,同样支持这三种提供方。重排序支持 Cohere 和 SiliconFlow。
默认向量索引使用 FAISS。CUR_VECTOR_INDEX 可选 Faiss、Milvus 或 Qdrant,Web 页面的 5. Set up the vector engine. 面板提供同样的选择。Milvus 和 Qdrant 需要安装可选依赖:
页面操作流程见使用流程,完整环境变量见配置参考,HTTP 请求格式见REST API。
程序化调用
原有的 RAGPipeline 和 KgBuilder 类已被流水线调度器取代。通过 SchedulerSingleton 按名称调用流程:
已注册的流程名包括 rag_raw、rag_vector_only、rag_graph_only、rag_graph_vector、text2gremlin、build_examples_index、build_vector_index、graph_extract、import_graph_data、update_vid_embeddings、get_graph_index_info、build_schema 和 prompt_generate。schedule_stream_flow 是对应的异步流式版本。
开发检查
先在仓库根目录安装模块和开发工具,再运行与 CI 一致的检查:
Git hook 通过 pre-commit 启用:
2 - HugeGraph-ML
HugeGraph-ML 从 HugeGraph 读取图数据并转换为 DGL 图,供节点嵌入、节点分类、图分类、链接预测和欺诈检测等任务使用。模型实现位于 hugegraph-ml/src/hugegraph_ml/models/。
环境要求
- Python 3.10 或更高版本
- HugeGraph Server 1.5.0 或更高版本;当前 workspace 中的 Python 客户端会拒绝可探测到的更低版本
uv0.7 或更高版本
所有服务端访问都通过同一仓库中的 hugegraph-python-client(即 pyhugegraph 包)完成。HugeGraph2DGL 使用 Gremlin 接口的 g.V().hasLabel(...) 和 g.E().hasLabel(...) 拉取点边,数据集导入函数则通过 schema 接口和顶点、边的批量接口写入,每批 500 条。
ML 依赖在仓库根目录的 [tool.uv] constraint-dependencies 中声明版本约束:
| 依赖 | 版本约束 |
|---|---|
torch | ==2.2.0 |
dgl | ~=2.1.0 |
ogb | ~=1.3.6 |
torchdata | ~=0.7.0 |
catboost | ~=1.2.3 |
category-encoders | ~=2.6.3 |
numpy | ~=1.24.4 |
pandas | ~=2.2.3 |
这些约束限定依赖版本,不指定 CPU 或 CUDA 构建。支持 gpu 参数的任务默认值 -1 表示使用 CPU;使用 GPU 时,需要安装彼此兼容的 CUDA 版 torch 和 dgl。
安装
HugeGraph-ML 是根项目的路径依赖,但不属于 uv workspace members。应在仓库根目录选择 ml extra,让 uv 按 workspace 配置安装它及其本地客户端依赖。
已实现模型
下列模块均位于 hugegraph-ml/src/hugegraph_ml/models/。models/__init__.py 不做任何再导出,需要直接从模块文件导入。
| 模型 | 模块 | 入口类 | 用途 | 论文 |
|---|---|---|---|---|
| AGNN | agnn.py | AGNN | 节点分类 | 1803.03735 |
| APPNP | appnp.py | APPNP | 节点分类 | 1810.05997 |
| ARMA | arma.py | ARMA4NC | 节点分类 | 1901.01343 |
| BGNN | bgnn.py | BGNNPredictor | 梯度提升与 GNN 结合处理节点特征,自带示例执行回归任务 | 2101.08543 |
| BGRL | bgrl.py | BGRL | 自监督节点嵌入 | 2102.06514 |
| CARE-GNN | care_gnn.py | CAREGNN | 欺诈检测 | 2008.08692 |
| Cluster-GCN | cluster_gcn.py | SAGE | 基于子图采样的节点分类 | 1905.07953 |
| C&S | correct_and_smooth.py | MLP、CorrectAndSmooth、LabelPropagation | 对基础预测结果做校正与平滑 | 2010.13993 |
| DAGNN | dagnn.py | DAGNN | 节点分类 | 2007.09296 |
| DeeperGCN | deepergcn.py | DeeperGCN | 带边特征的节点分类 | 2006.07739 |
| DGI | dgi.py | DGI | 自监督节点嵌入 | 1809.10341 |
| DiffPool | diffpool.py | DiffPool | 图分类 | 1806.08804 |
| GATNE | gatne.py | DGLGATNE | 异构网络嵌入 | 1905.01669 |
| GIN | gin_global_pool.py | GIN | 图分类 | |
| GRACE | grace.py | GRACE | 自监督节点嵌入 | 2006.04131 |
| GRAND | grand.py | GRAND | 节点分类 | 2005.11079 |
| JKNet | jknet.py | JKNet | 节点分类 | 1806.03536 |
| MLP | mlp.py | MLPClassifier | 基于已学习嵌入的下游分类器 | |
| P-GNN | pgnn.py | PGNN | 链接预测 | you19b |
| SEAL | seal.py | DGCNN、SEALData | 链接预测 | 1802.09691 |
GIN 的 pooling 参数可取 sum(默认)、mean、max、global_attention 和 set2set。
读取图数据
hugegraph-ml/src/hugegraph_ml/data/hugegraph2dgl.py 中的 HugeGraph2DGL 会创建 PyHugeClient,并把查询结果转换为 DGL 对象:
| 方法 | 返回值 | 说明 |
|---|---|---|
convert_graph(vertex_label, edge_label, feat_key="feat", label_key="label", mask_keys=None) | dgl.DGLGraph | mask_keys 为空时取 ["train_mask", "val_mask", "test_mask"] |
convert_hetero_graph(vertex_labels, edge_labels, feat_key="feat", label_key="label", mask_keys=None) | DGL 异构图 | 参数为标签列表 |
convert_graph_dataset(graph_vertex_label, vertex_label, edge_label, feat_key="feat", label_key="label") | HugeGraphDataset | info 中写入 n_graphs、max_n_nodes、n_feat_dim、n_classes |
convert_graph_nx(vertex_label, edge_label) | networkx.Graph | P-GNN 使用 |
convert_graph_with_edge_feat(vertex_label, edge_label, node_feat_key="feat", edge_feat_key="edge_feat", label_key="label", mask_keys=None) | dgl.DGLGraph | 同时填充 edata["feat"] |
convert_graph_ogb(vertex_label, edge_label, split_label) | (dgl.DGLGraph, split_edge) | SEAL 使用 |
convert_hetero_graph_bgnn(vertex_labels, edge_labels, feat_key="feat", label_key="class", cat_key="cat_features", mask_keys=None) | DGL 异构图 | BGNN 使用 |
节点特征写入 ndata["feat"],标签写入 ndata["label"],各掩码写入 ndata[<mask key>]。NodeEmbed 只要求 feat;NodeClassify、NodeClassifyWithEdge 和 NodeClassifyWithSample 要求 feat、label、train_mask、val_mask 和 test_mask,缺少任意一项都会抛出 ValueError。
导入示例数据集
hugegraph_ml.utils.dgl2hugegraph_utils 负责把 DGL、OGB 和 NetworkX 数据集写入 HugeGraph,供转换层读取。这些函数都接受与 HugeGraph2DGL 相同的 url、graph、user、pwd 和 graphspace 参数,并且多数会先把数据集名转为大写再匹配。
| 函数 | 支持的数据集 | 创建的标签 |
|---|---|---|
import_graph_from_dgl | CORA、CITESEER、PUBMED | <NAME>_vertex、<NAME>_edge |
import_graphs_from_dgl | MUTAG、COLLAB、NCI1、PROTEINS、PTC、ENZYMES、DD | <NAME>_graph_vertex、<NAME>_vertex、<NAME>_edge |
import_hetero_graph_from_dgl | ACM | <NAME>_<ntype>_v、<NAME>_<etype>_e |
import_hetero_graph_from_dgl_no_feat | AMAZONGATNE | <NAME>_<ntype>_v、<NAME>_<etype>_e |
import_hetero_graph_from_dgl_bgnn | AVAZU | <NAME>_<ntype>_v、<NAME>_<etype>_e |
import_graph_from_nx | CAVEMAN | <NAME>_vertex、<NAME>_edge |
import_graph_from_dgl_with_edge_feat | CORA、CITESEER、PUBMED | <NAME>_edge_feat_vertex、<NAME>_edge_feat_edge |
import_graph_from_ogb | ogbl-collab,不做大写转换 | <NAME>_vertex、<NAME>_edge |
import_split_edge_from_ogb | ogbl-collab,不做大写转换 | <NAME>_split_edge |
传入其他名称会抛出 ValueError("dataset not supported")。import_split_edge_from_ogb 还需要顶点导入返回的 idx_to_vertex_id 映射和 max_nodes 上限。
clear_all_data() 会清空目标图中的全部点和边。测试 fixture 先调用它,再导入 CORA、MUTAG 和 ACM,结束时再次调用。
AMAZONGATNE 和 AVAZU 不会自动下载,压缩包地址写在 import_hetero_graph_from_dgl_no_feat 和 import_hetero_graph_from_dgl_bgnn 上方的注释里。
任务
任务类位于 hugegraph-ml/src/hugegraph_ml/tasks/,均接收转换后的图和模型实例。
| 类 | 模块 | 入口方法 |
|---|---|---|
NodeEmbed | node_embed.py | train_and_embed(add_self_loop=True, lr=1e-3, weight_decay=0, n_epochs=200, patience=inf, gpu=-1),返回 ndata["feat"] 被替换为嵌入结果的图 |
NodeClassify | node_classify.py | 先 train(lr, weight_decay, n_epochs, patience, early_stopping_monitor, gpu),再 evaluate() 返回 {"accuracy": ..., "loss": ...} |
NodeClassifyWithEdge | node_classify_with_edge.py | 结构相同,适用于同时读取 edata["feat"] 的模型 |
NodeClassifyWithSample | node_classify_with_sample.py | 基于 ClusterGCNSampler 分区的训练,仅使用 CPU,没有 gpu 参数 |
GraphClassify | graph_classify.py | train(batch_size=20, lr, weight_decay, n_epochs, patience, early_stopping_monitor, clip=2.0, gpu),在 HugeGraphDataset 上按 70/20/10 划分 |
DetectorCaregnn | fraud_detector_caregnn.py | CARE-GNN 训练,evaluate() 输出 recall 和 ROC AUC,并读取 ndata["feature"] 而非 ndata["feat"] |
HeteroSampleEmbedGATNE | hetero_sample_embed_gatne.py | train_and_embed(lr=1e-3, n_epochs=200, gpu=-1) |
LinkPredictionPGNN | link_prediction_pgnn.py | train(lr, weight_decay, n_epochs, gpu) |
LinkPredictionSeal | link_prediction_seal.py | 构造函数内部已调用 data_prepare(),随后执行 train(lr=1e-3, n_epochs=200, gpu=-1) |
patience 默认值为 float("inf")。utils/early_stopping.py 中的 EarlyStopping 可以监控 loss 或 accuracy,保存最优权重并在训练结束时恢复。
可运行示例
脚本位于 hugegraph-ml/src/hugegraph_ml/examples/。在 hugegraph-ml/src 目录下执行:
每个脚本同时提供同名函数,可以导入后用较小的 epoch 数调用。
| 脚本 | 模型 | 任务 | 读取的标签 |
|---|---|---|---|
agnn_example.py | AGNN | NodeClassify | CORA_vertex、CORA_edge |
appnp_example.py | APPNP | NodeClassify | CORA_vertex、CORA_edge |
arma_example.py | ARMA4NC | NodeClassify | CORA_vertex、CORA_edge |
bgnn_example.py | BGNNPredictor | 模型自带的 fit() | AVAZU__N_v、AVAZU__E_e |
bgrl_example.py | BGRL | NodeEmbed、NodeClassify | CORA_vertex、CORA_edge |
care_gnn_example.py | CAREGNN | DetectorCaregnn | AMAZON_user_v 以及 AMAZON_net_upu_e、AMAZON_net_usu_e、AMAZON_net_uvu_e |
cluster_gcn_example.py | SAGE | NodeClassifyWithSample | CORA_vertex、CORA_edge |
correct_and_smooth_example.py | correct_and_smooth 中的 MLP | NodeClassify | CORA_vertex、CORA_edge |
dagnn_example.py | DAGNN | NodeClassify | CORA_vertex、CORA_edge |
deepergcn_example.py | DeeperGCN | NodeClassifyWithEdge | 通过 convert_graph_with_edge_feat 读取 CORA_vertex、CORA_edge |
dgi_example.py | DGI | NodeEmbed、NodeClassify | CORA_vertex、CORA_edge |
diffpool_example.py | DiffPool | GraphClassify | MUTAG_graph_vertex、MUTAG_vertex、MUTAG_edge |
gatne_example.py | DGLGATNE | HeteroSampleEmbedGATNE | AMAZONGATNE__N_v、AMAZONGATNE_1_e、AMAZONGATNE_2_e |
gin_example.py | GIN | GraphClassify | MUTAG_graph_vertex、MUTAG_vertex、MUTAG_edge |
grace_example.py | GRACE | NodeEmbed、NodeClassify | CORA_vertex、CORA_edge |
grand_example.py | GRAND | NodeClassify | CORA_vertex、CORA_edge |
jknet_example.py | JKNet | NodeClassify | CORA_vertex、CORA_edge |
pgnn_example.py | PGNN | LinkPredictionPGNN | CAVEMAN_vertex、CAVEMAN_edge |
seal_example.py | DGCNN | LinkPredictionSeal | ogbl-collab_vertex、ogbl-collab_edge、ogbl-collab_split_edge |
DGI 节点嵌入示例
先把 DGL 的 Cora 数据集导入 HugeGraph。数据集名会先转为大写,因此 cora 和 CORA 都会生成 CORA_vertex 和 CORA_edge 标签:
读取图并训练 DGI:
evaluate() 返回类似 {'accuracy': 0.82, 'loss': 0.5714246034622192} 的字典。完整脚本是 hugegraph-ml/src/hugegraph_ml/examples/dgi_example.py。
GRAND 节点分类示例
GRAND 每次增强采样都会返回一组 logits,NodeClassify 会对列表中的每个元素分别应用掩码后再计算损失。完整脚本是 hugegraph-ml/src/hugegraph_ml/examples/grand_example.py。
排查问题
- 连接失败:检查 HugeGraph Server 地址、端口和认证信息。
- Schema 不匹配:示例默认使用
CORA_vertex和CORA_edge,自有数据需要传入实际标签。 ValueError: Graph is missing required node attribute ...:节点分类任务需要ndata中包含feat、label、train_mask、val_mask和test_mask。请导入带掩码的数据集,或给convert_graph传入自定义的mask_keys。ValueError: dataset not supported:导入函数只接受上表列出的名称,且import_graph_from_ogb匹配ogbl-collab时不做大写转换。- DGL 或 PyTorch 导入失败:回到仓库根目录重新执行
uv sync --extra ml,并确认当前 Python 来自根目录.venv。 bgrl_example.py目前在导入阶段就会失败:它从hugegraph_ml.models.bgrl导入MLP_Predictor,而该模块中的类名是MLPPredictor。care_gnn_example.py读取AMAZON_user_v和三个AMAZON_net_*_e边标签,仓库内没有对应的导入函数,需要自行准备该数据集后再运行。
3 - HugeGraph-LLM 使用流程
本页按 Web 页面的操作顺序,说明如何建立索引、查询文档和生成 Gremlin。服务启动方式见 HugeGraph-LLM。
先准备可连接的 HugeGraph Server、生成模型和 Embedding 模型。查看配置或在 Graph Tools 手写 Gremlin 不需要模型;
文档向量化需要 Embedding,图数据抽取和答案生成还需要 LLM。Reranker 可选,初次运行可用本地 bleu。
| 想做什么 | 页面入口 | 需要准备什么 |
|---|---|---|
| 从文档建立索引 | 1. Build RAG Index | 文档、Embedding;抽取图数据还需 Schema 和 LLM |
| 根据文档或图回答问题 | 2. (Graph)RAG & User Functions | 对应索引和 LLM |
| 把问题转成 Gremlin | 3. Text2gremlin | 图 Schema、LLM;引用示例还需 Embedding 和示例索引 |
| 直接验证图数据 | 4. Graph Tools | HugeGraph 连接和手写 Gremlin |
本文截图基于 HugeGraph-LLM Web 界面,示例包含中英文提示词模式(通过环境变量 LANGUAGE 切换内置提示词语言,界面控件保持英文)。
若启动时报 FileNotFoundError,且缺少的文件为 questions_template.xlsx,在已安装依赖的仓库根目录创建输入模板后重启。
已有文件会保留。模板包含完整的 6 列,只填写测试问题和预期答案,4 个模型回答列留空。
0. 配置面板
标签页上方是可折叠的配置面板,共五个部分,包括 1. Set up the HugeGraph server.、2. Set up the LLM.、3. Set up the Embedding.、4. Set up the Reranker. 和 5. Set up the vector engine.。每部分都有独立的应用按钮,应用后会把受支持的字段写回 .env。页面顶部还会显示当前提示词语言。
在 LLM 配置的 chat、mini_tasks、text2gql 子页分别设置回答、抽取和查询生成模型。
截图使用本地 Ollama 的 qwen2.5:3b 和 mxbai-embed-large,向量引擎为 Faiss。
更换 Embedding 模型后需重建索引,避免新旧向量维数或含义不同。
1. 构建 RAG 索引
第一个标签页负责两类索引。
- 将文档切分后写入 chunk 向量索引。
- 按 Schema 从文档抽取顶点和边,写入 HugeGraph,并维护顶点向量索引。
flowchart TD
    A[输入文档] --> B[文本切分]
    B --> C[生成 chunk 向量]
    C --> D[写入向量索引]
    B --> E[LLM 按 Schema 抽取顶点和边]
    E --> F[写入 HugeGraph]
    F --> G[更新顶点向量索引]
输入来自 text 子页或 file 子页。上传支持 .txt、.docx 和 .pdf,可一次选择多个文件。
首次尝试可以使用下面的短文,填入 Input Doc(s)。请先选择专用测试图,避免将示例写入业务图。
将下面的 JSON 填入 Graph Schema,保留默认抽取提示词。它只允许抽取人物及室友关系,年龄和职业可为空。
页面包含文档、Schema、抽取提示词和结果区域。按下面的顺序建立图索引。只用向量检索时,完成第 1 步即可。
- 点击
Import into Vector,切分文档并建立 chunk 向量索引。 - 在
Graph Schema填入 Schema JSON 或已有图名,再点击Extract Graph Data (1)。检查Output Info中的顶点、边和属性。 - 确认抽取结果后点击
Load into GraphDB (2),写入 HugeGraph 并更新顶点向量。 - 打开
Graph Tools,执行g.V().count()和g.E().count(),再查具体属性,确认数据已写入。
本例应得到 2 个顶点和 1 条边,Sarah 的年龄为 30,职业为 attorney。
图里已经有数据时,可以单独点击 Update Vid Embedding 更新顶点索引。
这些按钮旁的 Graph Extraction Split Type 下拉框可选 document、paragraph 或 sentence。document 把输入整体作为一个单元,另外两种会在抽取前先切分长文档。
页面还可以查看或清除 chunk 索引、顶点索引和图数据。清除操作会删除已有数据,执行前先确认当前图和索引是否仍被其他查询使用。
主控件下方还有两个折叠的辅助工具。
Graph Schema Generator根据查询示例和少样本示例生成 Schema,填入 Graph Schema 字段。Graph Extraction Prompt Generator根据期望场景(例如社交关系、金融知识图谱)和选定的参考示例生成 Graph Extract Prompt Header。
2. GraphRAG 查询
第二个标签页提供四种回答范围,按需要选择对应索引。
| 控件 | 回答依据 |
|---|---|
Basic LLM Answer | 直接调用 LLM,不查询文档或图 |
Vector-only Answer | chunk 向量检索结果 |
Graph-only Answer | 图检索结果 |
Graph-Vector Answer | 图与 chunk 向量检索结果 |
推荐优先使用 Graph-Vector Answer,同时结合图数据检索与文档向量索引以获得更完整的事实支撑。其他范围的控件含义见上表。
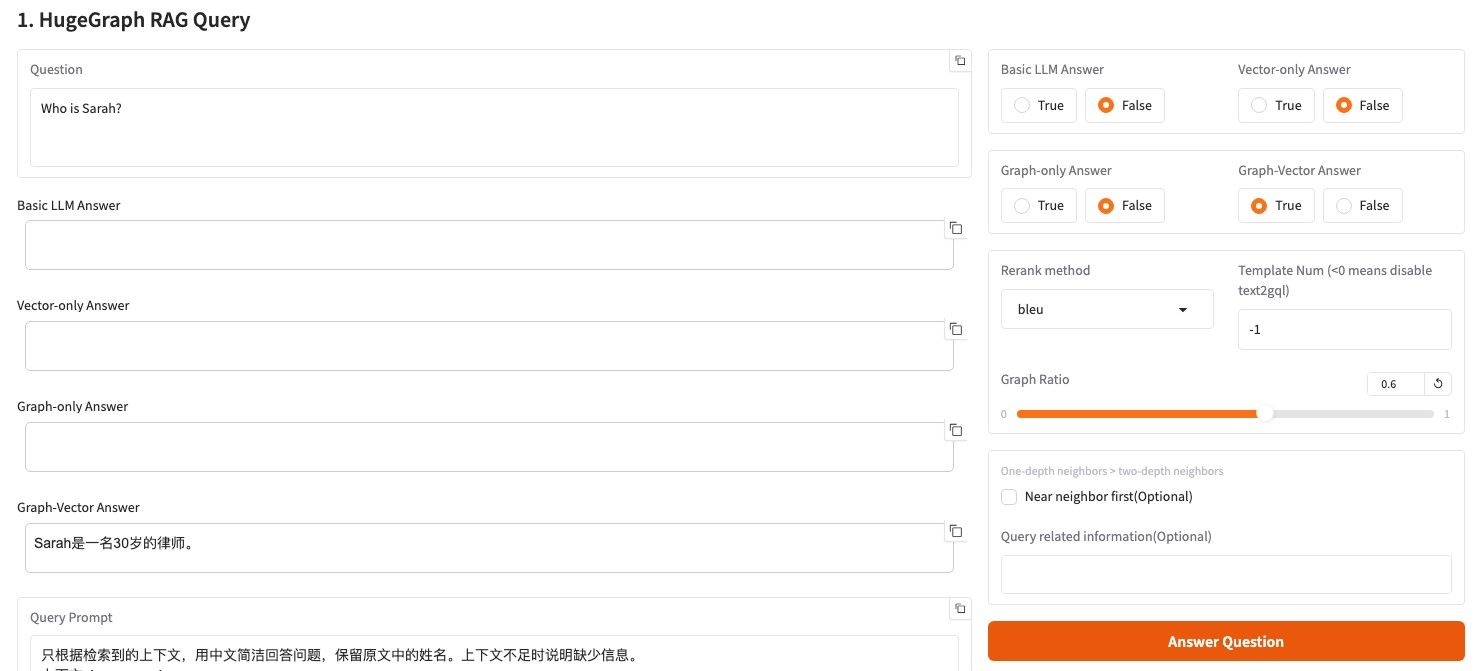
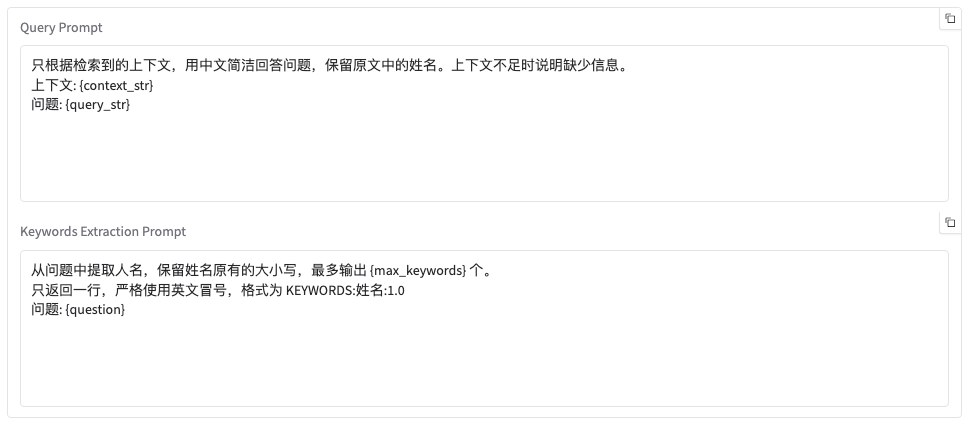
截图使用下面的简短提示词。分别填入 Query Prompt 和 Keywords Extraction Prompt,其中占位符会由服务替换。
关键词输出需使用代码块中的英文前缀和冒号,姓名的大小写应与图数据一致。
- 输入
Who is Sarah?,将Graph-only Answer设为False,Graph-Vector Answer设为True。 - 初次验证时保留
Template Num=-1和Rerank method=bleu,点击Answer Question。 - 查看
Graph-Vector Answer,将答案中的职业、年龄等事实与原文和图数据核对。
flowchart TD
    Q[问题] --> V[查询 chunk 向量索引]
    Q --> K[抽取关键词]
    K --> M[匹配图顶点]
    M --> D{启用 Text2Gremlin}
    D -->|是| T[生成并执行 Gremlin]
    D -->|否| B[BFS 图遍历]
    T -->|失败| B
    T --> R[整理图结果]
    B --> R
    V --> S[合并与重排序]
    R --> S
    S --> A[生成答案]
图召回先用关键词精确匹配 HugeGraph 顶点,找不到时再用顶点向量做近似匹配。匹配结果会进入 Text2Gremlin;生成或执行失败时,流程可以回退到预定义的图遍历。
Template Num 控制 Text2Gremlin 在图召回中的参与方式。
- 小于 0 时,完全跳过 Text2Gremlin,图召回直接使用预定义的图遍历。
- 等于 0 时,不检索参考示例,使用基础生成结果。
- 大于 0 时,从示例索引中取相应数量的相近示例,并采用带模板的生成结果。示例数量会被限制在 0 到 10 之间。
该标签页的其他控件还有 Rerank method(bleu 或 reranker)、Graph Ratio、Near neighbor first 和 Query related information,以及可编辑的 Query Prompt 和 Keywords Extraction Prompt。
单条问答面板下方是批量回归测试面板。上传 .xlsx 或 .csv 问题文件,设置 Max Lines To Show,点击 Generate Answer (Batch)。答案会显示在预览表格中,并可下载为文件。上传控件旁提供模板文件下载。
3. Text2Gremlin
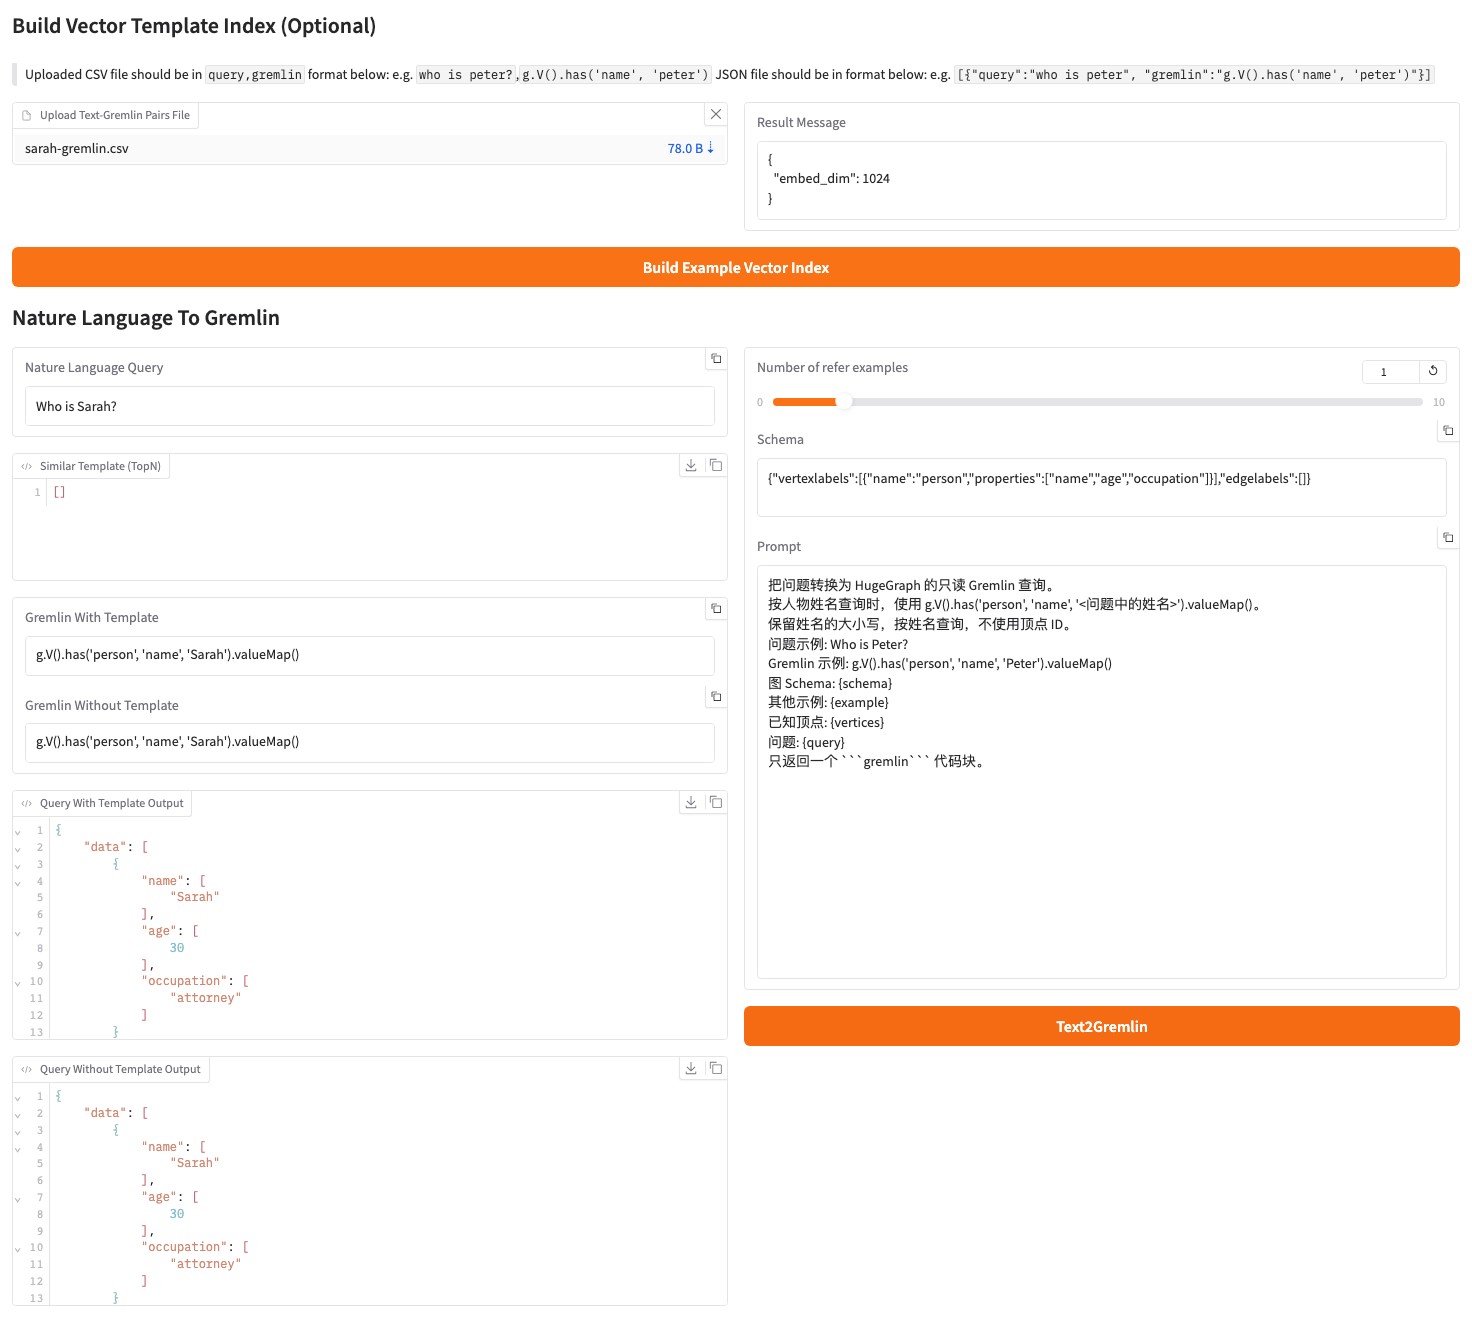
第三个标签页将自然语言转换为 Gremlin,并执行生成的查询。上半部分用 .json 或 .csv 的问题与 Gremlin 对建立示例向量索引;
未上传文件时使用内置的 resources/demo/text2gremlin.csv。示例中的标签和属性应与当前图一致。
若上传 CSV 构建示例向量索引后未自动召回示例模板,可直接在下面的 Prompt 模板中手动提供 Few-shot 参考示例。
复现 Sarah 查询时,使用以下输入。
- 将下面的 CSV 保存为
sarah-gremlin.csv,上传后点击Build Example Vector Index,并把Number of refer examples设为1。 - 在
Schema填入下方的简化 Schema,只保留查询所需的类型与属性。 - 在
Prompt填入下方的提示词,输入问题Who is Sarah?,再点击Text2Gremlin。 - 检查生成语句及两组
Query ... Output。本例返回 Sarah 的age=30和occupation=attorney。
小模型可能生成错误 ID、大小写不符的姓名或不满足索引条件的过滤语句。应查看执行结果中的具体数据,再判断查询是否成功。 Web 页面会直接执行生成的语句,请使用专用测试图。需要只生成语句时,在 REST API 中选择相应输出类型。
自定义提示词必须保留 {query}、{schema}、{example} 和 {vertices}。缺少任一占位符时,REST API 会拒绝请求。
4. 图工具与管理工具
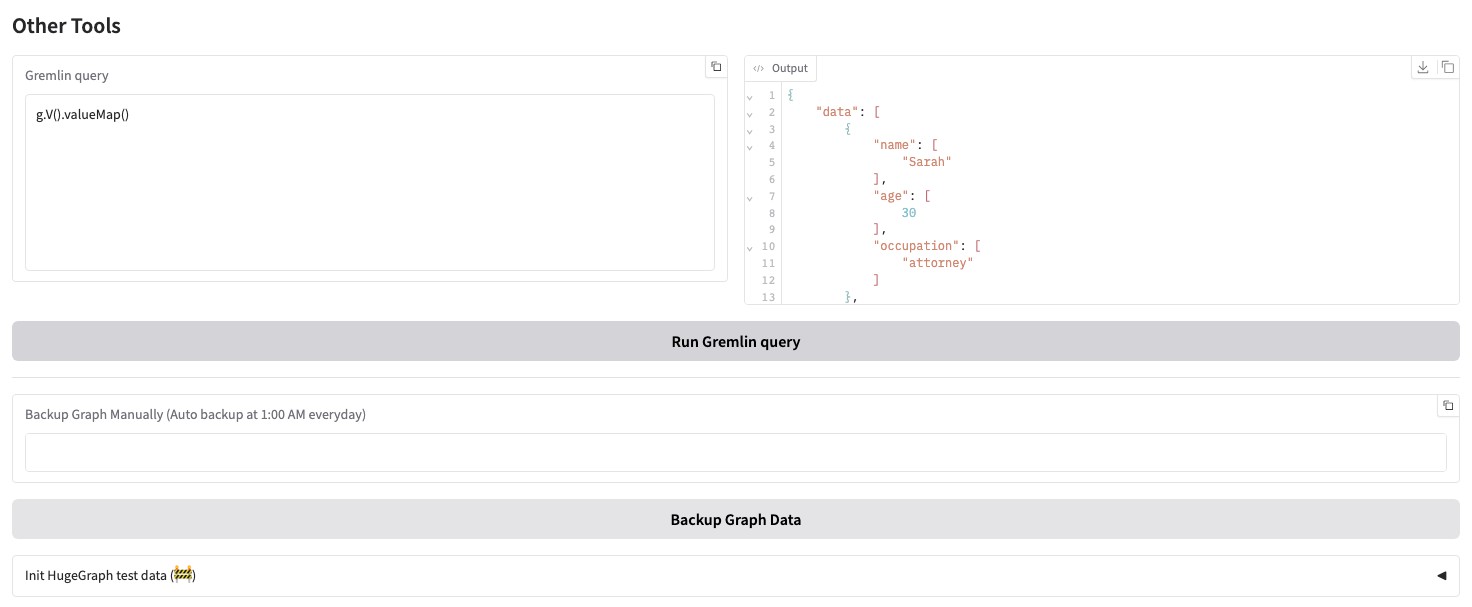
Graph Tools 标签页可直接对当前图执行 Gremlin 查询、手动触发图备份,并通过 beta 操作初始化 HugeGraph 演示数据。后台还有两个任务,每天凌晨 1 点自动备份图数据,以及在进程运行期间持续更新顶点 id 向量。
初始化演示数据会先清空当前图,只能在专用测试图上使用。
Admin Tools 需要密码。输入已配置的 ADMIN_TOKEN 后可查看 logs/llm-server.log 的末尾内容(每 60 秒自动刷新),并可手动刷新或清空该文件。ADMIN_TOKEN 为空或仍是占位值 xxxx 时,访问会被拒绝。
设置 ENABLE_LOGIN=True 后,Web 页面会要求基础认证,用户名固定为 rag,密码是 USER_TOKEN;REST API 则要求把 USER_TOKEN 作为 Bearer token。日志接口还要求单独配置安全的 ADMIN_TOKEN。
生产环境必须启用 HugeGraph-LLM 自身的登录认证,并替换 USER_TOKEN 和 ADMIN_TOKEN,同时在防火墙或网络入口设置来源 IP 白名单。HugeGraph Server 还必须单独开启认证与授权(见认证与授权说明)并保留 Server 审计日志(标准日志文件为 audit-*.log),为 GRAPH_USER 配置最小必要权限。AI 服务 token 不会替代 HugeGraph Server 认证。
5. 提示词语言
在 hugegraph-llm/.env 中选择一种提示词语言。
修改后重启服务。该配置选择内置提示词语言,不会自动翻译输入文档,也不属于 /rag 请求体字段。
6. REST 调用
Web 页面和 REST API 使用同一套流程。需要程序集成时使用 /rag、/rag/graph、/graph/extract 和 /text2gremlin;请求结构见 REST API。
4 - 配置参考
HugeGraph-LLM 从 .env 读取运行配置,提示词单独保存在 config_prompt.yaml。两者使用不同的路径解析规则;不要把提示词文件当作 .env 的一部分。
.env 路径按以下顺序解析:
- 若设置了环境变量
HUGEGRAPH_LLM_ENV_PATH,则使用该路径,开头的~会被展开。 - 从源码运行时,使用
hugegraph-llm/.env。 - 以已安装的包运行时,使用当前工作目录下的
.env。
该路径在导入配置模块时确定。设置 HUGEGRAPH_LLM_ENV_PATH 时,需在启动 Python 进程前设置;不能只把它写进将要读取的 .env 文件。覆盖路径使用相对路径时,以进程当前工作目录为基准。
提示词 YAML 路径按以下顺序解析:
- 若进程环境中设置了
HUGEGRAPH_LLM_PROMPT_CONFIG_PATH,使用该路径,并展开开头的~。 - 从源码运行时,使用
hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml。 - 以已安装的包运行时,使用
${XDG_CONFIG_HOME:-~/.config}/hugegraph-llm/config_prompt.yaml。
覆盖路径的环境变量也要在进程启动前设置。相对路径以进程当前工作目录为基准。源码 Docker 镜像通过 PYTHONPATH 指向源码目录,因此默认提示词路径仍位于 hugegraph-llm/src/hugegraph_llm/resources/demo/。
运行以下命令可按配置类的默认值创建或更新文件:
--update 默认开启,因此不带参数运行效果相同。配置模块首次导入时会为缺失的 .env 和提示词 YAML 按默认值创建文件;文件已存在时,生成器会交互询问是否覆盖。该命令会处理 HugeGraph、管理员、LLM、索引配置及提示词 YAML,不会在无确认的情况下覆盖已有文件。
.env 包含密钥和密码,不要提交到版本库。
基础选项
| 配置项 | 默认值 | 说明 |
|---|---|---|
LANGUAGE | EN | 提示词语言,可选 EN、CN |
CHAT_LLM_TYPE | openai | 回答模型,可选 openai、litellm、ollama/local |
EXTRACT_LLM_TYPE | openai | 信息抽取模型,取值同上 |
TEXT2GQL_LLM_TYPE | openai | Text2Gremlin 模型,取值同上 |
EMBEDDING_TYPE | openai | 嵌入模型,取值同上,也可以留空 |
RERANKER_TYPE | 空 | 可选 cohere、siliconflow |
KEYWORD_EXTRACT_TYPE | llm | 可选 llm、textrank、hybrid |
WINDOW_SIZE | 3 | TextRank 滑窗,范围 1 到 10 |
HYBRID_LLM_WEIGHTS | 0.5 | hybrid 模式中 LLM 结果的权重,范围 0 到 1 |
OpenAI 兼容接口
聊天、抽取和 Text2Gremlin 可以使用不同端点、密钥和模型。
| 用途 | API 地址 | 密钥 | 模型 | 最大 token 默认值 |
|---|---|---|---|---|
| 回答 | OPENAI_CHAT_API_BASE | OPENAI_CHAT_API_KEY | OPENAI_CHAT_LANGUAGE_MODEL | OPENAI_CHAT_TOKENS=8192 |
| 抽取 | OPENAI_EXTRACT_API_BASE | OPENAI_EXTRACT_API_KEY | OPENAI_EXTRACT_LANGUAGE_MODEL | OPENAI_EXTRACT_TOKENS=256 |
| Text2Gremlin | OPENAI_TEXT2GQL_API_BASE | OPENAI_TEXT2GQL_API_KEY | OPENAI_TEXT2GQL_LANGUAGE_MODEL | OPENAI_TEXT2GQL_TOKENS=4096 |
| 嵌入 | OPENAI_EMBEDDING_API_BASE | OPENAI_EMBEDDING_API_KEY | OPENAI_EMBEDDING_MODEL | 不适用 |
API 地址默认是 https://api.openai.com/v1;三个语言模型默认是 gpt-4.1-mini,嵌入模型默认是 text-embedding-3-small。
OPENAI_BASE_URL 和 OPENAI_API_KEY 可作为通用回退值。嵌入模型另有 OPENAI_EMBEDDING_BASE_URL 和 OPENAI_EMBEDDING_API_KEY 回退值。
LiteLLM
| 用途 | API 地址 | 密钥 | 模型 | 最大 token 默认值 |
|---|---|---|---|---|
| 回答 | LITELLM_CHAT_API_BASE | LITELLM_CHAT_API_KEY | LITELLM_CHAT_LANGUAGE_MODEL | LITELLM_CHAT_TOKENS=8192 |
| 抽取 | LITELLM_EXTRACT_API_BASE | LITELLM_EXTRACT_API_KEY | LITELLM_EXTRACT_LANGUAGE_MODEL | LITELLM_EXTRACT_TOKENS=256 |
| Text2Gremlin | LITELLM_TEXT2GQL_API_BASE | LITELLM_TEXT2GQL_API_KEY | LITELLM_TEXT2GQL_LANGUAGE_MODEL | LITELLM_TEXT2GQL_TOKENS=4096 |
| 嵌入 | LITELLM_EMBEDDING_API_BASE | LITELLM_EMBEDDING_API_KEY | LITELLM_EMBEDDING_MODEL | 不适用 |
三个语言模型默认是 openai/gpt-4.1-mini,嵌入模型默认是 openai/text-embedding-3-small。模型名通常使用 供应商/模型 格式,具体取值由 LiteLLM 服务决定。
Ollama
| 用途 | 主机 | 端口 | 模型 |
|---|---|---|---|
| 回答 | OLLAMA_CHAT_HOST | OLLAMA_CHAT_PORT | OLLAMA_CHAT_LANGUAGE_MODEL |
| 抽取 | OLLAMA_EXTRACT_HOST | OLLAMA_EXTRACT_PORT | OLLAMA_EXTRACT_LANGUAGE_MODEL |
| Text2Gremlin | OLLAMA_TEXT2GQL_HOST | OLLAMA_TEXT2GQL_PORT | OLLAMA_TEXT2GQL_LANGUAGE_MODEL |
| 嵌入 | OLLAMA_EMBEDDING_HOST | OLLAMA_EMBEDDING_PORT | OLLAMA_EMBEDDING_MODEL |
主机默认是 127.0.0.1,端口默认是 11434,模型名没有默认值。使用前先在 Ollama 中拉取对应模型。
重排序
| 配置项 | 默认值 | 说明 |
|---|---|---|
COHERE_BASE_URL | https://api.cohere.com/v1/rerank | Cohere rerank 接口;CO_API_URL 可作为回退值 |
RERANKER_API_KEY | 空 | Cohere 或 SiliconFlow 密钥 |
RERANKER_MODEL | 空 | 服务端支持的模型名 |
HugeGraph 连接与召回限制
| 配置项 | 默认值 | 说明 |
|---|---|---|
GRAPH_URL | 127.0.0.1:8080 | HugeGraph 地址,不拆分为 IP 和端口 |
GRAPH_NAME | hugegraph | 图名 |
GRAPH_USER | admin | 用户名 |
GRAPH_PWD | xxx | 密码 |
GRAPH_SPACE | 空 | GraphSpace 名称 |
LIMIT_PROPERTY | False | 是否限制返回属性;配置类按字符串读取 |
MAX_GRAPH_PATH | 10 | 最大图路径长度 |
MAX_GRAPH_ITEMS | 30 | 图召回的最大项目数 |
EDGE_LIMIT_PRE_LABEL | 8 | 每个边标签的返回上限 |
VECTOR_DIS_THRESHOLD | 0.9 | 向量距离阈值;超过阈值的结果会被忽略 |
TOPK_PER_KEYWORD | 1 | 每个关键词的候选数 |
TOPK_RETURN_RESULTS | 20 | 重排序后返回的结果数 |
向量索引后端
| 配置项 | 默认值 | 说明 |
|---|---|---|
CUR_VECTOR_INDEX | Faiss | 当前使用的向量库:Faiss、Milvus 或 Qdrant |
QDRANT_HOST | 空 | |
QDRANT_PORT | 6333 | |
QDRANT_API_KEY | 空 | |
MILVUS_HOST | 空 | |
MILVUS_PORT | 19530 | |
MILVUS_USER | 空 | |
MILVUS_PASSWORD | 空 |
FAISS 在本地运行,无需额外依赖。未安装可选依赖就选择 Milvus 或 Qdrant 时,会报错并指出缺少的包,因此需要先安装:
Web 页面的 5. Set up the vector engine. 面板提供同样的选择,并会保存所选引擎的连接配置。
登录与日志接口
| 配置项 | 默认值 | 说明 |
|---|---|---|
ENABLE_LOGIN | False | 是否要求 Bearer token;配置类按字符串读取 |
USER_TOKEN | 4321 | Web 页面和普通 API 的 token |
ADMIN_TOKEN | xxxx | /logs 使用的管理员 token |
ADMIN_TOKEN 为空或仍为 xxxx 时,/logs 会直接返回 403。
生产环境必须设置 ENABLE_LOGIN=True,替换 USER_TOKEN 和 ADMIN_TOKEN,并通过防火墙或网络入口设置来源 IP 白名单。这只保护 HugeGraph-LLM;HugeGraph Server 还必须单独开启认证与授权(见认证与授权说明)并保留 Server 审计日志(标准日志文件为 audit-*.log),为 GRAPH_USER 设置最小必要权限。两端使用不同的认证凭据。
最小 OpenAI 配置
配置加载
配置类先提供代码默认值。当前实现会在初始化时把所选 .env 中的值写入进程环境,再初始化配置对象;若 shell 中已经有同名变量,文件中的值会覆盖它。缺少的键使用配置类默认值,空值会被忽略,未知键会被忽略。Web 页面和配置 API 可以在运行时更新当前设置,并把受支持的字段同步回 .env。手工改动 .env 后应重启服务;提示词 YAML 会在服务启动或页面加载时读取。
键名匹配不区分大小写。
配置定义位于:
hugegraph-llm/src/hugegraph_llm/config/llm_config.pyhugegraph-llm/src/hugegraph_llm/config/hugegraph_config.pyhugegraph-llm/src/hugegraph_llm/config/index_config.pyhugegraph-llm/src/hugegraph_llm/config/admin_config.pyhugegraph-llm/src/hugegraph_llm/config/prompt_config.pyhugegraph-llm/src/hugegraph_llm/config/models/base_config.py:加载与文件同步逻辑
5 - HugeGraph-LLM REST API
HugeGraph-LLM 演示进程同时提供 Web 页面和 REST API。默认地址是 http://localhost:8001:
所有接口都使用 POST:
| 路径 | 成功状态码 | 用途 |
|---|---|---|
/rag | 200 | 按所选召回方式回答问题 |
/rag/graph | 200 | 只做图召回,不生成最终答案 |
/graph/extract | 200 | 从文本抽取顶点和边 |
/text2gremlin | 200 | 由自然语言生成 Gremlin |
/config/graph | 201 | 更新 HugeGraph 连接 |
/config/llm | 201 | 更新语言模型 |
/config/embedding | 201 | 更新嵌入模型 |
/config/rerank | 201 | 更新重排序模型 |
/logs | 200 | 流式返回服务日志 |
认证
在 .env 中启用登录:
启用后,请求需要 Bearer token:
同一开关也会给 Gradio 页面加上基础认证,用户名固定为 rag,密码是 USER_TOKEN。token 不正确时返回 401,并带上 WWW-Authenticate: Bearer 响应头。ENABLE_LOGIN 保持 False 时所有接口都不做鉴权。
生产环境必须启用 HugeGraph-LLM 自身的登录认证,并在防火墙或网络入口设置来源 IP 白名单。该认证只保护 HugeGraph-LLM 的页面和 REST API;HugeGraph Server 还必须单独开启认证与授权(见认证与授权说明)并保留 Server 审计日志(标准日志文件为 audit-*.log),为 GRAPH_USER 配置最小必要权限。USER_TOKEN 不会替代 Server 认证。
RAG
POST /rag
根据开关返回一种或多种回答。未显式指定时只启用 graph_only。
响应只包含已启用的回答字段:
其他可选参数包括 graph_ratio(默认 0.5)、rerank_method(bleu 或 reranker,默认 bleu)、near_neighbor_first(默认 false)、custom_priority_info,以及三个自定义提示词字段 answer_prompt、keywords_extract_prompt 和 gremlin_prompt。省略提示词字段时使用 config_prompt.yaml 中的值。
gremlin_tmpl_num 决定图召回阶段 Text2Gremlin 的执行方式:小于 0 表示跳过 Text2Gremlin,直接使用预定义的图遍历;等于 0 表示不带示例生成 Gremlin;大于 0 表示从示例索引中取相应数量的示例。
query 为空或只有空白字符时返回 400。
POST /rag/graph
只执行图召回,不生成最终自然语言答案:
响应的 graph_recall 可能包含 query、keywords、match_vids、graph_result_flag、gremlin、graph_result 和 vertex_degree_list。设置 get_vertex_only=true 可在顶点匹配后提前返回,此时接口会把 match_vids 替换为完整的顶点详情。
query 为空返回 400,请求类型错误返回 400,其他失败返回 500。
图抽取
POST /graph/extract
使用内联 Schema 时不会连接 HugeGraph:
请求字段:
| 字段 | 默认值 | 说明 |
|---|---|---|
texts | 必填 | 字符串或字符串数组;空白项会被丢弃,全部为空时报错 |
schema | 必填 | 内联 JSON 对象或字符串,或现有图名 |
example_prompt | 提示词 YAML 中的值 | 抽取提示词头部 |
extract_type | property_graph | 目前仅接受该值 |
language | zh | zh 或 en,用于文本切分 |
split_type | document | document、paragraph 或 sentence |
include_meta | false | 在 meta 中加入 vertex_count、edge_count 和 text_count |
review_options | 无(禁用) | 可选 JSON 对象,启用多轮模型审阅与有限修复:max_reviews、max_fixes、max_workers |
client_config | 无 | 仅在 schema 为图名时允许传入 |
内联 Schema 必须是包含 vertexlabels 和 edgelabels 两个列表的对象。每个顶点标签需要非空的 name 和非空的 properties 列表;每条边标签需要非空的 name、source_label 和 target_label。propertykeys 可选,若存在必须是列表。
若 schema 传现有图名,必须同时传入 client_config,且 client_config.graph 必须和图名相同。这里的 client_config 只接受 graph、user、pwd 和 gs,未知字段会被拒绝,且没有 url 字段:
模型审阅与修复(review_options)
传入 review_options 可为每个切分后的文本块启用迭代式模型审阅与有限 Schema 自动修复:
max_reviews(默认2,范围0–5):每个文本块允许的最大模型审阅轮数。max_fixes(默认1,范围0–3):每个文本块允许的最大自动修复尝试次数。max_workers(默认4,范围1–8):并发处理文本块的工作线程数。- 传入
{}使用上述默认值;省略review_options或设为null则保持旧版直接抽取且不审阅。
响应格式说明
省略 review_options 时,HTTP 200 响应中的 status 始终为 succeeded。开启 review_options 后:
- 全局
status综合各分块状态计算:succeeded(所有分块达成 final)、partial(部分分块达成 final)或failed(没有任何分块达成 final)。 - 仅达成
final状态的分块会被汇总合并到顶层result.vertices与result.edges。 - 响应体包含
chunk_results列表,记录每个文本块的具体执行结果:index:文本块在输入序列中的 0 起始索引。status:final(通过结构校验与模型审阅)、candidate(通过校验但审阅配额耗尽)、blocked(Schema 约束无法修复或被审阅拦截)或failed(调用异常或截断)。graph:当前抽取的子图数据对象(vertices与edges),失败时为null。issues:校验或审阅中发现的问题列表,包含path、message及可选的原文evidence。reason与stage:失败原因与发生阶段(prepare、extract、validate、review或repair)。reviews_used、fixes_used与llm_calls:记录该文本块消耗的大模型调用计数。
Text2Gremlin
POST /text2gremlin
output_types 可包含:
match_resulttemplate_gremlinraw_gremlintemplate_execution_resultraw_execution_result
省略该字段时默认只返回 template_gremlin;传空数组表示由实现返回全部输出。自定义 gremlin_prompt 必须包含 {query}、{schema}、{example} 和 {vertices},缺少占位符时请求校验失败,并会列出缺失的占位符。
example_num 默认是 0,表示不使用模板,取值会被限制在 0 到 10 之间。client_config 只在单次请求内覆盖 HugeGraph 连接,生成时使用的 Schema 是当前生效的图名。query 为空返回 400,生成失败返回 500。
运行时配置
POST /config/graph
user 和 pwd 默认是空字符串,gs 可选。
POST /config/llm 与 POST /config/embedding
两个端点使用同一个请求模型。/config/llm 会把 chat_llm_type、extract_llm_type 和 text2gql_llm_type 一起设为相同的值;要分别设置各任务的类型,只能通过 .env 或 Web 页面。OpenAI 或 LiteLLM 示例:
Ollama 请求仍要提供公共字段;api_key 和 api_base 可传空字符串:
POST /config/rerank
reranker_type 可选 cohere、siliconflow。Cohere 还可以传 cohere_base_url。
四个配置端点成功时都返回 201。它们会改动进程当前配置,并可能同步到 .env。/config/llm、/config/embedding 和 /config/rerank 在应用过程中抛出异常时会回滚到原有取值,/config/graph 不会。
/rag、/rag/graph 和 /text2gremlin 的 client_config 只在单次请求期间覆盖 HugeGraph 连接,且仅应用请求中实际出现的字段。当前实现仍会临时改动进程全局设置,不适合用不同连接并发发起长请求。
日志
POST /logs
该接口要求 .env 中的 ADMIN_TOKEN 已改成安全值。请求体示例:
log_file 默认是 llm-server.log,只能是 logs/ 目录下的文件名,不能是绝对路径、不能包含路径分隔符,也不能解析为 . 或 ..。非法文件名返回 400。
ADMIN_TOKEN 未设置或仍是占位值时,在比对 token 之前就返回 403;token 不匹配时返回内容为 Invalid admin_token 的 403 响应。
成功时返回 text/plain 流:先回放文件末尾 125 行,然后像 tail -f 一样持续输出新内容。
6 - Vermeer Python 客户端
vermeer-python-client 是 Vermeer 的 Python SDK。Vermeer 是使用 Go 编写、以内存计算为主的图计算引擎。该 SDK 封装了 Vermeer master 的 REST API,可以在 Python 中列出图、提交加载和计算任务、读取任务状态。导入时使用的包名是 pyvermeer。
模块没有固定 Vermeer 服务端版本,它通过 HTTP 访问 Vermeer master,调用的接口见 API 概览。
环境要求
- 当前源码实际要求 Python 3.10 或更高版本;虽然该模块打包元数据声明
>=3.9,代码中的类型标注使用了 Python 3.10 语法 - 一个可通过 HTTP 访问的 Vermeer master。默认 HTTP 端口为
6688;Docker 部署需发布6688:6688,见 Vermeer 快速上手。 uv(推荐)或pip
运行时依赖:requests、urllib3、python-dateutil、decorator、rich 和 setuptools。
安装
打包元数据中的发行包名是 vermeer-python-client,其版本号独立于仓库版本号管理。该包尚未发布到 PyPI,请从源码安装。
在 HugeGraph-AI 仓库根目录,使用 vermeer extra 把它安装到共用的虚拟环境中:
vermeer-python-client 是以可编辑路径依赖的方式接入的,并不是 uv workspace member,因此在仓库根目录直接执行 uv sync 不会安装它,必须显式指定该 extra(或使用 --all-extras)。
单独安装该模块:
连接 Vermeer master
构造函数参数:
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
ip | str | 必填 | Vermeer master 的主机名或 IP 地址 |
port | int | 必填 | Vermeer master 的 REST 端口 |
token | str | 必填 | 原样作为 Authorization 请求头发送 |
timeout | (float, float) 或 None | None | 连接超时和读取超时,单位为秒 |
log_level | str | "INFO" | 应用到共享 VermeerClient 日志器的级别 |
如果 Python 客户端运行在宿主机,ip 填宿主机可访问的 master 地址;如果运行在容器中,则填容器网络内的 master 地址。客户端只连接 master 的 HTTP API,HugeGraph PD/Store 地址则必须能由执行加载任务的 Vermeer 节点访问。
连接前需要了解的行为:
- 当 master 不校验鉴权时,
token可以是空字符串,但不能是None,否则会话会抛出ValueError("Vermeer Token must be provided.")。 timeout是(连接超时, 读取超时)二元组。VermeerConfig自身的默认值是(0.5, 15.0),但客户端总是把自己的参数传下去,因此不传timeout时实际存入的是None,请求会一直等待。需要超时就显式传入该二元组。- 基础 URL 固定拼接为
http://{ip}:{port}/,即客户端只使用明文 HTTP。 - 每个请求都会设置
Content-Type: application/json,并把params序列化进请求体,GET请求也是如此。 - 底层会话配置了对 HTTP 500、502、504 的最多 3 次重试和
0.1的退避系数;状态码重试遵循 urllib3 默认允许的方法,POST不在其中,因此不能依赖它自动重试任务提交。 log_level设置的是名为VermeerClient的共享日志器的级别。它的控制台 handler 固定为INFO,因此目前DEBUG级别的记录不会打印到控制台。
端到端示例
模块自带一个可运行的示例:vermeer-python-client/src/pyvermeer/demo/task_demo.py。下面的版本在其基础上增加了有截止时间的任务轮询,先等待加载成功、再读取图并提交 PageRank 计算;PD 地址和 HugeGraph 密码从环境变量读取。服务端 worker group 也必须与任务空间的分配匹配;单 worker 快速上手可将 worker_group 设为 $,保留命名组时先按 Vermeer 快速上手 将该组绑定到任务空间。
加载任务以 loaded 表示成功,计算任务以 complete 表示成功;error 或 canceled 会中止示例。运行前设置 VERMEER_PD_PEERS,其值是 JSON 数组字符串,例如 export VERMEER_PD_PEERS='["hugegraph-pd:8686"]';其中地址必须能由 Vermeer master 访问,PD 返回的 Store 地址也必须能由 worker 访问。只有 master 配置为 token 鉴权时才设置 VERMEER_TOKEN;不启用鉴权时空字符串可用。
示例的 output.type=local 会把结果写到执行任务的 worker 本地文件系统,文件名以 result/pagerank 为前缀。容器部署时需把 worker 的结果目录挂载出来才能从宿主机读取。poll_timeout 是客户端轮询截止时间;检查期限之间的请求仍受 HTTP 超时和 SDK 重试影响,因此实际结束时间可能越过该值。超时只停止客户端等待,不会取消服务端任务。
不要把真实的 HugeGraph 密码写死在脚本或配置文件中,请像上面这样从环境变量或凭据管理系统读取。
保存并运行文档中的端到端示例
将上方完整的增强示例代码保存为 vermeer_client_example.py,放在 hugegraph-ai/ 仓库根目录。在该目录使用已安装 vermeer extra 的 workspace 环境运行:
输入密码后按回车。将 hugegraph-pd:8686 替换为 Vermeer master 可访问的 PD 地址;若 master 启用了 token 鉴权,还要从本机凭据管理方式设置 VERMEER_TOKEN。上述命令运行的是文档增强示例,不是包内原始 demo。
包内原始 demo
vermeer-python-client/src/pyvermeer/demo/task_demo.py 是另一份精简示例:它把客户端端口写为 8688,把 PD 地址写为 127.0.0.1:8686,并使用 xxx 占位用户名和密码。它不会读取本页增强示例使用的环境变量,也没有任务状态轮询或 PageRank 计算。若运行该文件,需单独调整其中的服务地址和 HugeGraph 凭据;不能用它替代上面的文档示例命令。
API 概览
PyVermeerClient 以属性的方式暴露各个 API 组,目前注册了 graph 和 tasks 两个组。
client.graph
| 方法 | Vermeer 接口 | 返回值 |
|---|---|---|
get_graphs() | GET /graphs | GraphsResponse |
get_graph(graph_name) | GET /graphs/{graph_name} | GraphResponse |
client.tasks
| 方法 | Vermeer 接口 | 返回值 |
|---|---|---|
get_tasks() | GET /tasks | TasksResponse |
get_task(task_id) | GET /task/{task_id} | TaskResponse |
create_task(create_task) | POST /tasks/create | TaskCreateResponse |
pyvermeer/api/master.py 和 pyvermeer/api/worker.py 目前只有许可证头,也没有注册到客户端上。因此尽管 pyvermeer/structure/ 下已经有 MasterResponse 和 WorkersResponse,master 和 worker 信息暂时还无法通过客户端获取。
client.send_request(method, endpoint, params) 是这两个组共用的请求入口。对于还没有封装的 Vermeer 接口,可以直接调用它,返回值是解析后的 JSON 字典。
请求与响应对象
TaskCreateRequest(task_type, graph_name, params) 序列化为 {"task_type": ..., "graph": ..., "params": ...}。注意 graph_name 在报文中的字段名是 graph,与 Vermeer REST API 的请求体一致。
所有响应类型都继承 BaseResponse,提供 errcode、message 属性和 to_dict() 方法。errcode 为 0 表示成功,1 表示错误,-1 表示响应体中没有该字段。
GraphsResponse.graphs和GraphResponse.graph返回VermeerGraph对象,包含name、space_name、status、create_time、update_time、vertex_count、edge_count、workers、worker_group、use_out_edges、use_property、use_out_degree、use_undirected、on_disk和backend_option。TasksResponse.tasks、TaskResponse.task和TaskCreateResponse.task返回TaskInfo对象,SDK 读取id、state、create_user、create_type、create_time、start_time、update_time、graph_name、space_name、params、workers和error_message。- 时间字段由
python-dateutil解析为datetime对象,空字符串会解析为None。
当前服务端以 task_type 返回任务类型,而 SDK 的 TaskInfo.type 按 type 读取,因此该属性目前为空;服务端还返回的 statistics_result 不会被 SDK 的 TaskInfo 保留。轮询状态请使用 TaskInfo.state。这是当前源码的字段契约差异。
任务参数
客户端不会校验 params,键和值都会原样传给 Vermeer,因此可用的参数名由引擎决定,而不是由 SDK 决定。加载参数以及各算法的参数请参考 Vermeer 快速上手。
使用流程与直接调用 REST API 相同:先创建 load 任务把图读入 Vermeer,等待任务完成,再针对已加载的图创建计算任务。
异常
pyvermeer.utils.exception 定义了四种异常,都由底层的 requests 或 JSON 解析失败包装而来:
| 异常 | 触发场景 |
|---|---|
ConnectError | requests.ConnectionError,无法连接 master |
TimeOutError | requests.Timeout,连接或读取超时 |
JsonDecodeError | 响应体不是合法的 JSON |
UnknownError | 请求过程中的其他失败 |
客户端不检查响应的 HTTP 状态码,请通过返回对象的 errcode 和 message 判断是成功还是 Vermeer 端返回了错误。
代码检查
在 HugeGraph-AI 仓库根目录执行格式化和静态检查:
源码位于 vermeer-python-client/src/pyvermeer/。目前有少量 src/tests/structure/test_task_data.py 结构测试,没有覆盖 HTTP API 的集成测试。
参考
7 - HugeGraph-MCP
hugegraph-mcp 通过 Model Context Protocol(MCP)向 AI 客户端提供 HugeGraph 工具,
包括 Schema 检查、结构化图查询、受控写入,以及可选的自然语言查询生成和图数据抽取。
服务使用 STDIO 传输,由 MCP 客户端启动本地进程;它不是 HugeGraph Server,也不提供独立的 HTTP MCP 端口。
普通图查询直接访问 HugeGraph Server。自然语言生成、抽取和向量刷新还需要 HugeGraph-LLM 服务,模型凭据配置在该服务中。
环境要求
- 运行发布的 1.7.1 版本要求 Python >= 3.10(主线 master / 1.8.0+ 要求 Python >= 3.12); 单独运行 HugeGraph-LLM 时,请同时满足该模块的 Python 版本要求。
- uv 和支持 STDIO 的 MCP 客户端。
- 可从 MCP 进程访问的 HugeGraph Server 1.7.0 或更高版本。默认图路径为
DEFAULT/hugegraph,使用 graphspace API。 - 已创建的图及具备相应权限的账号。服务端认证配置见认证与授权。
安装与连接
以下示例固定使用已发布的 hugegraph-mcp==1.7.1,不需要克隆代码仓库。
将地址、图路径和凭据替换为实际部署值。先使用只读模式验证连接,再按需要开放受支持的写入。
支持 mcpServers JSON 配置的客户端可添加:
不同客户端的配置文件位置和结构可能不同,请按客户端说明填写相同的启动命令、参数和环境变量。
如果客户端找不到 uvx,将 command 改为本机 uvx 的绝对路径。修改配置后重启 MCP 进程。
也可在已配置上述环境变量的终端中启动:
进程启动后等待 MCP 客户端通过标准输入发送协议消息,不会打开网页。 stdout 用于 MCP JSON-RPC,不要将额外的 shell 输出写入该通道。
验证连接
通过客户端列出工具,再调用 inspect_graph_tool。以下 JSON 是 MCP tools/call 的参数内容,
不是向 HugeGraph REST API 直接发送的请求。
确认返回 ok=true、data.hugegraph_server_status="available"。
从 Schema 中选择已有的顶点标签,将下例中的 person 替换为该标签:
该工具属于默认的 16 工具集。分页时使用响应中的 next_page 作为下一次调用的 page,
并保留相同的查询条件。结果为空不一定表示连接失败,请同时检查图路径、标签和已有数据。
工具集与版本
工具集选择的是同一个包提供的工具分组,不是软件包版本、HugeGraph Server 版本或 MCP 协议版本。
1.7.1 的配置名称如下:
HUGEGRAPH_MCP_TOOLSET | 工具数量 | 用途 |
|---|---|---|
未设置,或 v2_core | 16 | 默认工具集,包含结构化查询和持久化写入计划工具 |
v1 | 10 | 兼容工具集,保留较早的工具入口 |
其他任何值(包括 v2、core、legacy 或空字符串),在 1.7.1 中均会记录错误日志并回退到包含 10 个工具的 v1 兼容工具集。
两种工具集的 mcp_tool_contract_version 均为 2.0,该字段表示工具契约,不表示包版本。
工具集命名演进
最新源码已将默认工具集更名为 core,兼容工具集更名为 legacy。该规范将在后续版本正式发布;若使用 1.7.1 安装包,请继续遵循上述配置。
v2_core对应新版core,v1对应新版legacy;旧名称作为兼容别名保留,使用时将输出迁移提示。- 检查接口统一返回
core或legacy,依赖data.toolset或meta.toolset的客户端需同步适配。 - 未设置变量时默认启用
core;空值或未知值将直接拦截启动,不再静默回退。 - 工具集在启动时加载,变更配置后需重启客户端;切换兼容工具集不会绕过鉴权与只读约束。
工具能力
工具已注册不代表所有操作都可以执行。当前能力范围如下,实际工具参数以客户端的工具 Schema 为准。
| 功能 | 工具 | 使用范围 |
|---|---|---|
| 检查与设计 | inspect_graph_tool、inspect_schema_tool、design_schema_tool | 查看连接、Schema 和设计指导 |
| 结构化读取 | query_graph_data_tool | 按 ID、ID 列表、分页或条件读取顶点和边 |
| Schema 创建 | apply_schema_tool | 校验和预览;默认工具集支持确认单个属性键、顶点标签或边标签创建 |
| 写入计划 | confirm_write_tool、get_write_status_tool、reconcile_write_tool | 确认、查询及协调持久化计划 |
| 图导入 | import_graph_data_tool | extract 调用 AI;ingest 仅预览,table 当前禁用 |
| 图删除 | delete_graph_data_tool | 精确边删除可确认;顶点删除仅预览 |
| 属性变更 | mutate_graph_properties_tool | 仅预览,确认当前禁用 |
| AI 生成与抽取 | generate_gremlin_tool、extract_graph_data_tool | 生成查询或抽取候选图数据,不自动执行生成的查询 |
| 向量刷新 | refresh_vid_embeddings_tool | 需要 AI、管理模式、允许写入以及显式确认;当前源码的服务侧门禁见下文 |
| 原始 Gremlin | execute_gremlin_read_tool、execute_gremlin_write_tool | 当前均返回 FEATURE_DISABLED;管理模式不能绕过 |
兼容工具集不包含 inspect_schema_tool、query_graph_data_tool、mutate_graph_properties_tool,
以及三个写入计划工具。原始 Gremlin 执行也不会因切换到兼容工具集而开放。
受控写入
需要写入时,将 HUGEGRAPH_MCP_READONLY 设为 false,并使用有相应权限的 HugeGraph 账号。
对于可确认的操作,先执行 dry-run,检查具体目标、变更内容和警告,再使用返回的 plan_id 确认:
用 get_write_status_tool(plan_id) 查询持久化结果。APPLIED 表示全部操作已确认成功;
PARTIAL 或 UNKNOWN 表示部分完成或结果尚不能确定,应先查询和协调状态,不要重新生成计划盲目重试。
已完成的同一计划再次确认会返回记录的结果,不会重复写入。
内置 SQLite 状态存储要求单个可写 MCP 实例,并需要可持久保存的状态目录。
多个客户端各自启动进程时,应先保持只读;多实例写入需要另行设计共享事务存储。
预览返回 confirmable=false 的操作不能通过关闭只读或开启管理模式强制执行。
配置
下表对应已发布的 1.7.1。MCP 图账号与 HugeGraph-LLM 的 API token 是两种不同的凭据。
| 环境变量 | 默认值 | 说明 |
|---|---|---|
HUGEGRAPH_URL | http://127.0.0.1:8080 | MCP 进程访问的 HugeGraph 地址 |
HUGEGRAPH_GRAPH_PATH | DEFAULT/hugegraph | GRAPH_SPACE/GRAPH_NAME |
HUGEGRAPH_GRAPHSPACE | 未设置 | 覆盖 HUGEGRAPH_GRAPH_PATH 中的 graphspace |
HUGEGRAPH_GRAPH | 未设置 | 覆盖 HUGEGRAPH_GRAPH_PATH 中的图名 |
HUGEGRAPH_USER | admin | HugeGraph 用户名 |
HUGEGRAPH_PASSWORD | 空 | HugeGraph 密码 |
HUGEGRAPH_MCP_TOOLSET | v2_core | 该版本支持 v2_core、v1 |
HUGEGRAPH_MCP_READONLY | true | 禁止受控写入 |
HUGEGRAPH_MCP_ALLOW_AI | false | 允许调用 HugeGraph-LLM |
HUGEGRAPH_MCP_ADMIN_MODE | false | 开放符合条件的管理操作 |
HUGEGRAPH_AI_URL | http://127.0.0.1:8001 | HugeGraph-LLM 服务地址 |
HUGEGRAPH_AI_TOKEN | 未设置 | HugeGraph-LLM bearer token |
HUGEGRAPH_AI_GRAPH_URL | 未设置 | 不用于改变 AI 服务目标;当前源码已忽略此项 |
HUGEGRAPH_AI_TIMEOUT_SECONDS | 30 | AI HTTP 请求超时,单位为秒 |
HUGEGRAPH_MCP_STATE_DIR | XDG 状态目录或 ~/.local/state/hugegraph-mcp | 写入计划与回执的持久化目录 |
可选 AI 功能
先按 HugeGraph-LLM 指南 配置并启动模型服务,再在 MCP 客户端的 env 中加入:
这段内容应合并到前面的 env 对象中。生成和抽取可保持只读;向量刷新要求满足以下条件:
- 客户端配置:
HUGEGRAPH_MCP_READONLY=false、HUGEGRAPH_MCP_ADMIN_MODE=true,且调用时需传入confirm=true。 - 服务端配置(HugeGraph-LLM):需设置
ENABLE_LOGIN=true与HUGEGRAPH_LLM_ENABLE_THIN_WRITES=true,配置非默认的强USER_TOKEN(避免使用弱默认值4321), 并通过 MCP 的HUGEGRAPH_AI_TOKEN传递有效认证。若服务端未开启写入门禁,刷新请求将被拒绝并返回FEATURE_DISABLED(“Legacy Thin API writes are disabled”)。
MCP 与 HugeGraph-LLM 必须连接至同一个底层 HugeGraph 实例。能力校验协议仅校验图名与图空间,
而实际刷新完全由 AI 服务依据其自身的 GRAPH_URL 独立执行;修改 MCP 的 HUGEGRAPH_URL 并不会改变 AI 服务的数据目标。
若 MCP 在宿主机运行,而 AI 在容器中运行,二者访问图服务的网络地址可能不同:应在 AI 服务侧配置 GRAPH_URL 为容器可访问的地址
(例如 http://server:8080),并确保 GRAPH_NAME 与 GRAPH_SPACE 与 MCP 目标一致;不要让容器通过 127.0.0.1 访问宿主机上的图服务。
能力校验协议:
新版协议要求调用 GET /vid-embeddings/refresh-capabilities 返回 protocol_version=1,并在刷新前传递预期图名与 graphspace 由服务端进行合法性校验;不支持该协议的服务将被拒绝。该机制用于保障多租户与图空间隔离,未发布该特性的旧版本不强制依赖。
常见问题
- 客户端启动后没有工具:检查
uvx路径、Python 版本和进程 stderr;终端进程等待协议输入是正常行为。 - 找不到结构化查询工具:检查是否选择了兼容工具集。
1.7.1使用v2_core,也可直接不设置工具集变量。 - 返回
FEATURE_DISABLED:先检查能力表、只读、AI 和管理开关;部分操作是后端能力限制,不能仅靠修改配置开放。 - AI 调用失败:检查服务地址、token、容器网络和 AI 日志。MCP 返回的服务不可用错误不一定意味着模型已下线。
- 向量接口返回 400 或 429:检查提供商的单次输入条数及请求频率限制。每批最大条数和并发请求数是不同限制; 应在 HugeGraph-LLM 的向量适配与索引构建路径中处理,而不是更换 MCP 工具集。
工具响应中的 ok=false 表示失败,请同时检查 error.type、error.retryable 和 warnings,
不要只根据 MCP 连接成功或 HTTP 状态判断业务操作成功。
后续阅读
仓库 main 的文档随源码更新。使用固定发行包时,应先核对对应版本;本文安装示例固定为 1.7.1。
8 - HugeGraph-LLM SDK 快速上手
hugegraph-llm-sdk 是面向独立 Python 项目的轻量级 SDK,提供编程式 Schema 设计、非结构化文本属性图抽取、遵循 HugeGraph 规则的结构校验,以及多轮模型审阅与有限修复能力。
与完整的 hugegraph-llm 应用不同,该 SDK 采用无界面(Headless)设计,无需依赖 HugeGraph Server、Gradio Web 界面、FastAPI 服务或向量数据库。基础运行环境仅依赖 pydantic>=2.14,<3。
Apache License 2.0 · Ask DeepWiki
环境要求与安装
- Python 版本:
>=3.12(在 Python 3.12、3.13 与 3.14 上均通过验证与支持)。 - 发行包名:
hugegraph-llm-sdk - 导入模块名:
hugegraph_llm_sdk
从源码或本地 wheel 安装
当前 SDK 随 hugegraph-ai 源码提供,尚未发布到公共软件包索引。请从本地源码目录或自行构建的 wheel 安装。
模型厂商适配器(Extras)
请从同一源码目录安装所需的适配器 extra:
快速上手:最小示例
以下展示使用自定义模型函数完成“设计 Schema → 校验 Schema → 抽取并审阅属性图”的完整流程:
核心接口说明
| 接口名称 | 签名 | 说明 |
|---|---|---|
design_schema | (texts, *, model, questions=(), example_schema=None, prompt=None) -> SchemaDraft | 根据文本与问题生成候选图结构草案(SchemaDraft(schema, issues))。 |
adesign_schema | (texts, *, model, questions=(), example_schema=None, prompt=None) -> SchemaDraft | 异步版本的 Schema 设计接口。 |
validate_schema | (schema) -> list[Issue] | 校验 Schema 结构是否符合 HugeGraph 属性图约束,不修改输入对象。 |
extract_graph | (texts, *, schema, model=None, model_factory=None, review=True, options=None, prompts=None, validators=()) -> ExtractionResult | 执行分块图抽取、结构校验以及多轮审阅修复循环。 |
aextract_graph | (texts, *, schema, model=None, model_factory=None, review=True, options=None, prompts=None, validators=()) -> ExtractionResult | 异步版本的图抽取接口。 |
Schema 校验规则
validate_schema检查顶点标签、边标签、主键策略(DEFAULT、AUTOMATIC、PRIMARY_KEY、CUSTOMIZE_STRING、CUSTOMIZE_NUMBER、CUSTOMIZE_UUID)以及属性声明。- 省略
propertykeys时,不对全局属性引用作硬性约束;省略标签的properties时,不限制其属性集合。 - 显式声明
properties: []表示该标签严禁携带任何属性。 - 边标签的
sort_keys不能同时属于nullable_keys;当frequency为SINGLE或DEFAULT时禁止排序键,为MULTIPLE时必须声明非空排序键。
模型适配器
SDK 在 hugegraph_llm_sdk.providers 模块中提供了常见大模型的适配器:
FunctionModel:包装任意同步函数generate(prompt: str) -> str或异步函数agenerate(prompt: str) -> str。OpenAIClient:适用于 OpenAI 及兼容接口的适配器(支持close()与await aclose()显式资源释放)。OllamaClient:适用于本地私有化 Ollama 服务的适配器。LiteLLMClient:基于 LiteLLM 路由连接池的适配器。ThreadedModel:包装同步模型,在异步事件循环中通过独立工作线程执行模型调用,避免阻塞主循环。
审阅与有限修复机制
默认情况下,属性图抽取会执行迭代审阅与有限自动修复流程:
审阅参数可通过 ExtractionOptions 进行配置:
分块与整体状态
- 分块状态(Chunk status):
final:子图成功通过结构校验与模型审阅。只有final状态的分块会被合并到全局result.graph中。candidate:通过了结构校验,但审阅配额耗尽或未能完成最终核对。blocked:未能通过 Schema 校验修复,或被模型审阅判定存在明显事实错误予以拦截。failed:在准备、调用或解析阶段发生异常。
- 整体状态(Aggregate status):
succeeded:所有文本分块均达成final状态。partial:至少一个分块达成final,但同时存在未完成(candidate、blocked 或 failed)的分块。failed:没有任何分块达成final状态。
并发与异步批量抽取
当配置 max_workers > 1 时,必须传入无参 model_factory 可调用对象,而不是单一的 model 实例,以保证各并发线程状态隔离:
SDK 会自动管理由 model_factory 创建的实例生命周期,每批 Worker 执行完毕后自动释放对应连接资源。
与 HugeGraph-LLM 的关系
hugegraph-llm-sdk 与 hugegraph-llm 同属 hugegraph-ai 代码仓库:
hugegraph-llm-sdk:适合嵌入数据处理流水线、LLM Agent 工具链或外部 Python 应用中,专门负责 Schema 建模与属性图提取。hugegraph-llm:面向终端用户的完整生产服务,提供 Web 界面、RESTful API(POST /graph/extract、POST /rag)、向量索引持久化与图数据直接入库能力。