这是本节的多页打印视图。 .
HugeGraph (OLTP)
- 1: HugeGraph Server 快速上手
- 2: HugeGraph-PD 快速上手
- 3: HugeGraph-Store 快速上手
- 4: 使用 Helm 部署 HugeGraph
- 5: HugeGraph Kubernetes 运维
本目录包含 HugeGraph Server 单机快速上手,以及分布式部署所需的 PD 和 Store 入门文档。
DeepWiki 项目概览;涉及安装、配置和运行行为时,请以对应版本的 HugeGraph 文档及代码为准。
首次使用可从 Server 单机快速上手 开始。该页将 ASF 已发布的 1.7.0 下载包与 master 源码构建分开说明。若使用 HStore 分布式存储,还需配置 PD 和 Store。
GitHub 访问: https://github.com/apache/hugegraph
1 - HugeGraph Server 快速上手
1 HugeGraph Server 概述
apache/hugegraph 是 HugeGraph 图数据库的主仓库,包含 hugegraph-server、hugegraph-pd、hugegraph-store 等一级模块。本页介绍其中的 hugegraph-server 模块及其运行服务。
hugegraph-server 模块包含 hugegraph-core、hugegraph-api、hugegraph-dist 和存储适配等子模块。Core 实现属性图模型、事务与 TinkerPop 接口,API 提供 HTTP 服务并将客户端请求交给 Core 处理。图数据由 RocksDB(单机默认)、HStore(分布式)或 HBase 后端保存。
版本说明:本文区分已发布版本与开发主线。下载示例使用 ASF 发布的 HugeGraph 1.7.0 安装包;源码构建、配置默认值和启动行为以 apache/hugegraph 的 master 分支为准。主线源码构建出的包不是 ASF 发布包,即使包内版本号与发布版本一致也不代表属于官方发布包。本文介绍 RocksDB、HStore 和 HBase;其他旧后端请参考 HugeGraph 1.5.x 文档。
名称说明:
HugeGraph表示整个项目或主仓库,hugegraph-server表示仓库中的 Server 模块,HugeGraphServer是服务进程的 Java 类名。下文的 Server 服务指运行中的图数据库服务。
flowchart TD
    A{选择安装来源}
    A -->|已发布版本| R["HugeGraph 1.7.0 tar 包"]
    R --> V[SHA-512 校验]
    V --> X[解压并使用随包配置]
    A -->|开发主线| M["master 源码"]
    M --> B["mvn package -DskipTests"]
    B --> C[确认 conf/graphs 中的 RocksDB 配置]
    C --> I[bin/init-store.sh]
    I --> S["bin/start-hugegraph.sh -p true"]
S --> Q["请求 /versions 和图顶点接口"]主仓库模块概览使用短名称;server、core、api、dist、pd 和 store 对应带 hugegraph- 前缀的模块。上方保留功能说明,dist 负责发行打包。
---
markmap:
  spacingHorizontal: 40
---
# HugeGraph
## server
- core
- api
- dist
## pd
## store
2 依赖
2.1 安装 Java 17 (JDK 17)
从 HugeGraph 1.8.0 开始使用 Java 17;1.7.0 是最后一个支持 Java 11 的版本。
所有模块的源码构建要求 JDK 17 和 Maven 3.6.3 或更高版本,Server、PD 和 Store 的运行环境统一使用 JDK 17。
Server 安全检查(-s true)要求 Java 17 到 23 以及可读的 conf/java-security.properties;在 Java 24 或更高版本上,需以 -s false 启动 Server(JDK 24 通过 JEP 486 移除了 Security Manager)。
在继续阅读前,请先执行 java -version 命令确认 JDK 版本。
TinkerPop 3.8.1 兼容性与核心变更
HugeGraph 1.8.0 升级至 TinkerPop 3.8.1 与 Groovy 4.0.25。请使用 Server 随包提供的 Gremlin 配置文件。
- 序列化器包路径变更:Driver 序列化器类从
org.apache.tinkerpop.gremlin.driver.ser移至org.apache.tinkerpop.gremlin.util.ser,需保留配置中的 HugeGraph registries。 - Graph.Features 调整:
supportsUniformListValues()现返回false;按 Schema 定义的valueList()/LIST属性仍正常支持,无需重写既有列表数据。 - 遍历倍数语义:遍历中途扫描保留上游输入数量(如 3 个顶点执行
g.V().V().count()返回9L)。 - 日期时间类型:
DATE属性支持写入及索引等值/范围查询中的OffsetDateTime(按 instant 毫秒归一化)。 - 过滤与优化:
P.typeOf()作为本地过滤执行;Count 过滤仅在谓词分支可证明截断安全时应用优化。
完整客户端配置与验证细节见 Server 运行时文档。
3 部署
有四种方式可以部署 Server 服务:
- Docker 容器 用于测试或开发,快速启动 Server 服务。
- ASF 发布包 下载已发布的 tar 包,校验后安装。
- master 源码 构建开发主线,产物不等同于 ASF 发布包。
- 旧版一键部署工具(已过时) 仅供了解旧版部署方式。
3.1 使用 Docker 容器 (便于测试)
可参考 Docker 部署方式。
可以使用 docker run -itd --name=server -p 8080:8080 -e PASSWORD=xxx hugegraph/hugegraph:1.7.0 快速启动一个使用 RocksDB 后端的 Server 实例。
可选项:
- 可以使用
docker exec -it server bash进入容器执行运维或调试操作。 - 可以使用
docker run -itd --name=server -p 8080:8080 -e PRELOAD="true" hugegraph/hugegraph:1.7.0在启动时预加载一个内置样例图。可通过RESTful API进行验证,具体步骤可参考 5.1.4。 - 可以使用
-e PASSWORD=xxx开启鉴权模式并设置 admin 密码,具体步骤可参考 Config Authentication。
如果使用 Docker Desktop,则可以按如下方式设置相关选项:
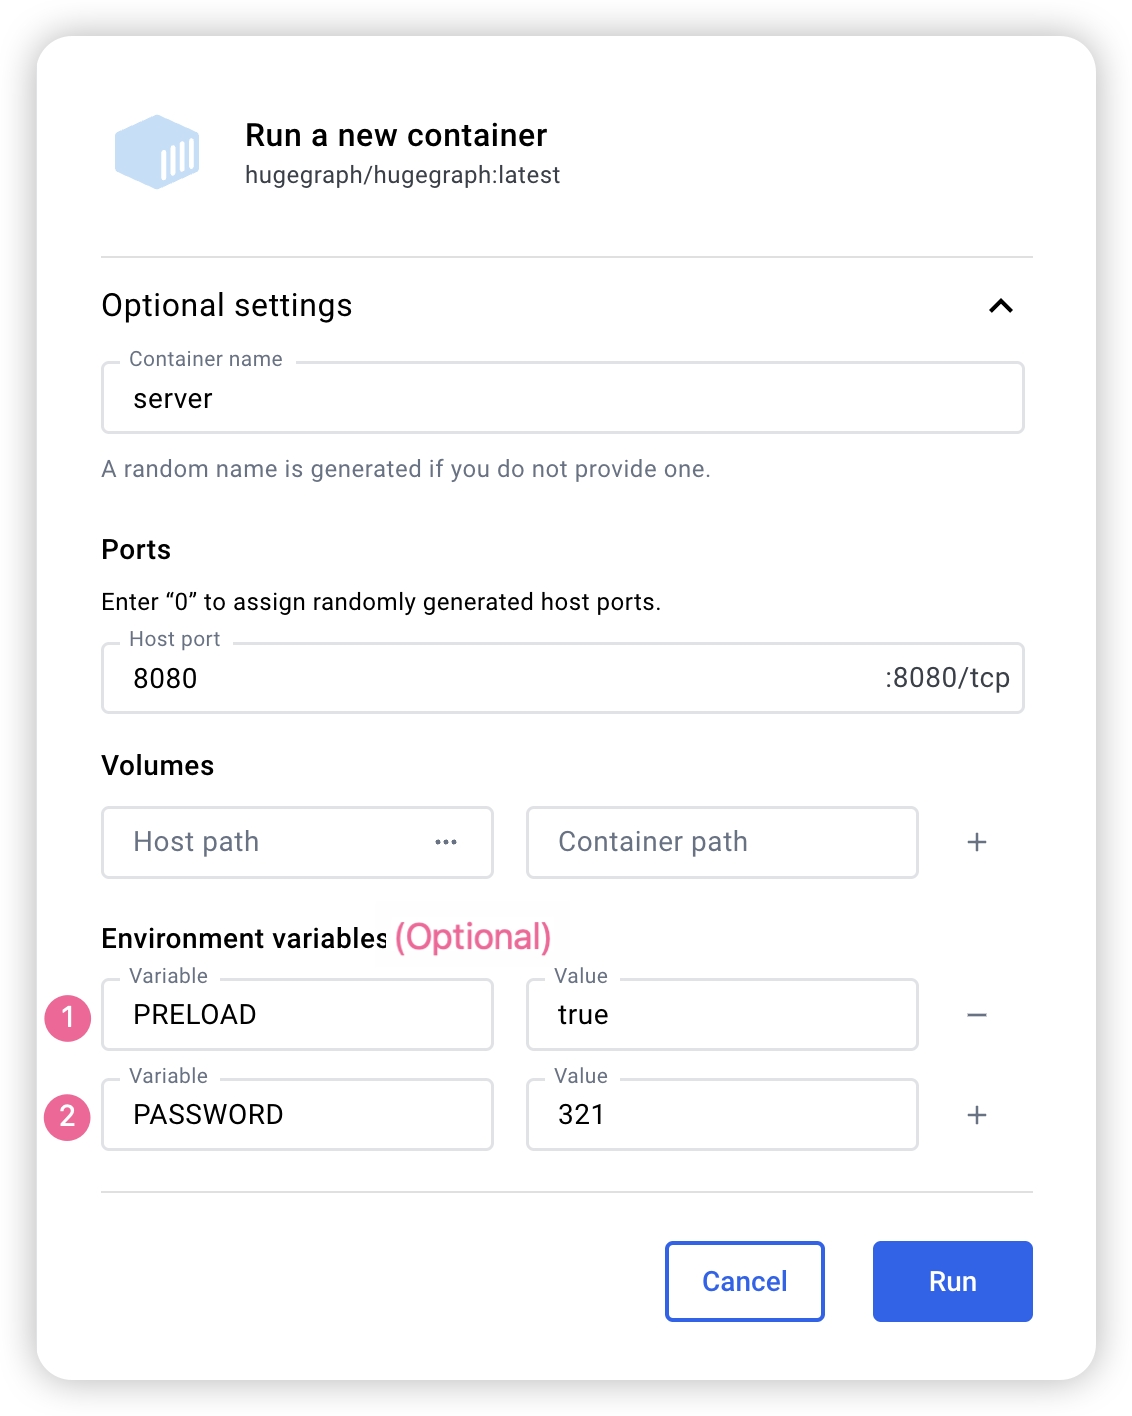
Docker Compose 文件使用桥接网络(hg-net),适用于 Linux 和 Mac(Docker Desktop)。如需运行 3 节点分布式集群,请为 Docker Desktop 分配至少 12 GB 内存(设置 → 资源 → 内存)。Linux 上 Docker 直接使用宿主机内存。
如果希望通过一个配置文件统一管理 HugeGraph 的多个服务实例,则可以使用 docker compose。 docker/ 目录下提供了四个 compose 文件:
| 拓扑 | compose 文件 | 服务 |
|---|---|---|
| 单机(推荐从这里开始) | docker-compose.yml | 1 个 RocksDB Server + 1 个 Hubble |
| 最小 HStore(当前主线) | docker-compose-hstore.yml | 1 PD + 1 Store + 1 Server + 1 Hubble;需使用主线构建的本地镜像 |
| HA 参考(当前主线) | docker-compose-3pd-3store-3server.yml | 3 PD + 3 Store + 3 Server + 1 Hubble;需使用主线构建的本地镜像 |
| 最小 HStore 拓扑的源码构建覆盖文件 | docker-compose.dev.yml | (需与 docker-compose-hstore.yml 一起使用) |
单机拓扑将 Server 暴露在 8080 端口,Hubble 暴露在 127.0.0.1:8088。HUGEGRAPH_VERSION 决定 Server、PD 和 Store 的镜像 tag,Hubble 由 HUBBLE_IMAGE 单独选择。
单机 docker-compose.yml 示例使用 HugeGraph 1.7.0 版本镜像 hugegraph/hugegraph:1.7.0;该文件引用的 docker/conf/hubble/standalone.properties 已随源码提供。Compose 文件从 HUGEGRAPH_ADMIN_PASSWORD 读取管理员密码,从 HUGEGRAPH_AUTH_TOKEN_SECRET 读取 JWT 密钥,通常放在 docker/.env 文件中。HUGEGRAPH_ADMIN_PASSWORD 非空即开启鉴权,Hubble 会自动识别该模式。若直接使用 docker run,则改为传入 -e PASSWORD=xxx。HStore Compose 文件属于当前主线,不能与 1.7.0 的 PD/Store/Server 发布镜像混用,见下文。
JWT 密钥的版本差异:当前主线构建的 Server 镜像会把 HUGEGRAPH_AUTH_TOKEN_SECRET 映射到 HG_SERVER_AUTH_TOKEN_SECRET,并写入 Server 启动配置;跨重建时应在 .env 中保留同一密钥。1.7.0 镜像的 Docker 入口脚本只处理 PASSWORD 等旧变量,不会读取 HG_SERVER_AUTH_TOKEN_SECRET。如需在 1.7.0 中固定 JWT 密钥,须将 auth.token_secret 持久写入该版本的 conf/graphs/hugegraph.properties;若保留默认随机密钥,不应假定已有 JWT 在 Server 重启后仍有效。
完整的部署指南请参阅 docker/README.md。
使用 PD 的 Server 服务标识
对于使用 PD 的 Server,Helm chart 提供 server.serviceId 和 server.graphSpace 配置项。
二者默认为 DEFAULT,此时保留 conf/rest-server.properties 中已有的 server.service_id 和 server.graphspace。
非默认值会向 Server 容器注入 HG_SERVER_SERVICE_ID 或 HG_SERVER_GRAPHSPACE。
注意:这些服务身份相关的 Chart 配置项(server.serviceId、server.graphSpace 和 server.testGraphAlias)适用于开发中的 1.8.0+ 版本镜像与 Chart;
目前尚无已发布的 Chart 或镜像支持这些选项。不要将本示例与未支持该特性的旧版本搭配使用。
通过 HG_SERVER_SERVICE_ID、SERVICE_ID 或 server.serviceId 传入的非空服务 ID 仅支持可打印 ASCII,包含空格和反斜杠;
部署校验会拒绝非 ASCII 和控制字符。此限制仅针对这些配置入口,不改变 Core Service 名称协议和已有的手工 properties 配置。
Helm 会将 server.serviceId 中的美元符号(包括 $(POD_IP))按字面量保留,不展开 Kubernetes 环境变量引用。
重读服务元数据或清理图空间时,会保留完整的服务 ID,包括其中的 / 和 -。
使用上述 chart values 设置身份;Server 的 extraEnv 会保留对应的新旧身份变量名,禁止重复覆盖。
HG_SERVER_GRAPHSPACE、生效的旧变量 GRAPH_SPACE 和 server.graphSpace 遵循同一规则:
接受 DEFAULT,或以小写字母开头、最多 48 位的小写字母、数字和下划线组成的已有空间名称:
部署分配到 team_a 的 Server 前,先通过现有 DEFAULT 空间的 Server,用具有创建图空间权限的账号创建该空间。
chart 和这些环境变量不会自动创建图空间;同一个 Server Deployment 的所有副本使用相同服务标识。
用 helm test 检查该空间中的图前,先创建目标图,再将 --set-string server.testGraphAlias=team_a-demo 设置为它实际的 Gremlin 绑定。
创建图空间不会自动创建 hugegraph 图。
容器部署中的 HG_SERVER_SERVICE_ID 和 HG_SERVER_GRAPHSPACE 写入上述两个配置项。
旧名称 SERVICE_ID 和 GRAPH_SPACE 仍可使用;非空的新变量优先于对应旧变量。
同一配置项的新旧变量均未设置或为空时,保留已有值。Compose 不会自动传入宿主机上的这些变量,
需要在 Compose override 的 Server environment: 中显式添加。详见 Helm chart 配置说明。
这些设置选择 Server 在 PD 中的服务元数据,不会搬迁已有图,也不会修改未指定图空间的 REST 路径所用的 server.path_graphspace。
请求使用 /graphspaces/team_a/... 路径,并在 Hubble 中选择匹配的图空间和服务;开启鉴权时,显式指定路径仍须获得授权。
server.testGraphAlias 默认为 DEFAULT-hugegraph。hook 会逐个 Server Pod 检查这一已有本地图绑定,不会从 server.graphSpace 自动派生别名。
别名的大小写须与实际绑定一致:本地 Demo.properties 可以绑定为 DEFAULT-Demo;通过 REST 创建的图使用小写名称。
本地图绑定可以独立于 Server 在 PD 中分配的图空间存在,因此默认 hook 成功不能证明 team_a 中的图可查询。
出现 Could not rebind 时,先确认目标图存在且别名正确;重启 Pod 不能创建缺失的图或纠正别名。
配置渲染和入口脚本检查不能单独证明 Linux 上的非默认服务发现、鉴权或跨图空间隔离已通过验收。
HugeGraph 的 Docker 镜像主要用于便捷地快速启动 HugeGraph,并不是 ASF 官方发布物料包。你可以从 ASF Release Distribution Policy 中了解更多细节。
推荐使用
release tag(如1.7.0/1.x.0) 以获取稳定版。使用latesttag 可以使用开发中的最新功能。
3.2 下载已发布的 tar 包
以下示例针对 HugeGraph 1.7.0。使用其他版本时,请先在 ASF 下载目录 确认该版本及对应文件名;不要把 master 源码构建包当作已发布的二进制包。
SHA-512 校验通过后再解压。也可按 Apache 发布流程验证 PGP 签名:
只应信任通过 Apache 项目渠道核实的发布者密钥;签名验证可与 SHA-512 校验一起使用。
3.3 从 master 源码构建
下面的命令构建的是开发主线,不是 1.7.0 发布包。
源码编译前请确保本机有安装 wget/curl 命令
下载 HugeGraph 源代码
编译打包生成 tar 包
构建成功时日志中会出现:
执行成功后,根目录 target/ 下会生成主线聚合包(当前仓库版本属性为 1.8.0):
该文件名中的版本号来自源码的 revision 属性;它不会把主线构建变成 ASF 发布物料。构建过程还会在仓库根目录生成 apache-hugegraph-1.8.0/ 聚合目录,其中的 Server 子目录名由 Server 模块的 final.name 决定,例如当前为 apache-hugegraph-server-1.8.0。若只保留了 tar 包,则先执行 tar zxf target/apache-hugegraph-1.8.0.tar.gz 再进入该目录。
默认构建会打包 rocksdb、hbase 和 hstore 三个后端模块,并把它们记录在 hugegraph-dist jar 内的 backend.properties 资源的 backends 配置项中。若只需要包含 RocksDB 的精简发布包,可加上 -Drocksdb-only:
3.4 使用 tools 工具部署 (Outdated)
已过时 仅指此一键部署入口。
HugeGraph-Tools 提供一键部署命令,可以下载、解压、配置并启动 Server 服务和 HugeGraph-Hubble。HugeGraph-Toolchain 发布包中已包含这些工具。
注:
${version}为版本号,最新版本号可参考 Download 页面,或直接从 Download 页面点击链接下载
HugeGraph-Tools 的总入口脚本是 bin/hugegraph,用户可以使用 help 子命令查看其用法,这里只介绍一键部署的命令。
{hugegraph-version} 表示要部署的 Server 服务及 HugeGraphStudio 版本,可在 conf/version-mapping.yaml 中查看版本信息。{install-path} 指定安装目录,{download-path-prefix} 可选,用于指定 tar 包下载地址。例如部署 0.6 版本时,可以执行 bin/hugegraph deploy -v 0.6 -p services。
4 配置
Server 的 tar 包随包提供 conf/rest-server.properties、conf/gremlin-server.yaml 和 conf/graphs/hugegraph.properties;源码构建包从 hugegraph-server/hugegraph-dist/src/assembly/static/conf/ 装配这些文件。解压后在 Server 安装目录内编辑配置,无需另行生成。发行包版本之间可能有默认值差异,下面涉及的默认值和启动行为按 master 主线说明。
单机 RocksDB 快速上手只需确认 conf/graphs/hugegraph.properties 使用 backend=rocksdb、serializer=binary。正常 Server 初始化会扫描 conf/graphs/ 并加载本地图配置,无需额外设置 graph.load_from_local_config=true。该选项默认 false,控制构造阶段的提前加载。图配置变化通过重启 Server 应用,不使用热重载进行维护。
5 启动
5.1 使用启动脚本启动
启动流程分为首次启动和非首次启动两种情况。首次启动前需要先初始化后端数据库,然后再启动服务。
如果服务曾被手动停止,或因其他原因需要再次启动,由于后端数据库已持久化存在,通常可以直接启动服务。
HugeGraphServer 启动时会连接后端存储并检查其版本信息。如果后端尚未初始化,或者已初始化但版本不匹配(例如存在旧版本数据),HugeGraphServer 会启动失败并给出错误信息。
如果需要外部访问 HugeGraphServer,请修改 rest-server.properties 的 restserver.url 配置项(默认为 http://127.0.0.1:8080),修改成机器名或 IP 地址。
由于各种后端所需的配置(hugegraph.properties)及启动步骤略有不同,下面逐一对各后端的配置及启动做介绍。
生产环境启动 Server 前必须完成鉴权配置
按照 Server 鉴权配置 启用认证与授权并设置非默认强管理员密码;同时启用 IP 白名单,为业务用户配置最小权限。
5.1.1 分布式存储 (HStore)
要使用分布式存储引擎,需要先部署 HugeGraph-PD 和 HugeGraph-Store,详见 HugeGraph-PD 快速入门 和 HugeGraph-Store 快速入门。
umask 077 保护新建的 .env,但 set-hubble-pd-password.sh 会将生成的 .local.properties 权限设为 0644,本机其他用户也能读取其中的 PD 密钥。下面示例仅适用于本机用户均可信的环境;共享主机必须先按 Hubble 运行用户设置文件属主与读取权限,确保 Hubble 可读且其他非授权用户不可读。不提交文件不能替代文件权限保护。
分布式存储是 HugeGraph 1.5.0 之后推出的新特性,它基于 HugeGraph-PD 和 HugeGraph-Store 组件实现了分布式的数据存储和计算。
确保 PD 和 Store 服务均已启动后
- 修改 Server 服务的
hugegraph.properties配置:
发布包中自带该后端的模板文件 conf/graphs/hstore.properties.template,可将其复制覆盖 conf/graphs/hugegraph.properties 后修改 pd.peers。
此例的 rest-server.properties 使用 cluster=hg,图配置使用 pd.cluster=hg,与下方主线 Compose 拓扑选用同一集群名。它们位于不同配置文件,分别供 Server 进程和图配置使用;按部署实际选择集群名,不要把两个键当成同一个配置项。类似地,两个文件中的 pd.peers 也属于各自的配置范围;本例都填写同一组 PD RPC 地址。
任务调度器由后端决定,无需配置 task.scheduler_type:hstore 使用分布式调度器,其余后端使用本地调度器。为兼容旧配置,该键仍可存在,但会被忽略并打印一条警告日志。
- 修改 Server 服务的
rest-server.properties配置:
以下地址示例适用于在同一台主机运行多个 Server 进程;127.0.0.1 仅用于本机场景。跨主机部署时,将 restserver.url、gremlinserver.url、pd.peers、Gremlin host 和 rpc.server_host 替换为各节点可路由的 IP 或 DNS;rpc.server_host 公布的地址和端口必须能被其他节点互达。
如果配置多个 Server 节点,需要为每个节点修改 rest-server.properties 配置文件,例如:
节点 1(主节点):
节点 2(工作节点):
同时,还需要修改每个节点的 gremlin-server.yaml 中的端口配置:
节点 1:
节点 2:
启动 Server:
使用分布式存储引擎的启动顺序为:
- 启动 HugeGraph-PD
- 启动 HugeGraph-Store
- 启动 Server 服务
HStore 的元数据和存储由 PD、Store 管理,init-store 会跳过该后端。开启鉴权时,执行 init-store 仍会创建内置的 admin 账号。如果该账号已由存储侧持有,可在 rest-server.properties 中设置 init_store.enabled=false 以整体跳过这一步,Docker 的 HStore 拓扑即采用这种方式。
验证服务是否正常启动:
停止服务的顺序应该与启动顺序相反:
- 停止 Server 服务
- 停止 HugeGraph-Store
- 停止 HugeGraph-PD
Docker HStore 高可用集群(当前主线)
docker-compose-3pd-3store-3server.yml 使用当前主线的 HG_PD_*、HG_STORE_* 和 HG_SERVER_* 环境变量;1.7.0 发布镜像不支持这套配置。先从同一份主线源码构建 PD、Store 和 Server 镜像,并使用相同的本地 local 标签:
先在 docker/ 目录创建认证环境并生成 HStore Hubble 配置。用自己设置的管理员密码替换示例文本;因 .env 使用单引号包裹,密码不能含单引号或换行。脚本生成 JWT 与 PD 随机密钥,并将 PD 密钥写入两个 HStore Compose 会挂载的未跟踪 .local.properties 文件:
然后在 docker/ 目录启动 HA 拓扑。HUGEGRAPH_VERSION=local 令 PD、Store 和 Server 使用刚构建的本地镜像;该 Compose 文件的 pull_policy: missing 会优先使用已存在的本地标签。Hubble 仍由 HUBBLE_IMAGE 独立选择:
HG_PD_AUTH_SECRET_KEY 应只为新数据目录生成一次;重启或复用已有数据目录时,继续使用原值。不要提交 .env 或生成的 conf/hubble/*.local.properties。服务通过 hg-net 桥接网络上的容器主机名通信。Server 拓扑要求共享 JWT 密钥;不要只设置管理员密码而遗漏 HUGEGRAPH_AUTH_TOKEN_SECRET。完整的环境变量说明见 Docker 集群指南 和仓库 docker/README.md。
验证集群:
当前主线的 PD /v1/stores REST 接口需要 HTTP Basic 认证;此处用生成后已加载的 HG_PD_AUTH_SECRET_KEY 作为 hg 用户密码。
运行时日志可通过 docker logs <container-name>(如 docker logs hg-pd0)直接查看,无需进入容器。
完整的环境变量参考、端口表和故障排查指南请参阅 docker/README.md。
5.1.2 RocksDB / ToplingDB
从 master 构建的单机最小流程如下。此例启用内置样例数据,以便后续请求能验证图数据读写路径。
- 检查 Java 环境,确认满足主线构建要求。
- 构建 master 源码;下方命令使用该构建包中的 Server 子目录。
- 确认 RocksDB 配置,再进入构建产物中的 Server 子目录。
- 初始化存储,然后启动服务并加载样例图,命令见下方。
- 请求
/versions和样例图顶点接口,检查实际返回内容。
RocksDB 是一个嵌入式的数据库,不需要手动安装部署,要求 GCC 版本 >= 4.3.0(GLIBCXX_3.4.10),如不满足,需要提前升级 GCC
主线包内的 conf/graphs/hugegraph.properties 默认已设置 backend=rocksdb 和 serializer=binary。使用默认数据目录时无需修改;若改过后端或数据路径,先确认配置,再初始化存储。
初始化数据库(首次启动,或在 conf/graphs/ 下添加了新图配置后):
启动 Server 并加载内置样例图:
启动脚本会按 rest-server.properties 中的 restserver.url 轮询 /graphs,超时或进程失败时以非零状态退出。随后先检查服务版本,再读取样例顶点:
第一条请求应返回包含 versions 的 JSON;第二条应返回包含 vertices 的 JSON,且样例数据中可见 marko、lop 等顶点。仅检查进程存在或 HTTP 状态码,不足以证明图后端和业务请求正常。
ToplingDB (Beta): 作为 RocksDB 的高性能替代方案,配置方式请参考: ToplingDB 快速上手
5.1.3 HBase
用户需自行安装 HBase,要求版本 2.0 以上,下载地址
5.1.4 启动 server 的时候创建示例图
在启动脚本时携带 -p true 参数,表示开启 preload,即创建示例图。
并且使用 RESTful API 请求 HugeGraphServer 得到如下结果:
代表创建示例图成功。
5.1.5 启动脚本的参数
bin/start-hugegraph.sh 支持以下参数。每个参数都需要带值,即写作 -d false,不能只写 -d。
| 参数 | 取值 | 默认值 | 作用 |
|---|---|---|---|
-d | true、false | true | 守护进程模式。-d false 时脚本留在前台,并把 SIGTERM/SIGINT 转发给服务进程 |
-g | g1、G1、zgc、ZGC | JVM 默认值 | 选择垃圾回收器(g1/G1 设置 -XX:+UseG1GC;zgc/ZGC 设置 -XX:+UseZGC)。不填则使用 JVM 默认收集器配置 |
-m | true、false | false | 安装基于 crontab 的监控任务(bin/start-monitor.sh),仅用于虚拟机和物理机部署 |
-p | true、false | false | 预加载示例图,见 5.1.4 |
-s | true、false | true | 开启安全检查(HugeSecurityManager),要求 Java 17 到 23 以及 conf/java-security.properties 可读。在 Java 24+ 上需传 -s false |
-j | JVM 参数 | 空 | 追加到服务命令行的额外 JVM 参数 |
-t | 秒 | 30 | 判定启动失败前等待服务响应的时长 |
-y | true、false | false | 开启 OpenTelemetry agent 上报链路追踪 |
bin/stop-hugegraph.sh 支持 -m true|false(默认 true),用于控制停止服务时是否同时移除 crontab 监控任务。
bin/hugegraph-server.sh 会把 -XX:+HeapDumpOnOutOfMemoryError、-XX:HeapDumpPath 和 -XX:ErrorFile 放在 JAVA_TOOL_OPTIONS 的最前面。因此无论是否设置了
JAVA_OPTIONS(下文所述的例外情况除外),内存溢出时的堆转储(heapdump_<主机名>_<启动时间>/java_pid<pid>.hprof)和 JVM 崩溃日志(hs_err_pid<pid>_<主机名>_<启动时间>.log)都会写入 logs/,其中 <启动时间>
为本地时间,格式是 YYYYMMDD-HHMMSS。每次启动都有自己的 heapdump_* 目录,因此服务及其启动的 JVM(例如 computer 任务)会分别写入各自的转储(HotSpot 按 JVM 的 PID 命名转储文件和崩溃日志,因此同一次启动中复用了先前 PID 的 JVM
无法写入它的转储,它的崩溃日志也会覆盖先前那个 JVM 的)。主机名可避免共用同一日志目录的多个服务选到相同的名字;如果同一主机在同一秒内已经用过该名字,会再加上计数(<启动时间>-1、-2……)。如果无法创建该目录(例如磁盘已满),服务仍会启动,堆转储改为尽力写入 logs/
本身;磁盘已满时可能也没有空间写入转储。堆转储可能和堆一样大。启动脚本从不删除转储或 heapdump_* 目录:每次启动到 Java 阶段都会留下一个目录,除非发生内存溢出否则为空;启动脚本保留它,是因为 computer 任务的 JVM 可能在服务退出后仍在使用它。在该次启动的 HugeGraph JVM
都已退出后,可以移走或删除旧目录,但不要动正在运行的服务最新的那个目录;没有它,下一次转储会被写成一个同名文件。JVM 会在这些默认值之后读取你自己的 JAVA_TOOL_OPTIONS、JDK_JAVA_OPTIONS(包括 @argfile)、命令行(JAVA_OPTIONS;未设置或为空时为
-j)和 _JAVA_OPTIONS,因此在其中任意一处为上述参数指定的值都会覆盖默认值。只有环境变量会传给服务启动的 JVM:要对所有 JVM 关闭堆转储,请设置 JAVA_TOOL_OPTIONS=-XX:-HeapDumpOnOutOfMemoryError;通过 -j 或
JAVA_OPTIONS 关闭只对服务自身的 JVM 生效。无论哪种方式,每次启动到 Java 阶段仍会创建空的 heapdump_* 目录,除非创建失败而改为写入 logs/。如果日志路径中包含双引号或 %,启动脚本会给出警告,堆转储直接写入
logs/,不使用每次启动的目录,也不设置崩溃日志的默认值;通过 JAVA_TOOL_OPTIONS 关闭堆转储的方式仍然有效。同时包含两种引号的路径则完全不设置堆转储默认值。由于设置了这些默认值,JVM 启动时会在 stderr 输出 Picked up JAVA_TOOL_OPTIONS: ...。
版本范围:以上行为适用于当前开发分支/master 分支。1.7.0 只在未设置
JAVA_OPTIONS时添加堆转储参数,堆转储直接写入logs/java_pid<pid>.hprof,JVM 崩溃日志写入安装目录。
5.2 使用 Docker
在 3.1 使用 Docker 容器 中,我们已经介绍了如何使用 docker 部署 Server 服务。还可以通过切换后端存储或设置参数,在 Server 启动时加载样例图。
5.2.1 启动 server 的时候创建示例图
在 Docker 启动时设置环境变量 PRELOAD=true,即可在启动脚本执行过程中加载样例数据。
使用
docker run使用
docker run -itd --name=server -p 8080:8080 -e PRELOAD=true hugegraph/hugegraph:1.7.0使用
docker-compose创建
docker-compose.yml,具体文件如下,在环境变量中设置 PRELOAD=true。其中,example.groovy是一个预定义的脚本,用于预加载样例数据。如果有需要,可以通过挂载新的example.groovy脚本改变预加载的数据。使用命令
docker compose up -d启动容器
使用 RESTful API 请求 HugeGraphServer 得到如下结果:
代表创建示例图成功。
6 访问 Server
6.1 服务启动状态校验
jps 查看服务进程
curl 请求 RESTful API
返回包含 versions 的 JSON(HTTP 2xx)可确认 REST API 已响应。jps 中出现 HugeGraphServer 只表示进程存在;要确认图后端可用,请按单机流程加载样例图后请求顶点接口。
6.2 请求 Server
HugeGraphServer 的 RESTful API 包括多种类型的资源,典型的包括 graph、schema、gremlin、traverser 和 task
graph包含vertices、edgesschema包含vertexlabels、propertykeys、edgelabels、indexlabelsgremlin包含各种Gremlin语句,如g.v(),可以同步或者异步执行traverser包含各种高级查询,包括最短路径、交叉点、N 步可达邻居等task包含异步任务的查询和删除
6.2.1 获取 hugegraph 的顶点及相关属性
说明
对于顶点、边等列表请求,Server 可以压缩响应。使用
curl --compressed可自动解压:默认监听地址为
127.0.0.1,其他机器无法直接访问。
调整 Server 监听地址
若将地址调整为 0.0.0.0,Server 将监听所有网卡。生产环境必须启用认证与授权、IP 白名单及最小权限授权,并保留和保护审计日志;不得将 Gremlin、Cypher 等接口直接暴露到公网。
响应体如下:
详细的 API 请参考 RESTful-API 文档。
另外也可以通过访问 localhost:8080/swagger-ui/index.html 查看 API。
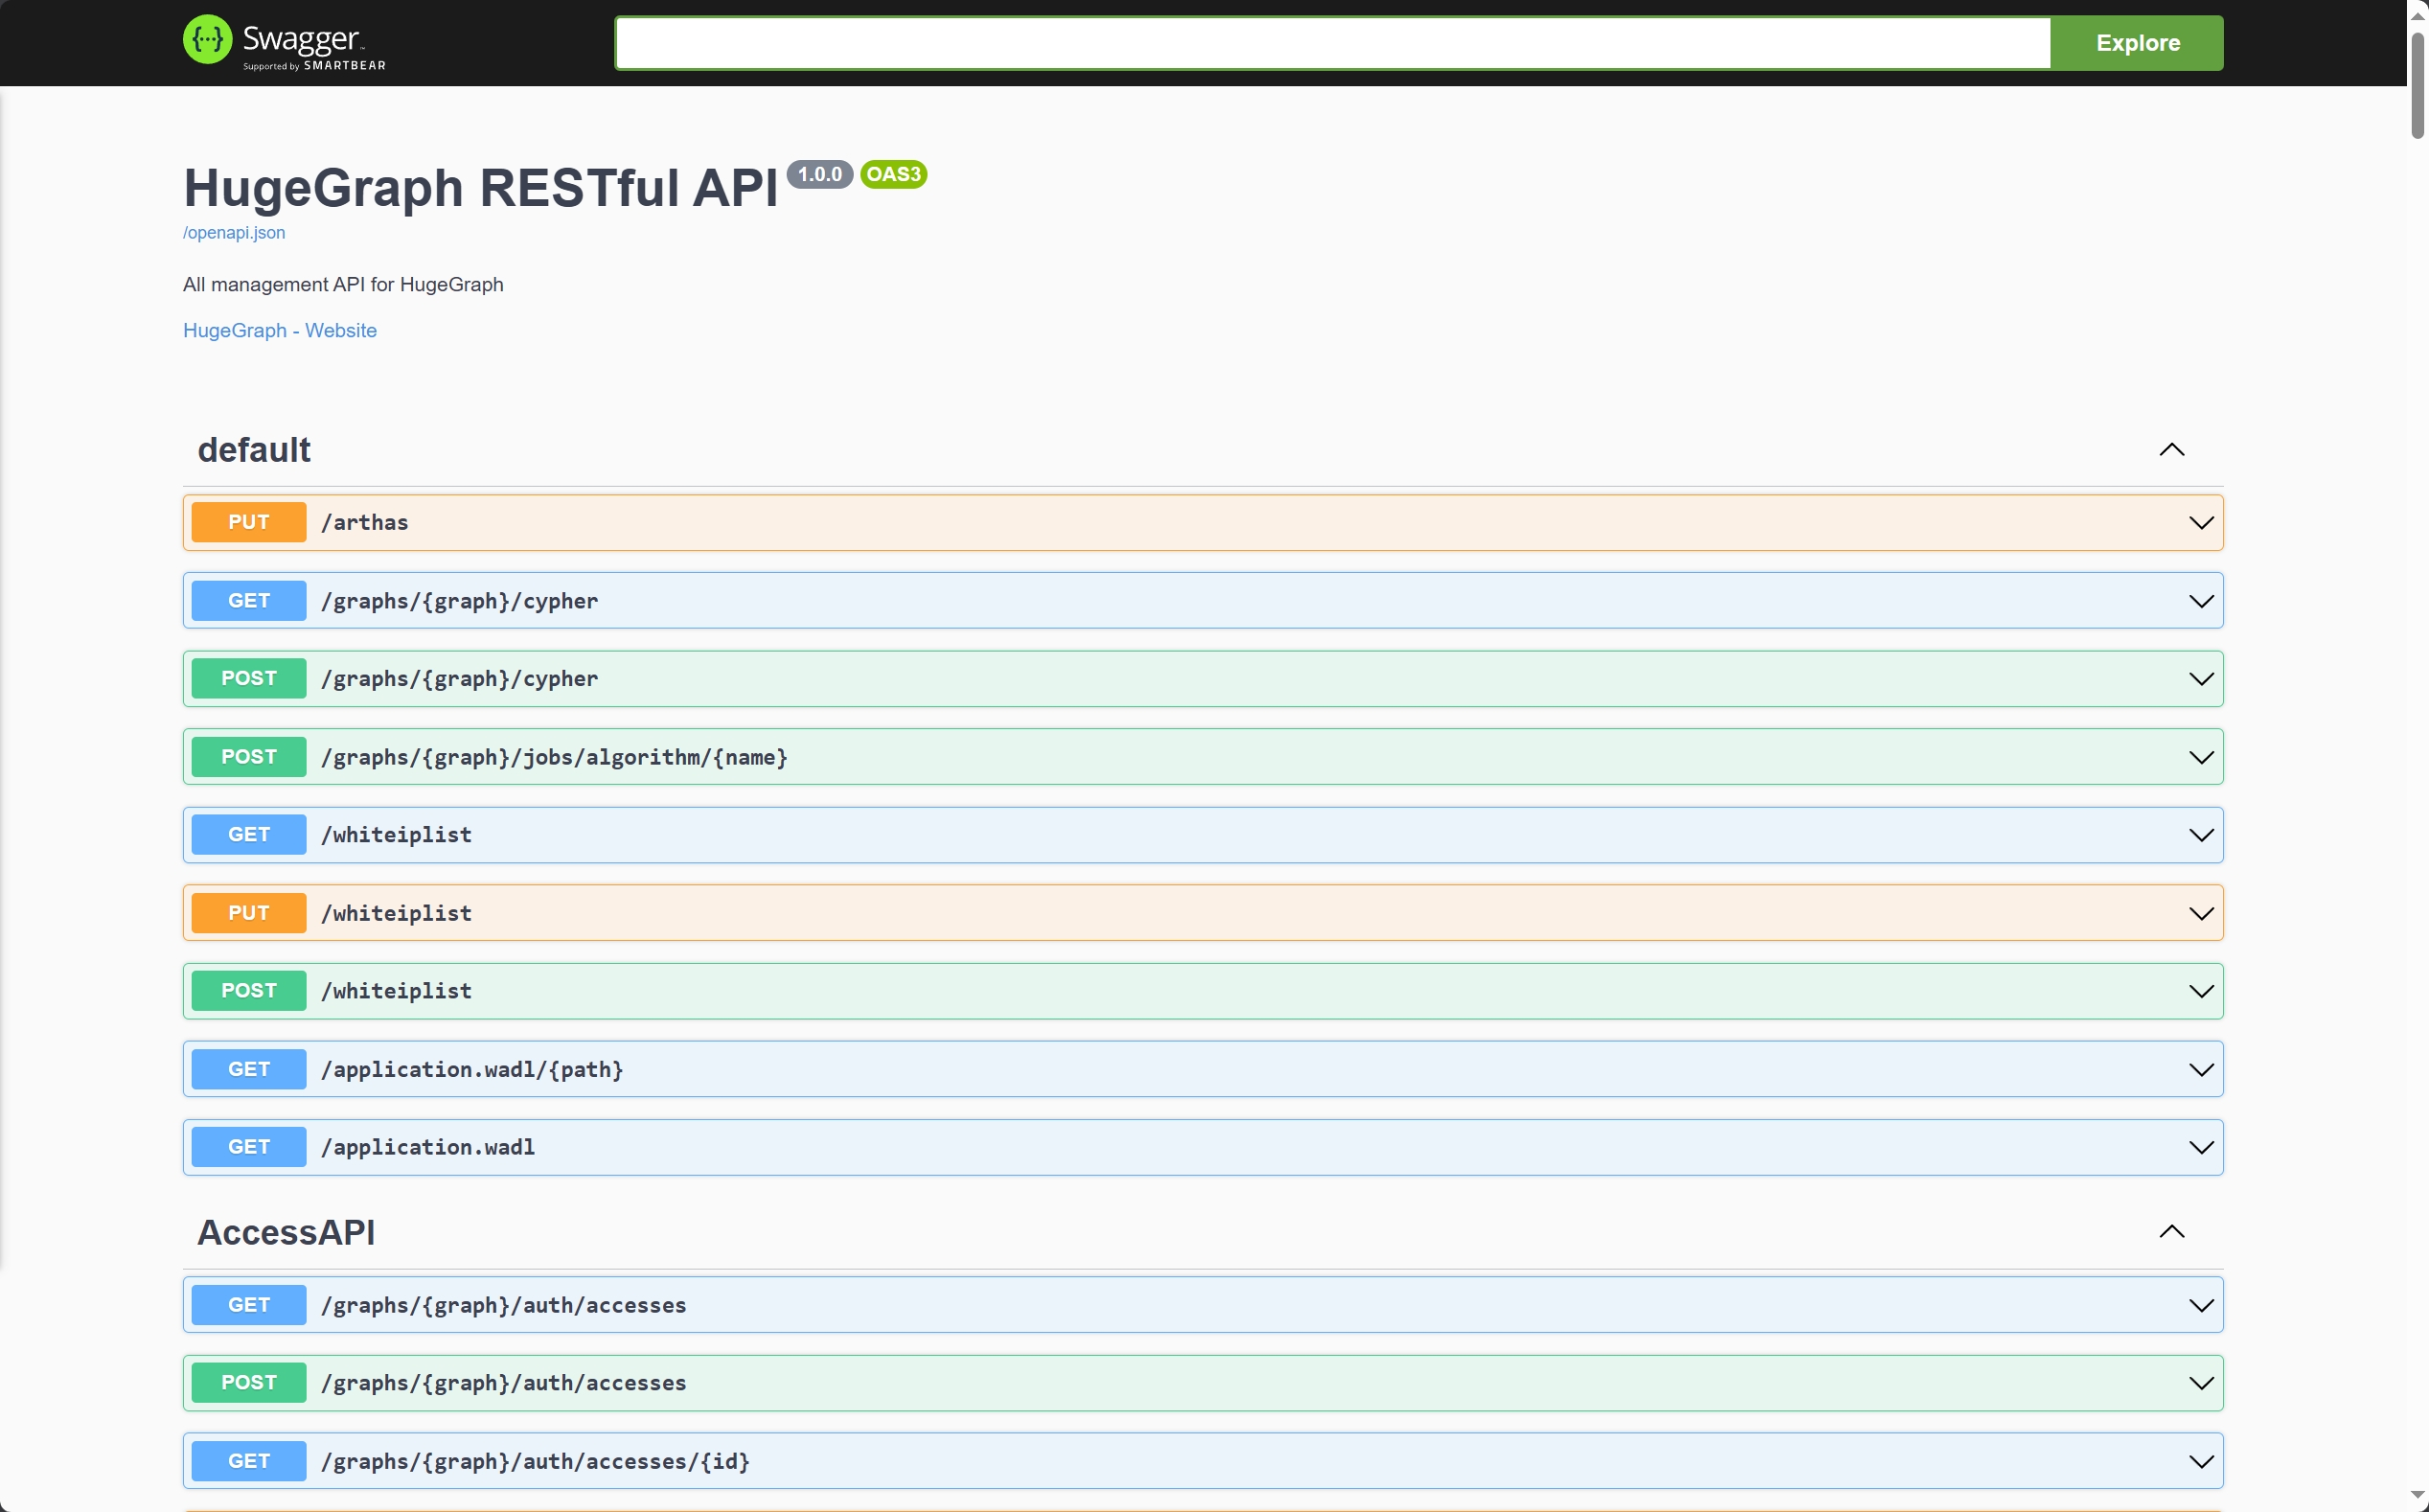
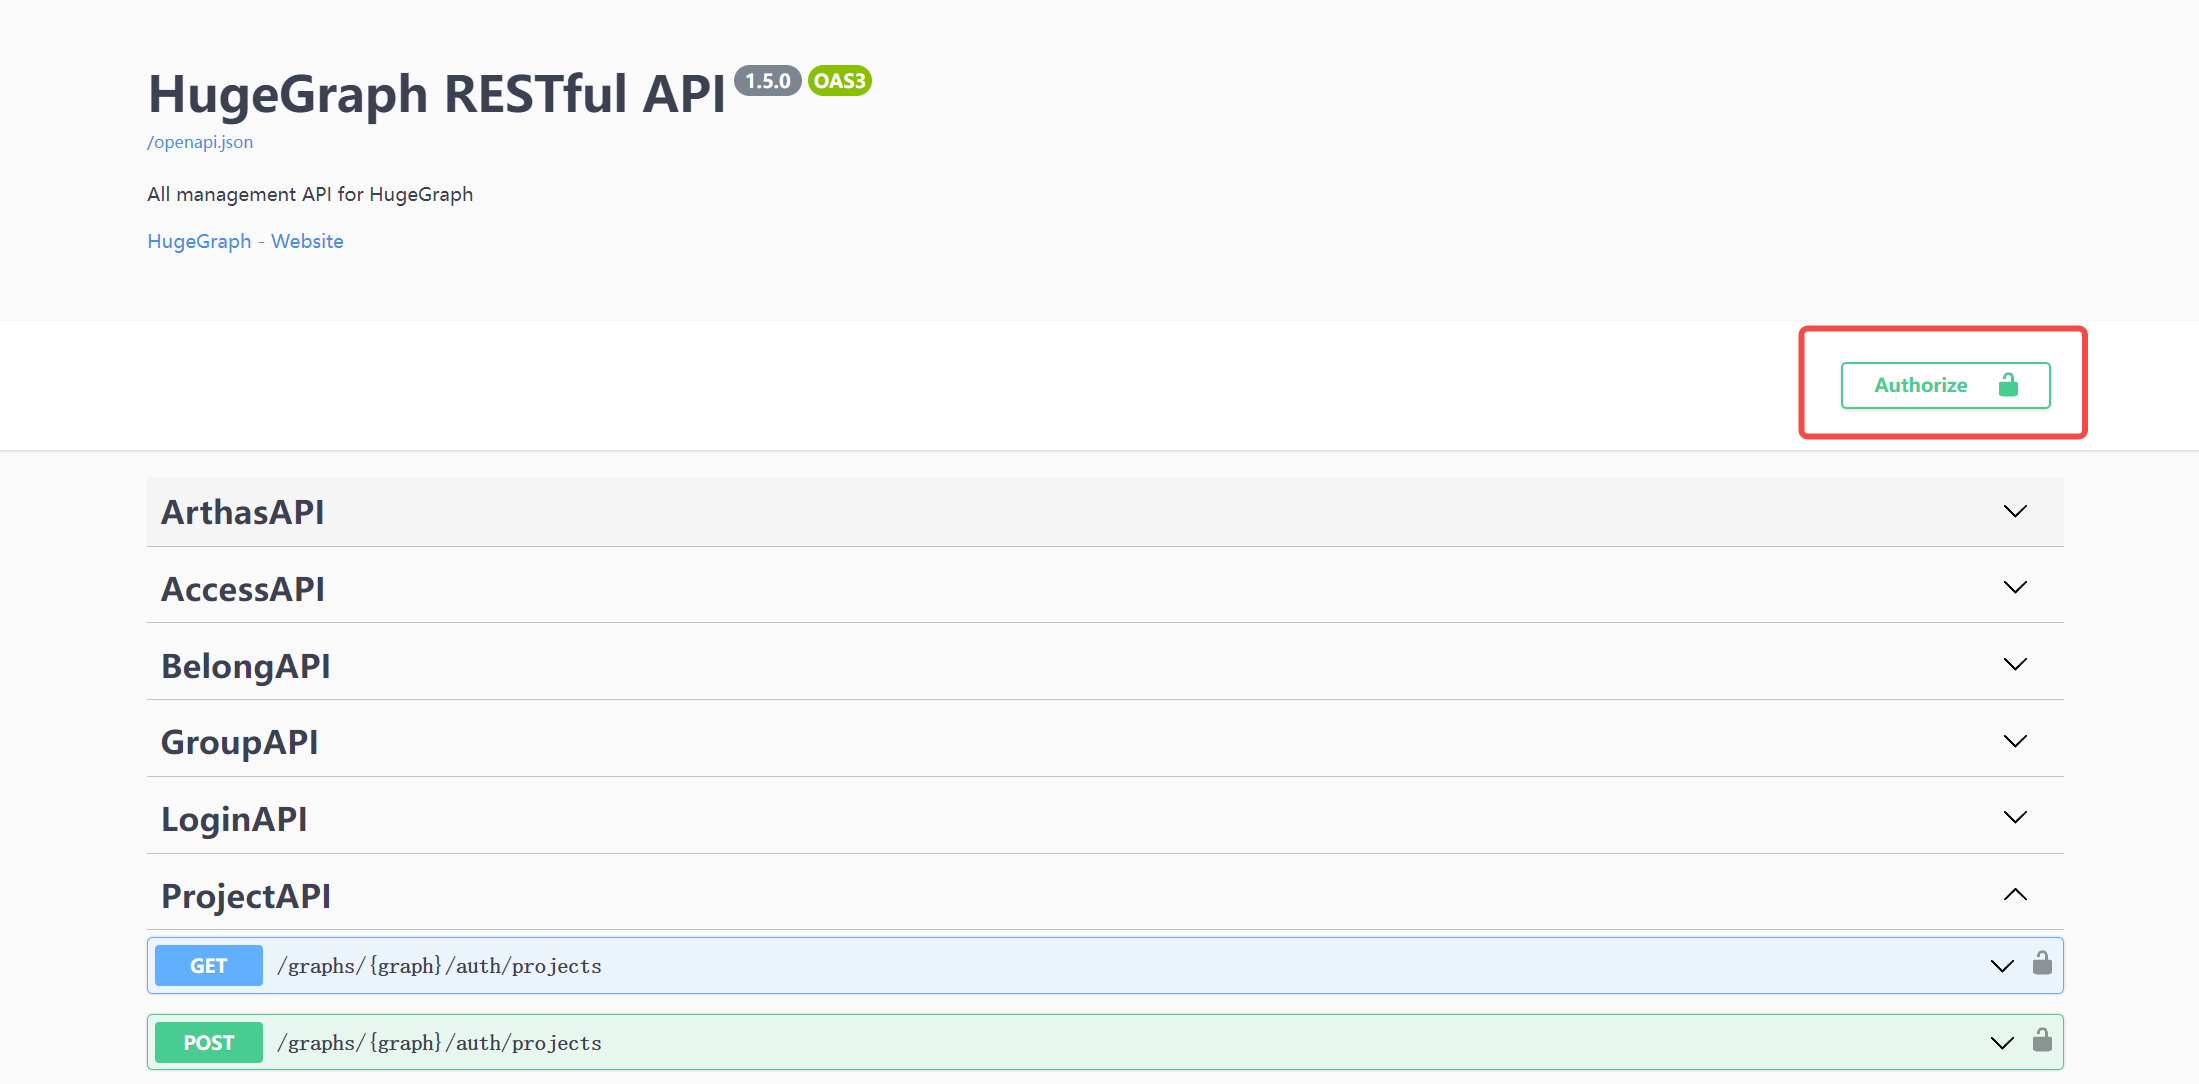
在使用 Swagger UI 调试 HugeGraph 提供的 API 时,如果 HugeGraph Server 开启了鉴权模式,可以在 Swagger 页面输入鉴权信息。
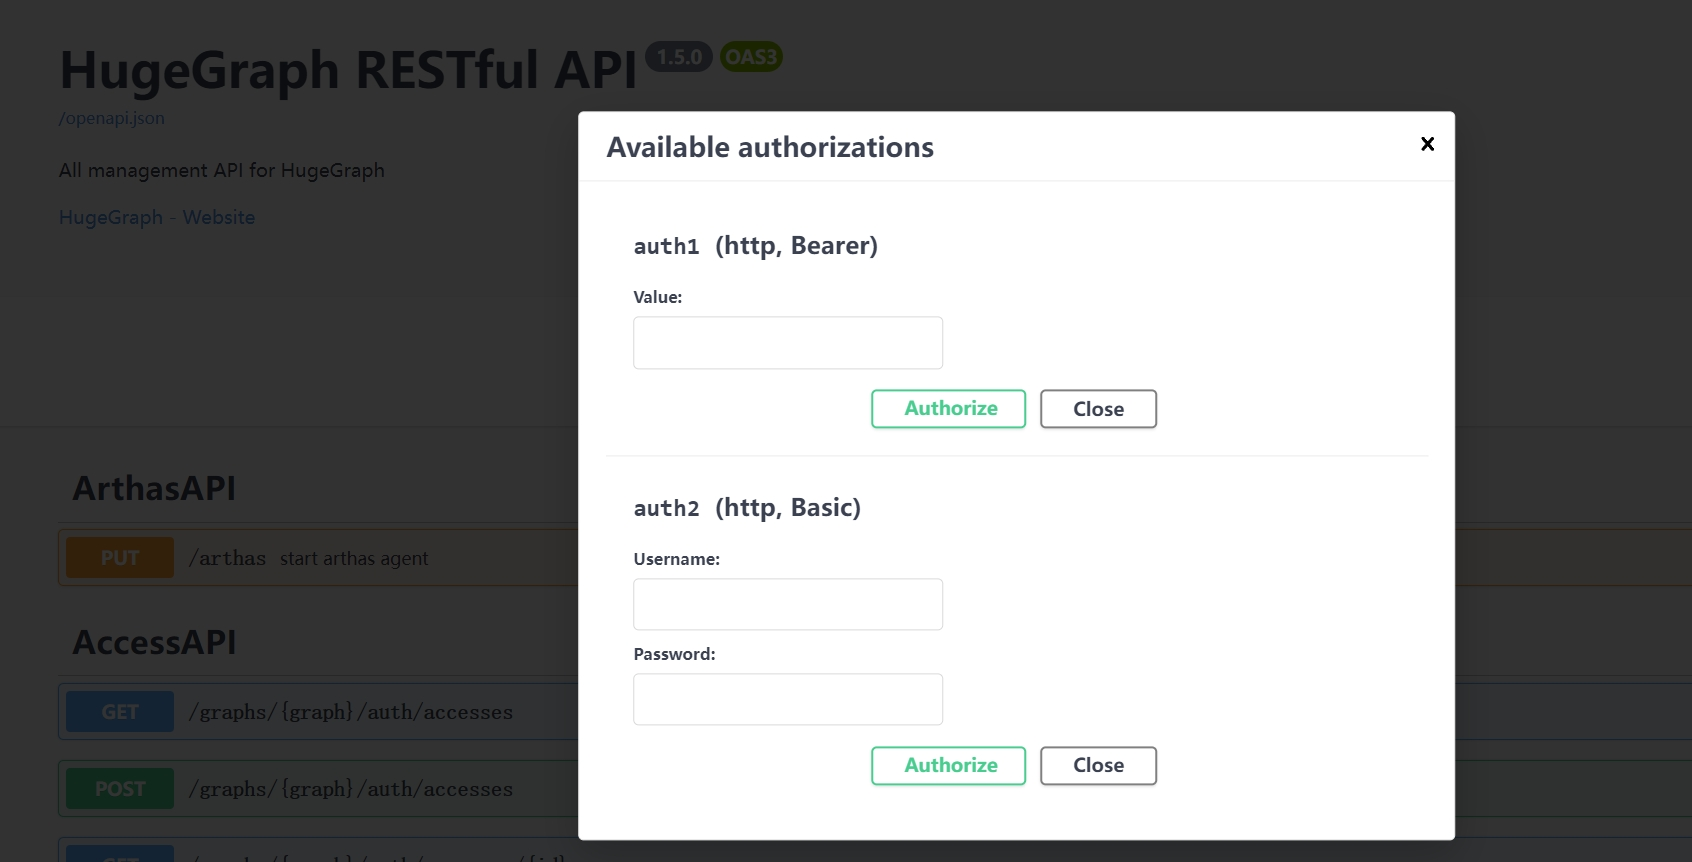
当前 HugeGraph 支持基于 Basic 和 Bearer 两种形式设置鉴权信息。
7 停止 Server
8 使用 IntelliJ IDEA 调试 Server
2 - HugeGraph-PD 快速上手
1 HugeGraph-PD 概述
HugeGraph-PD(Placement Driver)是 HugeGraph 分布式版本的元数据管理组件,负责管理图数据的分布和存储节点的协调。它在分布式 HugeGraph 中扮演着核心角色,维护集群状态并协调 HugeGraph-Store 存储节点。
PD 将集群元数据保存在 pd.data-path 下的内嵌 RocksDB 中,并通过 Raft 在各 PD 节点之间复制,因此 3 节点或 5 节点的 PD 集群在少数节点宕机时仍可继续提供服务。在此基础上,PD 还负责注册和激活 Store 节点、分配与再平衡分区、跟踪 Store 心跳,并响应来自 Store 和 Server 的服务发现请求。
PD 监听三个端口:
| 端口 | 默认值 | 配置项 | 使用方 |
|---|---|---|---|
| gRPC | 8686 | grpc.port | Store 和 Server 客户端 |
| REST | 8620 | server.port | 管理接口、健康检查、监控指标 |
| Raft | 8610 | raft.address | 仅其他 PD 节点 |
2 依赖
2.1 前置条件
- 操作系统:Linux 或 macOS(Windows 尚未经过完整测试)
- Java 版本:HugeGraph 1.8.0+ 使用 Java 17(Maven 源码构建仅接受 JDK 17;启动脚本拒绝低于 17 的运行时;1.7.0 是最后一个支持 Java 11 的版本)
- Maven 版本:≥ 3.6.3(从源码编译时)
3 部署
有两种方式可以部署 HugeGraph-PD 组件:
- 方式 1:下载 tar 包
- 方式 2:源码编译
3.1 下载 tar 包
Apache 下载页目前提供 1.7.0 的完整二进制包,其中包含 PD、Store 和 Server;没有单独列出 PD 二进制包。下载前请在 官方 Apache HugeGraph 下载页核对版本、签名和 SHA512。1.7.0 是孵化期发布的历史版本,归档文件和解压目录仍带 incubating:
3.2 源码编译
只编译 PD 发布包及其依赖模块:
解压后的发布目录只包含三个子目录:bin(启停脚本)、conf(application.yml、application.yml.template、log4j2.xml、verify-license.json)和 lib(hg-pd-service jar 包)。
3.3 Docker 部署
HG_PD_* 环境变量和 /v1/ready 是当前主线源码提供的功能;server 的 1.7.0 发布源码标签尚无这些 Docker 环境变量映射或 readiness API。本文下面的 Docker 示例仅适用于从当前主线源码构建并标记为 local 的镜像;使用 1.7.0 发布资产时,应以该版本随包配置和说明为准:
单独运行当前主线构建的 PD 时,先设置部署专用密钥,并把示例地址替换为容器可达的真实地址:
| 变量 | 必填 | 默认值 | 对应配置项 | 描述 |
|---|---|---|---|---|
HG_PD_GRPC_HOST | 是 | 无 | grpc.host | 本节点对外公布的 gRPC 主机名/IP;容器网络中应使用容器主机名。 |
HG_PD_RAFT_ADDRESS | 是 | 无 | raft.address | 本节点 Raft 地址。 |
HG_PD_RAFT_PEERS_LIST | 是 | 无 | raft.peers-list | 所有 PD 节点的 Raft 地址,含本节点。 |
HG_PD_INITIAL_STORE_LIST | 是 | 无 | pd.initial-store-list | 预期的 Store gRPC 地址。 |
HG_PD_AUTH_SECRET_KEY | 是 | 无 | auth.secret-key | REST Basic 密码;所有 PD REST 客户端都必须使用同一密钥。 |
HG_PD_GRPC_PORT | 否 | 8686 | grpc.port | gRPC 服务端口。 |
HG_PD_REST_PORT | 否 | 8620 | server.port | REST API 端口。 |
HG_PD_DATA_PATH | 否 | /hugegraph-pd/pd_data | pd.data-path | 元数据存储路径。 |
HG_PD_INITIAL_STORE_COUNT | 否 | 1 | pd.initial-store-count | 集群可用所需的最小 Store 数量。 |
HG_PD_ACTUATOR_EXPOSURE | 否 | health,metrics,prometheus | management.endpoints.web.exposure.include | 公开的 Actuator 端点白名单;不允许设置为 *。 |
当前主线 entrypoint 要求以上五个必填变量,生成 SPRING_APPLICATION_JSON 覆盖项后再启动 PD;其他配置继续从镜像内的 conf/application.yml 读取。JAVA_OPTS 会透传给 JVM。旧变量 GRPC_HOST、RAFT_ADDRESS、RAFT_PEERS、PD_INITIAL_STORE_LIST 仍可用,但会输出弃用警告。
PD 镜像的 Docker HEALTHCHECK 每 15 秒检查 /v1/health,它只表示 REST 监听器有响应,不代表 Raft 已形成多数派。Compose 示例中的健康检查也使用这个存活接口;需要在启动 Store 前另行检查 /v1/ready。容器以前台方式运行,Java 退出会让容器退出;只有配置了 Docker 重启策略时容器才会自动重启。Docker 日志可通过 docker logs <container-name> 查看。
当前主线 Compose 的完整启动和最小拓扑见 Store 页面及 docker/README.md。Compose 文件的服务配置来自主线源码;若启动包含 Hubble 的完整拓扑,先按 docker/README.md 生成未跟踪的 Hubble 配置文件。
4 配置
PD 启动脚本读取安装目录中的 conf/application.yml。请使用与安装包版本相同的源文件,不要把发布版和主线配置混用: 1.7.0 发布标签配置;当前主线配置。主线 application.yml 将 auth.secret-key 留空,REST 受保护接口在未设置密钥时会拒绝请求;application.yml.template 不由 PD 启动脚本读取。
4.1 配置项参考
以下表格核对的是 server 主线提交 2f827d6e8c9c62ae858f2fc122b3a192d015e2f4 中的 hg-pd-dist 配置和 Java 默认注入值,不是 1.7.0 发布标签的全部行为。1.7.0 二进制包请使用其标签对应的原始配置;主线源码构建包则以 主线配置文件 为准。
gRPC 与 REST
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
grpc.host | 127.0.0.1 | 无,必填 | 本 PD 对外公布的 gRPC 地址。Store 和 Server 会连到这个地址,因此分布式部署时必须填可访问的 IPv4 地址或主机名,不能用 127.0.0.1 或 0.0.0.0。 |
grpc.port | 8686 | 无,必填 | gRPC 端口。 |
server.port | 8620 | 无,必填 | REST API 端口,同时也是 Raft 成员信息中公布的 REST 端口。 |
application.yml.template 中还有 grpc.netty-server.max-inbound-message-size: 100MB,但 PD 在代码中把 gRPC 服务端的入站消息上限固定为 1 GB,该配置项实际不生效。
Raft
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
raft.address | 127.0.0.1:8610 | 无,必填 | 本节点的 Raft 地址,格式为 host:port。每个节点必须不同,且必须出现在 raft.peers-list 中。 |
raft.peers-list | 127.0.0.1:8610 | 无,必填 | 逗号分隔的全部 PD 节点 Raft 地址(含本节点)。所有节点上必须完全一致。 |
raft.enable | 未设置 | true | 为 true 时元数据写入经过 Raft 状态机;为 false 时 PD 直接写本地存储,不做复制。 |
raft.ip-whitelist.enabled | 未设置 | true | 为 true 时 Raft RPC 端口只接受由 raft.peers-list 解析出的地址的连接,其他连接会被断开并记录 Blocked connection from <ip>。peer 列表变更时白名单会重新解析,但主机名不变而 IP 变化的情况(例如容器重启)仍需重启 PD。 |
raft.snapshotInterval | 未设置 | 300 | Raft 快照生成间隔(秒)。 |
raft.rpc-timeout | 未设置 | 10000 | Raft RPC 的连接、请求和安装快照超时时间(毫秒)。 |
PD 核心
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
pd.data-path | ./pd_data | 无,必填 | 元数据目录。rocksdb/ 子目录存放 RocksDB 数据,pd_raft/ 子目录存放 Raft 日志、元信息和快照。 |
pd.patrol-interval | 1800 | 300 | 巡检周期(秒)。巡检会检查各 Store 上的分区健康状况并平衡分区数量。 |
pd.initial-store-count | 1 | 3 | 活跃 Store 节点的最小数量。低于该值时集群状态变为 Cluster_Not_Ready,整个集群视为不可用。建议设为实际部署的 Store 数量。 |
pd.initial-store-list | 127.0.0.1:8500 | 空 | 逗号分隔的 Store gRPC 地址(ip:port),列表中的 Store 注册后自动激活。条目也可以带分组 id,写作 store_address/group_id。 |
pd.cluster_id | 未设置 | 1 | 集群 id,用于区分不同的 PD 集群。 |
Store 管理
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
store.keepAlive-timeout | 未设置 | 300 | 心跳超时时间(秒)。超过该时间未收到心跳,Store 视为临时不可用,其分区 leader 转移到其他副本。 |
store.max-down-time | 172800 | 1800 | 超过该时间(秒)后 Store 视为永久不可用,其副本重新分配到其他机器。 |
store.monitor_data_enabled | true | false | 是否持久化 Store 监控采样数据。 |
store.monitor_data_interval | 1 minute | 1 minute | 采样间隔,格式为 <数字> <单位>,单位为 second、minute、hour、day、month、year 之一;省略数字时按 1 计。 |
store.monitor_data_retention | 1 day | 1 day | 监控数据保留时长,格式同上。 |
分区
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
partition.default-shard-count | 1 | 3 | 每个分区的副本数。生产集群建议设为 3。 |
partition.store-max-shard-count | 12 | 24 | 单个 Store 最多承载的分区副本数。 |
初始分区数由这两个配置项和 pd.initial-store-list 的长度推导得出:
服务发现、License 与监控
| 配置项 | 主线目录值 | 内置默认值 | 描述 |
|---|---|---|---|
discovery.heartbeat-try-count | 未设置 | 3 | 客户端注册后连续丢失多少次心跳就删除其注册信息。 |
license.verify-path | ./conf/verify-license.json | 无,配置键必填 | PD 发行目录随包提供该 JSON 文件;当前主线代码没有读取此配置项的运行时位置。 |
license.license-path | ./conf/hugegraph.license | 无,配置键必填 | 目标路径不会随包带入 license 文件;内部 gRPC putLicense 会把上传内容写到此处。当前主线的 REST GET /v1/license 返回空对象,不因文件缺失而阻止 PD 启动。 |
auth.secret-key | 空 | 空 | 当前主线的 PD REST Basic 密码;合法用户名为 hg、store、hubble、vermeer。Docker 镜像要求设置;裸机 PD 可在密钥为空时启动,但受保护 REST 请求都会被拒绝。 |
management.metrics.export.prometheus.enabled | true | Spring Boot 默认值 | 是否暴露 /actuator/prometheus。 |
management.endpoints.web.exposure.include | health,metrics,prometheus | Spring Boot 默认只暴露 health | Actuator 暴露白名单;这些端点不经过 PD REST Basic 拦截器。 |
logging.config | file:./conf/log4j2.xml | 无 | Log4j2 配置文件,会写出 logs/hugegraph-pd.log、logs/hugegraph-pd_raft.log 和 logs/audit-hugegraph-pd.log。 |
线程池
| 配置项 | 内置默认值 | 描述 |
|---|---|---|
thread.pool.grpc.core | 600 | 处理 gRPC 请求的线程池核心线程数。 |
thread.pool.grpc.max | 1000 | 该线程池的最大线程数。 |
thread.pool.grpc.queue | 无上限 | 该线程池的队列容量。 |
job.uninterruptibleThreadPool.core | 0 | 元数据后台任务线程池的核心线程数。小于等于 0 时取可用处理器数的一半。 |
job.uninterruptibleThreadPool.max | 256 | 该线程池的最大线程数。 |
job.uninterruptibleThreadPool.queue | 无上限 | 该线程池的队列容量。 |
4.2 单节点配置
在主线源码构建的发布目录中,以 conf/application.yml 为基础,只需按节点改写 gRPC/Raft 地址和数据路径,并设置 auth.secret-key。以下值仅适用于开发测试;单节点 PD 不提供多数派容错,partition.default-shard-count: 1 表示每个分区只有一个副本。
可以用 openssl rand -hex 24 生成部署密钥;使用 Docker 时通过 HG_PD_AUTH_SECRET_KEY 传入。1.7.0 发布标签的认证行为不同,详见“REST API 认证”。
4.3 三节点集群配置
生产环境请部署 3 个或 5 个 PD 节点,节点数取奇数以保证 Raft 总能形成多数派。3 节点集群可容忍 1 个节点故障。raft.peers-list 必须列出全部节点,并且在所有节点上逐字节一致;grpc.host 和 raft.address 每个节点各不相同。
节点 1(192.168.1.10):
节点 2(192.168.1.11)和节点 3(192.168.1.12)使用同一份配置,只把 grpc.host 和 raft.address 换成自己的地址:
若要在同一台机器上启动 3 个 PD 节点做测试,需为每个节点分别指定 pd.data-path 和各自的端口,例如 raft 端口 8610/8611/8612、gRPC 端口 8686/8687/8688、REST 端口 8620/8621/8622。
在 Docker 桥接网络中,同样的配置来自环境变量,并使用容器主机名而非 IP 地址:
5 启动与停止
5.1 启动 PD
在 PD 安装目录下执行:
脚本要求 PATH 或 JAVA_HOME 中有 17 及以上版本的 JDK(1.7.0 要求 11 及以上);如果发现已有 Java 进程在使用本安装目录的 conf 目录,脚本会直接退出,不做任何事。
下文的生命周期说明适用于当前主线构建;上文下载的 1.7.0 启动脚本不包含这些修复。 支持的参数如下,GC 的版本限制见下文:
| 参数 | 取值 | 默认值 | 描述 |
|---|---|---|---|
-d | true、false | true | 守护进程模式,详见下文。 |
-g | 见下文版本限制 | 不设置 | 选择垃圾回收器;不支持的参数会中止启动。 |
-j | JVM 参数 | 空 | 额外的 JVM 参数,例如 -j "-Xmx8g -Xms8g"。 |
-y | true、false | false | 挂载 OpenTelemetry Java agent。首次使用时会把 agent 下载到 plugins/ 并校验 MD5,trace 通过 gRPC 上报到 http://127.0.0.1:4317。 |
master 构建接受 g1、G1、zgc 和 ZGC。
上文下载的 1.7.0 启动脚本仅接受显式指定 zgc 或 ZGC;-g g1、-g G1 和其他参数会中止启动。
默认路径请省略 -g;参数被拒绝时,查看 logs/hugegraph-pd-stdout.log。
-d 参数控制守护进程模式:
-d true(默认):以后台守护进程方式运行,脚本立即返回。-d false:以前台模式运行,脚本通过exec替换为 Java 进程,容器/进程管理器的进程即为 Java 本身。在 Docker 或进程管理器(systemd、supervisord)下运行时请使用此参数,以便在崩溃时自动检测并重启服务。
每个参数都有对应的环境变量:DAEMON、GC_OPTION、USER_OPTION 和 OPEN_TELEMETRY。设置 JAVA_OPTIONS 会完全替换脚本计算出的堆参数,否则脚本会根据可用内存在 512 MB 到 32 GB 之间选择堆大小。设置 STDOUT_MODE=true 时 JVM 输出保留在 stdout,不再重定向到 logs/hugegraph-pd-stdout.log,Docker 镜像正是这样做的。
启动成功后,可以在 logs/hugegraph-pd-stdout.log 中看到类似以下的日志:
进程号会写入 bin/pid。
5.2 停止 PD
在 PD 安装目录下执行:
脚本读取 bin/pid,向该进程发送终止信号,最多等待 30 秒直到进程退出,然后删除 pid 文件。如果 bin/pid 不存在,脚本会提示并正常退出。
6 分布式集群的启动顺序
请按以下顺序启动各组件:
- 全部 PD 节点。它们组成 Raft 组并选出 leader。对每个节点检查
GET /v1/ready;仅当 HTTP 状态为200且响应中的ready为true时,再启动 Store。GET /v1/health只检查 REST 监听器是否存活。 - 全部 Store 节点。每个 Store 通过 gRPC 向 PD 注册,PD 会自动激活
pd.initial-store-list中列出的 Store。等到GET /v1/stores中每个 Store 的state都是Up再继续。 - 全部 Server 节点。Server 读取
pd.peers,并依赖 PD 报告至少有一个存活的 Store 才能完成分区分配。
sequenceDiagram
    participant 运维者
    participant PD
    participant Store
    participant Server
    运维者->>PD: GET /v1/ready(逐个检查 PD)
    PD-->>运维者: 200 且 ready=true
    运维者->>Store: 启动 Store
    Store->>PD: gRPC 注册与心跳
    运维者->>PD: GET /v1/stores(Basic 认证)
    PD-->>运维者: 每个目标 Store 状态为 Up
    运维者->>Server: 启动 Server
    Server->>PD: gRPC 查询分区与服务发现
    Server->>Store: gRPC 访问图数据
主线 Compose 中 Store 的 depends_on: condition: service_healthy 只等待 PD /v1/health 存活检查,Server 同样只等待 Store REST 存活检查;Server entrypoint 还会轮询 PD /v1/stores,直到有 Store 报告 Up 才启动 HugeGraph。docker compose up --wait 因而不能替代 PD Raft 就绪与 Store 注册状态检查。
停止时顺序相反:先停 Server,再停 Store,最后停 PD。
7 验证
7.1 REST API 认证
当前主线除 /actuator/*、/v1/health、/v1/ready 和 /v1/prom/targets/* 之外,所有 PD REST 路径都要求 HTTP Basic Authorization。用户名必须是内部服务名 hg、store、hubble、vermeer 之一,密码必须等于 auth.secret-key;无密钥或密码不匹配时会返回 HTTP 401。用启动 PD 时的同一密钥检查 Store 列表:
bin/wait-storage.sh 通过 PD_AUTH_USER、PD_AUTH_PASSWORD 配置同一凭据。1.7.0 发布标签的认证实现只检查用户名是否属于内部服务名,不比较密码;不要把该旧版行为套用到当前主线源码构建包。
生产环境分别保护 Server 与 PD 端口
生产环境的 Server 图 API 必须按 Server 认证与授权配置启用 Auth、IP 白名单和最小权限授权,并保留、保护 Server audit-*.log。这些设置不保护 PD:当前主线 PD REST 使用 auth.secret-key;1.7.0 的认证实现仅检查用户名是否属于内部服务名,不比较密码。Raft 端口应保持 raft.ip-whitelist.enabled 并只允许配置的 peer,PD REST 与 gRPC 端口也必须限制在受信网络内。PD 的 /v1/health、/v1/ready 和 Actuator 探针无需 Basic 认证,须由网络策略限制可达范围;主线默认日志配置生成的 logs/audit-hugegraph-pd.log 也须纳入日志保护。
7.2 健康检查
GET /v1/health 不需要凭据,返回 200 且响应体为空,只表示 PD REST 监听器已启动:
Spring Boot actuator 端点同样可用,输出更直观:
/actuator/health 的 {"status":"UP"} 也不代表 PD Raft 集群已有可用 leader。主线新增的 GET /v1/ready 会在 PD Raft 节点已激活并能看到 leader 时返回 HTTP 200 和 ready:true;尚未就绪时返回 HTTP 503 和 ready:false:
7.3 集群与成员状态
查看 PD 成员以及当前的 Raft leader:
响应中包含 pdList、选出的 pdLeader、numOfService、numOfNormalService 和 stateCountMap。健康的 3 节点 PD 集群中,numOfService 和 numOfNormalService 都应为 3,且恰好有一个成员的 role 为 Leader。
GET /v1/cluster 在成员列表之外还返回 Store 列表、图列表和集群整体状态;GET / 返回一份简要汇总(leader 地址、集群状态、成员数、Store 数、图数量、分区数)。
7.4 Store 状态
也可以通过 PD API 查看 Store 节点状态:
如果响应中 state 为 Up,说明对应的 Store 节点运行正常。下面的示例只有一个 Store 节点。在一个健康的 3 节点部署中,storeId 列表应包含 3 个 ID,且 stateCountMap.Up、numOfService 和 numOfNormalService 都应为 3。
7.5 其他 REST 接口
下表中的路径均相对于 http://<pd-host>:8620,除注明外都需要 7.1 中的 Basic 认证头。
| 方法与路径 | 描述 |
|---|---|
GET / | 集群简要统计:leader、状态、成员数、Store 数、图数量、分区数 |
GET /v1/health | 存活检查;HTTP 200 不代表 Raft 就绪,无需认证 |
GET /v1/ready | Raft readiness;HTTP 200 且 ready:true 表示本节点已激活并看到 leader,无需认证(当前主线) |
GET /v1/cluster | 集群完整统计:PD 成员、Store、图、分区 |
GET /v1/members | PD 成员列表,含角色和选出的 leader |
POST /v1/members/change | 修改 Raft peer 列表,请求体 {"peerList": "..."} |
GET /v1/stores | 已注册的 Store 节点及其状态和统计信息 |
GET /v1/store/{storeId} | 单个 Store 节点 |
POST /v1/store/{storeId} | 修改 Store 状态,请求体 {"storeState": "..."} |
DELETE /v1/store/{storeId} | 从集群中移除 Store |
POST /v1/store/log | Store 状态变更日志,请求体 {"startTime": "...", "endTime": "..."} |
GET /v1/storesAndStats | Store 原始元数据,用于调试 |
GET /v1/store_monitor/{storeId} | Store 监控采样数据(文本) |
GET /v1/store_monitor/json/{storeId} | Store 监控采样数据(JSON) |
GET /v1/shards | 所有分区的所有副本,含 store id、角色、状态和进度 |
GET /v1/shardGroups | Shard 分组 |
GET /v1/shardGroupsCache | PD 内存缓存中的 shard 分组 |
GET /v1/shardLeaders | 按 Store raft 地址分组的分区 leader |
GET /v1/balanceLeaders | 在各 Store 之间重新平衡分区 leader |
GET /v1/partitions | 分区列表及其状态和统计信息 |
GET /v1/highLevelPartitions | 分区列表,含各图的 key 数量和数据大小 |
GET /v1/partitionsAndStats | 分区原始元数据,用于调试 |
POST /v1/partitions/log | 分区变更日志,请求体 {"startTime": "...", "endTime": "..."} |
GET /v1/resetPartitionState | 重置所有分区的状态 |
GET /v1/graphs | 图列表 |
GET /v1/graph/** | 按名称查询单个图 |
POST /v1/graph/** | 修改图的分区数,请求体 {"partitionCount": N} |
GET /v1/graph/partitionSizeRange | 集群允许的分区数上下限 |
GET /v1/graph-spaces | 图空间列表 |
GET /v1/graph-spaces/** | 单个图空间 |
POST /v1/graph-spaces/** | 修改图空间 |
POST /v1/registry | 注册一个服务实例用于服务发现 |
POST /v1/registryInfo | 查询已注册的实例 |
GET /v1/allInfo | 所有已注册的实例 |
GET /v1/license | 旧接口,当前主线返回空对象 |
GET /v1/license/machineInfo | License 校验看到的 IP 和 MAC 地址 |
GET /v1/task/patrolStores | 立即执行 Store 巡检任务 |
GET /v1/task/patrolPartitions | 立即执行分区巡检任务 |
GET /v1/task/balancePartitions | 在各 Store 之间重新平衡分区 |
GET /v1/task/splitPartitions | 立即执行自动分区拆分 |
GET /v1/task/balanceLeaders | 重新平衡分区 leader |
GET /v1/task/compact | 让 Store 节点对其分区的 RocksDB 文件做 compaction |
GET /v1/prom/targets/{appName} | Prometheus 服务发现目标,无需认证 |
GET /v1/prom/targets-all | 所有应用类型的 Prometheus 目标 |
GET /v1/prom/sd_config | Prometheus HTTP 服务发现配置 |
GET /actuator/health | Spring Boot 健康检查,无需认证 |
GET /actuator/metrics | Spring Boot 监控指标,无需认证 |
GET /actuator/prometheus | Prometheus 抓取端点,无需认证 |
两个 log 接口接受形如 {"startTime": "...", "endTime": "..."} 的时间范围,yyyy-MM-dd HH:mm:ss 和 yyyy-MM-dd 都是可接受的格式。
PD 以 hg 前缀注册自己的指标,因此 /actuator/prometheus 除标准 JVM 指标外还会暴露 hg_up、hg_graphs、hg_stores 和 hg_terms,在存在图之后还会有按图统计的分区和大小指标。
在 1.7.0 之后的版本中,PD 还会为每个已注册的 Store 导出 hg_store_state{store="<id>",state="<state>"}:Store 当前状态(Unknown、Pending、Up、Offline、Exiting 或 Tombstone)对应的序列为 1,其余为 0;以及 hg_store_leader_count{store="<id>"},即 leader 位于该 Store 上的分片组数量。重建后的 Store 在 leader 迁回之前会报告 0。所有 PD 成员读取的是同一份复制的元数据,因此聚合这些序列前请先只选取一个实例。
3 - HugeGraph-Store 快速上手
1 HugeGraph-Store 概述
HugeGraph-Store 是 HugeGraph 分布式版本的存储节点组件,负责实际存储和管理图数据。它与 HugeGraph-PD 协同工作,共同构成 HugeGraph 的分布式存储引擎,提供高可用性和水平扩展能力。
每个 Store 节点使用 RocksDB 保存图数据,并通过 Raft(JRaft)进行复制:每个分区是一个独立的 Raft 组,因此分区在丢失少数副本时仍可继续工作。Store 节点之间并不直接感知彼此,它们向 PD 注册,由 PD 下发分区分配,并通过心跳上报状态。HugeGraph-Server 先从 PD 查询分区位置,再通过 gRPC 访问 Store。
2 依赖
2.1 前置条件
- 操作系统:Linux 或 macOS(Windows 尚未经过完整测试)
- Java 版本:HugeGraph 1.8.0+ 使用 Java 17(Maven 源码构建仅接受 JDK 17;启动脚本拒绝低于 17 的运行时;1.7.0 是最后一个支持 Java 11 的版本)
- Maven 版本:≥ 3.6.3(从源码编译时)
- 如需进行多节点部署,请先部署 HugeGraph-PD
3 部署
有两种方式可以部署 HugeGraph-Store 组件:
- 方式 1:下载 tar 包
- 方式 2:源码编译
3.1 下载 tar 包
Apache 下载页目前提供 1.7.0 的完整二进制包,其中包含 PD、Store 和 Server;没有单独列出 Store 二进制包。下载前请在 官方 Apache HugeGraph 下载页核对版本、签名和 SHA512。1.7.0 是孵化期发布的历史版本,归档文件和解压目录仍带 incubating:
3.2 源码编译
如果只想单独编译 Store 而不是整个仓库,需要先编译 hugegraph-struct,因为 Store 依赖它:
生成的目录只包含 bin/、conf/ 和 lib/hg-store-node-{version}.jar。
3.3 Docker 部署
HG_STORE_* 环境变量映射是当前主线源码提供的功能;server 的 1.7.0 发布源码标签尚无这些映射。本文下面的 Docker 示例仅适用于从当前主线源码构建并使用同一个本地标签的 PD、Store 和 HStore Server 镜像:
首次启动前,按 docker/README.md 的认证环境步骤 在 docker/ 创建 .env。
该步骤使用 umask 077 并拒绝覆盖已有文件;若 .env 已存在,应保留原文件并编辑补全缺少的项。不要为已初始化的数据目录重新生成 HG_PD_AUTH_SECRET_KEY。此文件由仓库 .gitignore 忽略,仍不要提交。
每次在新 shell 执行 Compose 或 PD REST 命令前,都从 docker/ 目录加载同一文件:
后续重启或调用 PD REST 时,先按上面的方式加载同一个密钥;不要为已初始化的数据目录重新生成新值。HUGEGRAPH_VERSION=local 和 HUGEGRAPH_PULL_POLICY=never 是此 Compose 命令的参数,每次运行 Compose 生命周期命令时都要显式带上。
若要启动 Compose 文件中的 Hubble 服务,需使用拓扑对应的未跟踪配置文件。最小拓扑 docker-compose-hstore.yml 使用 conf/hubble/hstore.local.properties;
HA 拓扑 docker-compose-3pd-3store-3server.yml 使用 conf/hubble/hstore-ha.local.properties。
上述 README 初始化步骤会用共享 PD 密钥生成两份文件。若文件缺失或需更新,先从 docker/ 目录载入已有 .env,再执行对应命令:
多节点拓扑中的服务名是 pd0–pd2、store0–store2 和 server0–server2。该主线 Compose 文件也应使用上述本地构建的同标签镜像,不能将 HUGEGRAPH_VERSION=1.7.0 发布镜像与主线 Compose 文件混用。
单独运行当前主线构建的 Store 时,将示例地址换成 Store 与 PD 均可路由的实际地址:
当前主线 Docker 环境变量:
| 变量 | 必填 | 默认值 | 对应配置项 | 描述 |
|---|---|---|---|---|
HG_STORE_PD_ADDRESS | 是 | 无 | pdserver.address | PD gRPC 地址,多个地址用逗号分隔。 |
HG_STORE_GRPC_HOST | 是 | 无 | grpc.host | 本节点对外公布的 gRPC 主机名/IP;容器网络中应使用容器主机名。 |
HG_STORE_RAFT_ADDRESS | 是 | 无 | raft.address | 本节点的 Raft 地址。 |
HG_STORE_GRPC_PORT | 否 | 8500 | grpc.port | gRPC 服务端口。 |
HG_STORE_REST_PORT | 否 | 8520 | server.port | REST API 端口。 |
HG_STORE_DATA_PATH | 否 | /hugegraph-store/storage | app.data-path | 数据存储路径。 |
当前主线 entrypoint 将这些变量写入 SPRING_APPLICATION_JSON,覆盖镜像内 conf/application.yml;其余配置仍从该文件和 application-pd.yml 读取,然后以前台方式启动 Java。旧变量 PD_ADDRESS、GRPC_HOST、RAFT_ADDRESS 仍可用,但会输出弃用警告。
PD 和 Store 的 Docker HEALTHCHECK 都检查 /v1/health,只说明本地 REST 监听器有响应。Compose 的 depends_on 也以此作为启动门槛,因此还需单独检查 PD /v1/ready 与 PD /v1/stores 中的 Store Up 状态。Store 镜像默认设置 STDOUT_MODE=true;其 Dockerfile 只声明 EXPOSE 8520,从 Docker 网络外访问 gRPC 8500 或 Raft 8510 时需另行发布端口。
4 配置
Store 从 conf/ 读取两个配置文件。1.7.0 发布标签的源文件见 application.yml 和 application-pd.yml;当前主线文件见 application.yml 和 application-pd.yml。主线默认配置把 spring.profiles.include: pd 加载的 RocksDB 设置放在第二个文件中;启动脚本指定 application.yml。
application.yml,主配置文件(PD 地址、各端口、Raft、数据路径)application-pd.yml,由application.yml中的spring.profiles.include: pd引入,包含 RocksDB 内存设置和 Actuator 暴露配置
4.1 application.yml
以下配置参考表核对的是 server 主线提交 2f827d6e8c9c62ae858f2fc122b3a192d015e2f4 的发行目录值和 Java 默认注入值;1.7.0 发布包请使用其版本标签对应的配置文件,不要跨版本覆盖。
4.2 application-pd.yml
此文件只保存 rocksdb 参数和 Actuator 暴露设置。
生产环境分别保护 Server 与 Store 端口
生产环境的 Server 图 API 必须按 Server 认证与授权配置启用 Auth、IP 白名单和最小权限授权,并保留、保护 Server audit-*.log。这些设置不保护 Store:主线默认配置暴露所有 Actuator 端点,且没有 PD 式 Basic 认证保护;必须将 Store REST、gRPC 和 Raft 端口限制在集群与受信运维网络内。
4.3 配置项参考
下表中「当前主线目录值」来自前述两个主线配置文件,「代码默认值」是配置项缺失时节点使用的回退值;目录中未列出的配置项应以代码默认值为准。
核心
| 配置项 | 当前主线目录值 | 代码默认值 | 说明 |
|---|---|---|---|
pdserver.address | localhost:8686 | 必填 | PD gRPC 地址,多个地址用逗号分隔。Store 在此注册并获取分区分配。必须填写 PD 的 grpc.port,不是 PD 的 REST 端口。 |
grpc.host | 127.0.0.1 | 必填 | 本节点对外公布的 gRPC 地址。应设置为可路由的 IP 或主机名,127.0.0.1 只适用于单机部署。 |
grpc.port | 8500 | 必填 | gRPC 端口,Server 和 Store 客户端连接此端口。 |
grpc.netty-server.max-inbound-message-size | 1000MB | gRPC 默认值 | 单个入站 gRPC 消息的最大大小,由 grpc-spring-boot-starter 的 Netty 服务端读取。 |
grpc.server.wait-time | 未设置 | 3600 | 扫描流等待客户端消费一页数据的秒数,超时后服务端中止该流。 |
server.port | 8520 | 必填 | REST 和 Actuator 端口,同时以 rest.port 标签上报给 PD。 |
Raft
| 配置项 | 当前主线目录值 | 代码默认值 | 说明 |
|---|---|---|---|
raft.address | 127.0.0.1:8510 | 必填 | 本节点的 Raft 服务地址,格式为 host:port,必须能被其他 Store 节点访问。这里不需要配置 peer 列表:分区 Raft 组的成员由 PD 下发。 |
raft.disruptorBufferSize | 1024 | 0 | Raft 任务队列大小。设为 0 时按 rocksdb.total_memory_size 推导:将该内存量的 GB 数取最接近的 2 的幂,再乘以 32。 |
raft.max-log-file-size | 600000000000 | 50000000000 | Raft 日志的最大字节数。 |
raft.snapshotInterval | 1800 | 300 | 生成 Raft 快照的时间间隔,单位秒。 |
raft.snapshotLogIndexMargin | 未设置 | 0 | 距上次快照的最小 applied index 差值,达到后才真正生成快照。设为 0 关闭该判断。 |
raft.rpc-timeout | 未设置 | 10000 | Raft RPC 超时时间,单位毫秒。 |
raft.metrics | 未设置 | true | 采集 JRaft 节点指标,可通过 /metrics/raft 读取。 |
raft.useRocksDBSegmentLogStorage | 未设置 | true | 使用 RocksDB 分段日志存储保存 Raft 日志。 |
raft.maxSegmentFileSize | 未设置 | 67108864 | 分段日志文件大小,单位字节(64 MB)。 |
raft.maxReplicatorInflightMsgs | 未设置 | 256 | 每个 follower 的最大在途复制请求数。 |
raft.maxEntriesSize | 未设置 | 256 | 单次 AppendEntries 请求包含的最大条目数。 |
raft.maxBodySize | 未设置 | 524288 | 单次 AppendEntries 请求的最大字节数。 |
ave-logEntry-size-ratio | 未设置 | 0.95 | 估算日志条目平均大小时的平滑系数。注意该配置项位于顶层,不在 raft 下。 |
存储与标签
| 配置项 | 当前主线目录值 | 代码默认值 | 说明 |
|---|---|---|---|
app.data-path | ./storage | store | RocksDB 数据目录。用逗号分隔多个路径可将分区分散到多块磁盘。 |
app.raft-path | 已注释 | 空 | Raft 日志和快照目录。为空时回退到 app.data-path。 |
app.fake-pd | 未设置 | false | 内置 PD 模式,仅用于单机测试,不要用于生产。 |
app.placeholder-size | 未设置 | 10 | 启动时在每个数据路径下创建的 placeholder 占位文件大小,单位 GB,便于紧急情况下释放空间。设为 0 关闭。 |
app.label.<name> | 未设置 | 无 | 随 store 心跳上报给 PD 的自定义键值标签。节点会自动追加 rest.port。 |
RocksDB
| 配置项 | 当前主线目录值 | 代码默认值 | 说明 |
|---|---|---|---|
rocksdb.total_memory_size | 32000000000 | 51539607552 | 本节点所有 RocksDB 实例共享的内存预算。缺失或为 0 时使用 JVM 最大堆内存。 |
rocksdb.write_buffer_size | 32000000 | 33554432 | memtable 大小,单位字节。缺失或为 0 时取 total_memory_size / 1000。 |
rocksdb.min_write_buffer_number_to_merge | 16 | 16 | 落盘前合并的 memtable 数量。 |
rocksdb.write_buffer_ratio | 未设置 | 0.66 | total_memory_size 中分配给写缓存的比例,其余作为 block cache。 |
org/apache/hugegraph/rocksdb/access/RocksDBOptions.java 中定义的其他选项都可以加在同一个 rocksdb: 块下,例如 rocksdb.max_background_jobs、rocksdb.level0_file_num_compaction_trigger 或 rocksdb.bloom_filter_bits_per_key。
线程池
| 配置项 | 代码默认值 | 说明 |
|---|---|---|
thread.pool.grpc.core | 600 | 处理 gRPC 请求的核心线程数。 |
thread.pool.grpc.max | 1000 | gRPC 最大线程数。 |
thread.pool.grpc.queue | 2147483647 | gRPC 任务队列容量。 |
thread.pool.scan.core | 128 | 处理扫描的核心线程数。设为 0 时取 CPU 核数的 4 倍。 |
thread.pool.scan.max | 1000 | 扫描最大线程数。 |
thread.pool.scan.queue | 0 | 扫描任务队列容量。 |
gRPC 回调队列(1.8.0)
Store 使用无界队列处理 gRPC 回调,避免队列满时丢弃取消或完成通知,导致请求无法正常结束。thread.pool.grpc.queue 仍可写在配置中,但不再限制这个队列的容量。
thread.pool.grpc.core 和 thread.pool.grpc.max 仍用于配置线程池。由于回调可以继续排队,积压通常不会触发线程数从 core 增长到 max;只增大 max 无法提高回调处理能力。
持续过载仍会使队列积压并增加内存占用。应限制客户端并发,并根据节点资源调整扫描和查询工作线程池;不要依赖 thread.pool.grpc.queue 限流。1.7.0 仍使用配置的 gRPC 队列容量。
查询下推
| 配置项 | 代码默认值 | 说明 |
|---|---|---|
query.push-down.threads | 1500 | 下推查询的线程池大小。 |
query.push-down.fetch_batch | 20000 | 单次请求拉取的行数。 |
query.push-down.fetch_timeout | 300000 | 拉取超时时间,单位毫秒。 |
query.push-down.memory_limit_count | 50000 | 排序等内存操作的行数上限。 |
query.push-down.index_size_limit_count | 50000 | 索引 sst 文件大小上限,单位 kB。 |
后台任务
| 配置项 | 代码默认值 | 说明 |
|---|---|---|
job.interruptableThreadPool.core | 128 | TTL 清理线程池的核心线程数。设为 0 时取 CPU 核数。 |
job.interruptableThreadPool.max | 256 | TTL 清理线程池的最大线程数。设为 0 时取 CPU 核数的 4 倍。 |
job.interruptableThreadPool.queue | 2147483647 | TTL 清理线程池的队列容量。 |
job.uninterruptibleThreadPool.core | 0 | 存储引擎不可中断任务线程池的核心线程数。设为 0 时取 CPU 核数。 |
job.uninterruptibleThreadPool.max | 256 | 不可中断任务线程池的最大线程数。 |
job.uninterruptibleThreadPool.queue | 2147483647 | 不可中断任务线程池的队列容量。 |
job.cleaner.batch.size | 10000 | TTL 清理任务每批删除的 key 数量。 |
job.start-time | 0 | 每日 TTL 清理执行的小时数(0 到 23)。超出该范围时回退为 19。 |
内置 PD 模式
仅用于单机开发调试,通过 app.fake-pd: true 开启。此时节点自行扮演 PD 角色,并忽略 pdserver.address。
| 配置项 | 代码默认值 | 说明 |
|---|---|---|
fake-pd.store-list | '' | 伪集群中各 Store 节点的 gRPC 地址。 |
fake-pd.peers-list | '' | 同一批节点的 Raft 地址。 |
fake-pd.partition-count | 3 | 分区数量。 |
fake-pd.shard-count | 3 | 每个分区的副本数。 |
诊断
| 配置项 | 代码默认值 | 说明 |
|---|---|---|
arthas.telnetPort | 8566 | 调用 /v1/arthasstart 后 Arthas 的 telnet 端口。 |
arthas.httpPort | 8565 | Arthas HTTP 端口。 |
arthas.ip | 0.0.0.0 | Arthas 监听地址。 |
arthas.disabledCommands | jad | 需要禁用的 Arthas 命令。 |
4.4 各节点需要区分的配置
对于多节点部署,需要为每个 Store 节点修改以下配置:
grpc.host和grpc.port(其他组件访问本节点的地址)raft.address(Raft 协议地址)server.port(REST 端口)app.data-path(数据存储路径)
pdserver.address 在所有节点上保持一致,它列出的是整个 PD 集群。
5 启动与停止
5.1 启动 Store
确保 PD 服务已经启动,然后在 Store 安装目录下执行:
下文的生命周期与下载时限说明适用于包含启动脚本修复的 master 构建;上文下载的 1.7.0 启动脚本不包含这些修复。 启动脚本支持四个参数,GC 的版本限制见下文:
| 参数 | 取值 | 默认值 | 说明 |
|---|---|---|---|
-d | true、false | true | 守护进程模式,见下文。 |
-g | 见下文版本限制 | 未设置 | 选择垃圾回收器;不支持的参数会中止启动。 |
-j | JVM 参数字符串 | 空 | 附加的 JVM 参数,例如 -j "-Xmx16g -Xms8g"。 |
-y | true、false | false | 挂载 OpenTelemetry Java agent(首次使用时下载到 plugins/),并将 trace 导出到 127.0.0.1:4317。 |
master 构建接受 g1、G1、zgc 和 ZGC。
上文下载的 1.7.0 启动脚本仅接受显式指定 zgc 或 ZGC;-g g1、-g G1 和其他参数会中止启动。
默认路径请省略 -g;参数被拒绝时,查看 logs/hugegraph-store-server.log。
守护进程模式:
-d true(默认):以后台守护进程方式运行,脚本立即返回,并把 Java 进程号写入bin/pid。-d false:以前台模式运行,脚本通过exec替换为 Java 进程,容器或进程管理器的进程即为 Java 本身。在 Docker 或进程管理器(systemd、supervisord)下运行时请使用此参数,以便在崩溃时自动检测并重启服务。
JVM 内存方面,如果没有自行设置 JAVA_OPTIONS:-Xms512m,-Xmx 取空闲内存的一半并限制在 512 MB 到 2048 MB 之间。脚本还会加上 -XX:MetaspaceSize=256M、OOM 时把堆转储写入 logs/,以及滚动的 GC 日志 logs/gc.log。生产节点通常需要大得多的堆,请显式指定,例如 -j "-Xmx32g -Xms32g"。
当 ulimit -n 或 ulimit -u 低于 1024 时脚本会拒绝启动;在 x86_64 和 arm64 上,如果能成功下载并校验对应的动态库,脚本会预加载 jemalloc。
主线构建中,每次可选 jemalloc 下载的连接时限为 5 秒,总时限为 30 秒。 1.7.0 的下载 helper 没有连接或总时限。超时或校验失败时沿用已有回退路径,不预加载下载库并继续启动。 校验有效的缓存库仍可复用,失败下载的临时文件会被清理。
启动成功后,可以在 logs/hugegraph-store-server.log 中看到类似以下的日志:
5.2 停止 Store
在 Store 安装目录下执行:
脚本读取 bin/pid,向该进程发送信号,最多等待 30 秒直至进程退出,然后删除 pid 文件。如果 bin/pid 不存在,脚本直接退出且不做任何操作。
5.3 重启 Store
该脚本依次 source 停止脚本和启动脚本,并转发 5.1 中的参数。
5.4 启动顺序
- 先启动全部 PD 节点。每个 Store 的
grpc.host:grpc.port都应出现在 PD 的pd.initial-store-list中,否则 PD 只会把该节点登记为Pending而不会置为Up,分区分配也就无法完成。当前主线应先对每个 PD 检查/v1/ready返回 HTTP200且ready:true;/v1/health只是存活检查。 - 再启动 Store。Store 早于 PD 启动并不致命:心跳线程会持续重试注册,并在 PD 可用之前打印
store heartbeat error: PD UNREACHABLE。 - 最后启动 HugeGraph-Server,此时所有 Store 节点都应上报
state: "Up"。Server 需要分区就绪之后才能初始化或打开图。
主线 Compose 用 depends_on: condition: service_healthy 等待本地健康检查,但 PD 和 Store 的 Docker 健康检查都只访问 /v1/health,不能证明 Raft 多数派或 Store 注册已就绪。Server entrypoint 会等待 PD 至少报告一个 Up 的 Store;运维时仍应检查 PD /v1/ready 和 /v1/stores。
6 多节点部署示例
以下是一个三节点部署的配置示例:
6.1 三节点配置参考
- 3 PD 节点
- raft 端口:8610, 8611, 8612
- rpc 端口:8686, 8687, 8688
- rest 端口:8620, 8621, 8622
- 3 Store 节点
- raft 端口:8510, 8511, 8512
- rpc 端口:8500, 8501, 8502
- rest 端口:8520, 8521, 8522
6.2 Store 节点配置
对于三个 Store 节点,每个节点的主要配置差异如下:
节点 A:
节点 B:
节点 C:
所有节点都应该指向相同的 PD 集群:
同时每个 PD 节点都应列出三个 Store 的 gRPC 地址:
6.3 Docker 分布式集群配置
3 节点 Store 集群包含在 docker/docker-compose-3pd-3store-3server.yml 中。每个 Store 节点拥有独立的主机名和环境变量:
每个节点的容器内端口都是 8500/8510/8520,只有映射到宿主机的端口不同。PD 节点相应地设置 HG_PD_INITIAL_STORE_LIST: store0:8500,store1:8500,store2:8500。
Store 节点仅在所有 PD 节点通过健康检查后才会启动,其中 docker-compose 中的 healthcheck 实际访问的是 PD 的 REST 接口 /v1/health(也可以通过 Actuator 暴露的 /actuator/health 进行手动检查),并通过 depends_on: condition: service_healthy 强制执行依赖关系。
运行时日志可通过 docker logs <container-name>(如 docker logs hg-store0)直接查看,无需进入容器。
完整的部署指南请参阅 docker/README.md。
7 验证 Store 服务
确认 Store 服务是否正常运行:
如果返回 {"status":"UP"},表示 Store 本地应用健康检查通过;它本身不证明已在 PD 注册为 Up。
GET /v1/health 是 Docker 镜像和 compose 文件使用的轻量检查接口,它返回 HTTP 200 且响应体为空,因此应使用 curl -fsS 并检查退出码,而不是检查输出内容:
7.1 Store REST 接口
Store 节点在 server.port 上提供以下只读接口:
| 方法 | 路径 | 描述 |
|---|---|---|
| GET | /v1/health | 存活探测,HTTP 200 且响应体为空 |
| GET | /actuator/health | Spring Boot Actuator 健康检查,返回 {"status":"UP"} |
| GET | /actuator/prometheus | Prometheus 抓取接口 |
| GET | / | 节点概览,包含 leaderCount 和 partitionCount |
| GET | /-/state | 运维设置的节点状态标志,取值为 STARTING、ONLINE、STOPPING;此标志不表示 PD 注册状态 |
| GET | /-/echo?name=<text> | 回显检查 |
| GET | /-/scan | 当前扫描流的状态 |
| GET | /v1/partitions | 本节点上的所有 Raft 组及分区指标。加上 ?flags=accurate 可获取精确的 key 数量,但更慢。 |
| GET | /v1/partition/{id} | 按分区 id 查询单个 Raft 组,包含角色、leader、peers 和已提交索引 |
| GET | /metrics/system | 主机 CPU 和内存指标 |
| GET | /metrics/drive | 数据路径所在磁盘的指标 |
| GET | /metrics/raft | JRaft 节点指标,需要 raft.metrics: true |
主线发行目录的 Store 配置将 management.endpoints.web.exposure.include 设为 "*",并启用 Prometheus;Actuator 端点没有 PD REST Basic 认证保护,请限制 Store REST 端口的网络可达范围。
节点还提供一批会修改状态或执行重负载操作的运维接口:PUT /-/state、GET /-/cleaner、GET /v1/partition/dump/{id}、GET /v1/partition/clean/{id}、POST /v1/compat?id=<partition>、GET /v1/arthasstart、POST /raft/options,以及 /fix/* 和 /test/* 两组接口。请仅在排查问题时使用,并且不要把 REST 端口暴露到不可信网络。
7.2 通过 PD 检查注册结果
也可以通过 PD API 查看集群中的 Store 节点状态:
对于当前主线源码构建包,PD REST 用户名必须是 hg、store、hubble、vermeer 之一,密码必须与 PD 的 auth.secret-key 相同;HG_PD_AUTH_SECRET_KEY 会同时配置 Compose 中的 PD 和 Server。/v1/health、/v1/ready、/actuator/* 和 /v1/prom/targets/* 不需要认证。1.7.0 发布标签的实现只校验用户名,不比较密码;不要把这一旧行为用于主线源码构建包。
如果 Store 配置成功,上述接口响应中应包含当前节点的状态信息,其中 state 为 Up 表示节点运行正常。如果节点长期停留在 Pending,通常是因为它没有出现在 PD 的 pd.initial-store-list 中。
下方示例仅展示 1 个 Store 节点的返回结果。如果 3 个节点都已正确配置并正在运行,则响应中的 storeId 列表应包含 3 个 ID,且 stateCountMap.Up、numOfService 和 numOfNormalService 都应为 3。
7.3 最小图读写验证
确认 Store 已在 PD 中显示为 Up 后,再启动配置为 HStore 后端、连接同一 PD 集群的 Server。Server 配置步骤见 Server 快速上手。确认 GET /versions 可访问且默认图 hugegraph 已加载后,可以创建一个属性键、顶点标签和顶点,再读取该顶点:
最后一个响应应包含顶点 ID pd-store-demo-1 和属性 pd_store_demo_name。若 Server 开启了认证,以上请求还需按其认证配置增加凭据。
4 - 使用 Helm 部署 HugeGraph
本文适用于 HugeGraph 1.8.0 及以后版本,需要支持 OCI 的 Helm 3.10+ 和 Kubernetes (K8s) 1.23+。
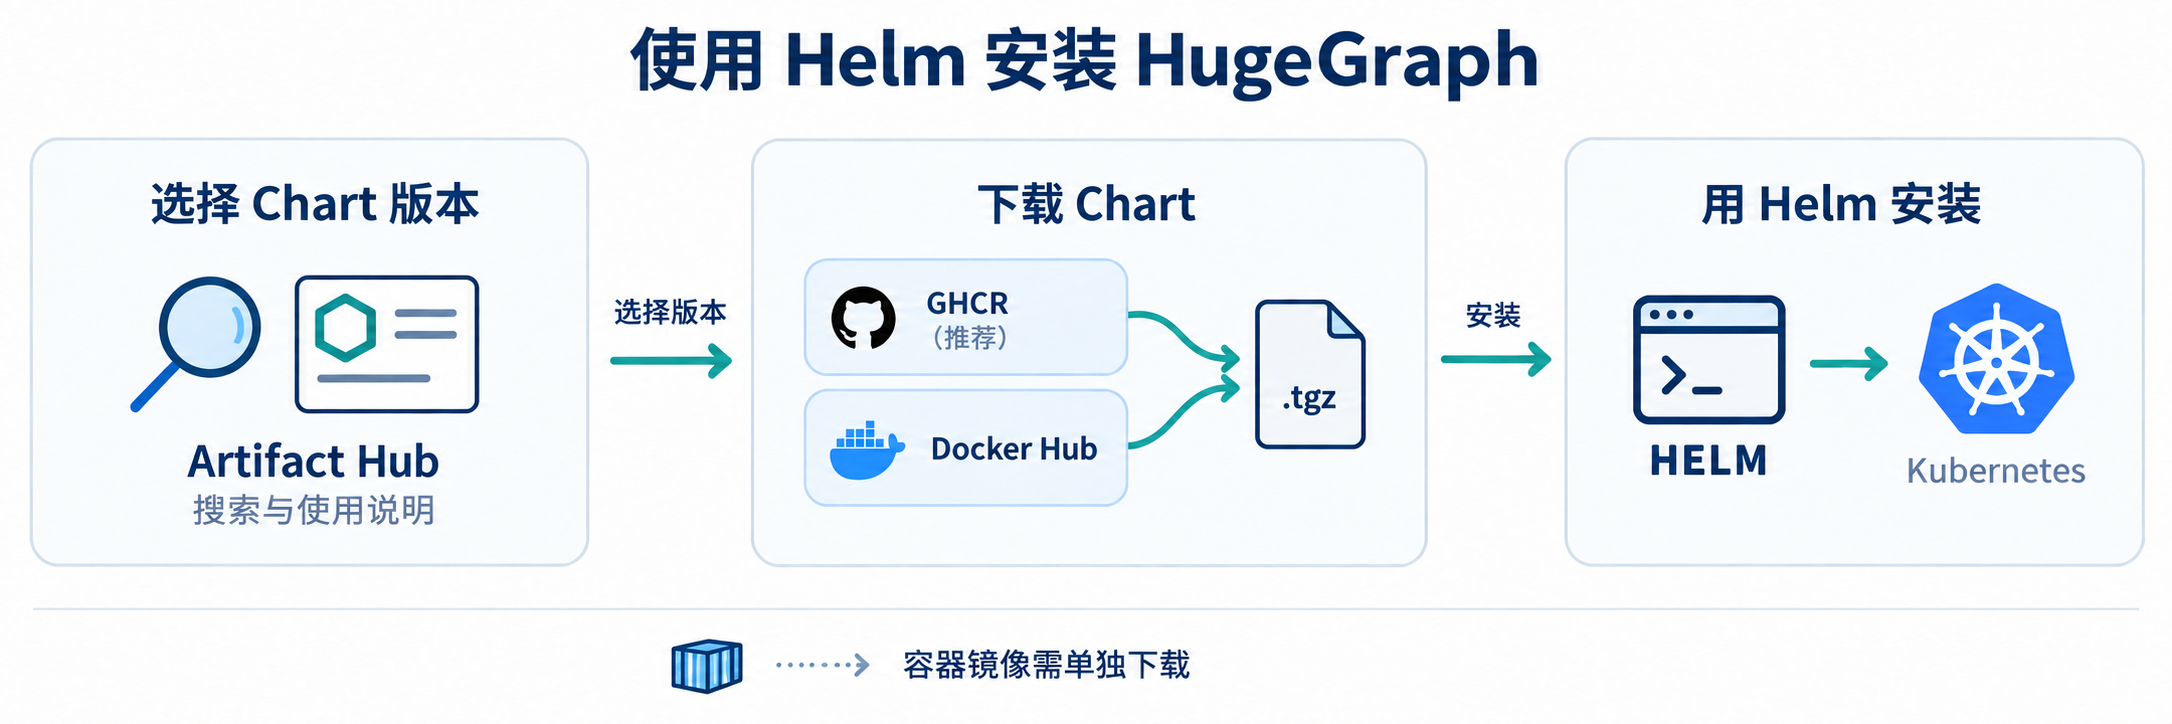
可从 GHCR 或 Docker Hub 安装 hugegraph-helm。Chart 与 HugeGraph 服务分别维护版本,例如 0.2.x 的 Chart 可以部署 1.8.x 的服务。
当前开发 Chart 使用 latest 镜像,适合测试。
对应 HugeGraph 服务正式发布后,生产环境请选择稳定 Chart,并检查其中的镜像版本。
镜像标签可能变化;需要固定镜像内容时,请配置各组件的 image.digest。
Artifact Hub 方便查找 Chart、查看版本和安装说明,实际安装包仍从 GHCR 或 Docker Hub 下载。 参数和源码开发方式见 chart README, 生命周期操作见 运维参考。
1 安装
默认部署规格与存储要求
- 拓扑组成:默认部署 3 PD + 3 Store + 3 Server 与 1 Hubble,默认开启鉴权与持久化存储。
- 存储依赖:需要集群具备默认动态 StorageClass 或预先匹配的静态 local PV,共需 7 个持久卷(3 个 10 GiB PD 卷、3 个 50 GiB Store 卷、1 个 1 GiB Hubble 卷)。
- 内存考量:保留镜像内 JVM 内存自动推导;按需调整 resource requests/limits,确保宿主机给 9 个图服务 JVM 与 Hubble 提供足够内存。
选择一个下载源即可,公共 CI 推荐 GHCR。本地轻量测试可直接使用单节点预设。
--devel 按版本号选择最新 Chart,包含开发版和稳定版,不限于某个版本系列。
生产部署或需要复现时,将 --devel 换成 --version <已发布版本>,固定你选定的版本。
单节点试用预设替代默认安装,将各组件设为 1 副本并放宽调度限制,适合资源受限环境。
2 模式和访问入口
解压后目录为 hugegraph-helm/,源码目录仍为 helm/hugegraph/。
HugeGraph Helm 核心文件与结构
- hugegraph-helm/
- Chart.yamlChart 元数据与版本定义
- values.yaml默认配置(easy 模式:3 PD + 3 Store + 3 Server + 1 Hubble,NodePort 入口)
- values-single.yaml单节点预设(本地 Minikube/Kind 测试,1 副本且关闭反亲和与 PDB)
- values-cluster.yaml生产集群预设(跨节点反亲和调度,Store 采用 OnDelete 逐个滚动升级)
- values-strict.yaml安全加固预设(strict 模式:全部 ClusterIP,强制启用 NetworkPolicy 隔离)
- values.schema.jsonvalues 配置参数校验规范
- templates/Kubernetes 资源编排模板
- pd-statefulset.yamlPD 服务有状态副本集(元数据与调度中心)
- store-statefulset.yamlStore 存储节点有状态副本集(分布式存储引擎)
- server-deployment.yamlServer 引擎无状态 Deployment(注入 serviceId / graphSpace)
- hubble-deployment.yaml可视化控制台 Deployment
- tests/冒烟验证测试钩子(helm test,支持自定义 testGraphAlias)
- examples/7 种生产场景完整示例(含 local PV、GitOps 凭据、Ingress 等)
- docs/operations.md生命周期进阶运维与故障恢复手册
默认 mode: easy,Server 和 Hubble 自动分配 NodePort,PD 保持 ClusterIP。可以直接使用 HTTP,无需域名、证书或额外确认参数。
mode: strict 默认将 Server/Hubble 设为 ClusterIP,并开启 NetworkPolicy。两个模式都保留鉴权和持久化。
优先级是组件显式参数高于全局参数,全局参数高于模式默认值,显式 false 也会生效。
全局参数包括 persistence.enabled 和 global.imageRegistry,严格预设为 values-strict.yaml。
| 入口 | 访问方式 | 前提 |
|---|---|---|
| NodePort | http://<可达节点IP>:<分配的NodePort> | 节点网络可达且防火墙放行,无需额外控制器 |
| ClusterIP | 集群内虚拟 Service IP/DNS,如 hugegraph-server.hugegraph.svc:8080 | 集群外通过 port-forward 或已有网关访问 |
| LoadBalancer | 基础设施分配的地址 | 集群有对应负载均衡控制器 |
| Ingress | 通过控制器路由 HTTP 请求 | 已安装 Ingress 控制器,域名和 TLS 都可选 |
使用 Hubble 的 NodePort 打开页面,以 admin 和查出的密码登录。
默认 externalTrafficPolicy: Cluster 下,访问的节点不必运行目标 Pod。ClusterIP 是集群内部的虚拟服务地址,不是节点 IP,普通笔记本通常不能直接访问。
也可以运行 kubectl -n hugegraph port-forward svc/hugegraph-hubble 8088:8088,在本机打开 http://127.0.0.1:8088。
三个客户端 Service 都支持 externalTrafficPolicy、loadBalancerClass、loadBalancerIP、loadBalancerSourceRanges、externalIPs
和 allocateLoadBalancerNodePorts,具体行为取决于集群及负载均衡实现。LoadBalancer 专用字段应配合对应类型使用。
NodePort 省略或设为 0 时自动分配,固定端口由 Kubernetes 根据集群配置的范围校验,chart 不再强制 30000–32767。
原 HTTP 暴露确认参数保留兼容,但不再阻止渲染。
服务身份与图空间
默认 server.serviceId 与 server.graphSpace 均为 DEFAULT。如需将 Server 注册到指定的业务服务名或图空间,可通过 values 指定:
仅修改已有部署的配置时,保留当前 Chart 版本和 values。用 helm list 查看版本,替换下面的版本占位符:
注意:非默认图空间必须在启动 Server 前先调用 PD API 创建;server.testGraphAlias 用于指定 helm test 验证的 Gremlin 图别名(区分大小写),
不会从 graphSpace 自动推导。请勿在 server.extraEnv 中重复声明服务 ID 或图空间。
3 内网镜像和存储
完整例子包含内网镜像、动态存储、七个 local PV、 GitOps 凭据、仅 API 部署以及无域名的 HTTP Ingress。
global.imageRegistry 为未指定 registry 的镜像仓库加前缀,组件指定完整 registry 地址时优先采用组件配置。
默认只需镜像仓库中的 hugegraph/pd、hugegraph/store、hugegraph/server 和 hugegraph/hubble 四个镜像,标签或 digest 按实际配置选取。
等待 PD 的 init container 复用 Store 镜像,Helm test 复用 Server 镜像。这两个镜像已包含 curl,无需额外 curl 镜像或启动时安装软件。
自定义镜像可以继续使用显式 store.waitImage 和 server.waitImage 覆盖。
存储配置
storageClassName 为空时继承集群默认 StorageClass,"-" 表示显式不使用 StorageClass。
local PV 需要预建宿主机目录、匹配容量、nodeAffinity 和 kubernetes.io/no-provisioner StorageClass。
WaitForFirstConsumer 根据 Pod 调度约束绑定,创建资源前请查看七个卷的完整例子。
新建临时实例可以设置 persistence.enabled=false 使用 emptyDir,组件存储开关优先。
PVC 失败不会自动降级为临时存储,已经初始化的 PD/Store 切换存储模式会被拒绝。
离线安装和私库
先选择最新版本,再按该版本下载 Chart,将 .tgz 搬入内网。可以直接安装,也可以接入已有的 OCI 或 HTTP 私库。
内网安装需通过 --set global.imageRegistry=... 覆盖镜像私库,
参见 values-internal-registry.yaml。
私库地址请替换为实际地址。Chart 包不包含容器镜像;完整离线部署还需搬运配置引用的所有容器镜像,并覆盖镜像地址。
4 鉴权和 Secret
普通 Helm 安装自动生成、复用三份凭据,分别为 <release>-admin 的 password、<release>-auth-token 的 token_secret
以及 <release>-pd-auth 的 secret-key。PD REST 使用共享的 PD Secret,通过 HG_PD_AUTH_SECRET_KEY 注入 PD 容器,
Server 等待存储和 Hubble 使用同一份凭据,不需要用户为每个 PD Pod 单独发明密码。
GitOps 使用加密的固定值,或预先创建 Secret 并配置 pd.auth.existingSecret、server.auth.admin.existingSecret
和 server.auth.token.existingSecret。existingSecret 高于内联值,chart 不管理这类外部 Secret。
管理员密码需要可打印 ASCII,不能包含空格、冒号、反斜杠;PD 密码需要可打印 ASCII,不能包含首尾空白和反斜杠;JWT key 至少 32 字节。
离线渲染器不能通过 lookup 读取在线已生成 Secret,因此不能依赖每次渲染随机生成凭据。
管理员 Secret 是初始凭据,更新 Secret 不会修改已经创建的账户密码。
先使用旧密码调用 PUT /graphspaces/DEFAULT/auth/users/admin,请求体为 {"user_password":"<新密码>"},
再把 Secret 和源配置同步为新密码,最后重启 Server Deployment 清理所有副本的鉴权缓存。
Hubble 默认开启,当前镜像的登录仍依赖 Server 鉴权。只使用 API 可以设置 hubble.enabled=false,
如需关闭 API 鉴权,再设置 server.auth.enabled=false。未使用的凭据配置可以留在 values 中。
5 升级和验证
使用 Helm 原生值复用保留已有部署的 UI、入口、存储和凭据设置。
已有配置中的显式 helper 镜像也会保留。添加 --set-string store.waitImage= --set-string server.waitImage= 可清空覆盖并复用组件镜像。
要采用新的默认值,先审阅已有配置,再使用 --reset-values 和保留镜像、凭据、存储、拓扑设置的配置文件。
PD 成员、持久存储和共享凭据变更需要按生命周期说明协调处理。
server.storageWaitTimeoutSeconds 默认 300,通过 WAIT_STORAGE_TIMEOUT_S 传给启动脚本。
未指定的启动探针阈值按存储等待加 150 秒推导;显式探针不会被改写,但预算必须覆盖存储等待和至少 120 秒 Server 启动时间。
矛盾预算会在渲染时报出对应参数。这个等待超时不是 JVM 内存配置。
默认 helm test hook 检查连接和读取。安装或恢复后,还应重新登录 UI,并验证应用实际使用的读写查询。
调度、NetworkPolicy、滚动升级和恢复见 Kubernetes 运维。
5 - HugeGraph Kubernetes 运维
本文配合 Helm 部署使用。生命周期检查和恢复说明见
运维参考,所有参数说明见 chart 的 values.yaml。
命令假设 release 和 namespace 都是 hugegraph,覆盖名称时请替换实际工作负载名。
1 存储和内网镜像
默认安装需要七个持久卷。动态存储需要正常的 provisioner,静态 local 存储需要预建目录和绑定节点的匹配 PV。
完整例子包含七个 local PV、WaitForFirstConsumer、镜像仓库和 GitOps Secret。
WaitForFirstConsumer 的 PVC 初期 Pending 可以是正常等待;持续 Pending 应检查 PVC/Pod 事件和 PV 匹配。
PVC 已绑定但目录不存在或权限不匹配时可能挂载失败,不能把故障 PVC 静默替换成临时目录。
出现 ImagePullBackOff 时检查 Pod 事件、仓库连通性和拉取凭据。默认只需四个组件镜像,等待 Store/Helm test 复用已包含 curl 的组件镜像。
如显式覆盖 helper 镜像,该镜像也需要同步到内网仓库。
2 端口和健康检查
PD 端口为 REST 8620、gRPC 8686、Raft 8610;Store 为 REST 8520、gRPC 8500、Raft 8510;Server HTTP 为 8080;Hubble HTTP 为 8088。
客户端 Service 隐藏 Pod 地址,NodePort 是节点上另外分配的端口,与应用监听端口不同。
PD /v1/ready 需要 Raft leader,/v1/health 只说明监听器已启动,Store 等待多数 PD peer ready 后启动。
Server 等待存储的默认上限为 300 秒,可以用 server.storageWaitTimeoutSeconds 调整。
本地模板渲染不能验证集群连通性、卷挂载或 JVM 运行容量。
Helm test 检查范围
helm test 逐 Server Pod 检查图绑定(默认检查 DEFAULT-hugegraph,可通过 server.testGraphAlias 指定图别名),并要求当前可见关联索引处于 CREATED 状态。
请在索引创建/重建任务结束后执行,检查期间不要并发修改 schema。
在 HStore 上,读取尚未完成的索引可能将临时状态缓存到其他 Pod;重试不会刷新该状态。
即使任务随后成功,这些 Pod 的索引查询也可能继续失败;应在任务结束后再替换受影响的 Server Pod。
hook 不修复跨 Server 的 schema 缓存一致性。内部 150 秒重试窗口用于等待短暂选举等状态恢复,
Helm 的 --timeout 不会修改这个窗口。
它按 ID 读取索引,不刷新全量索引缓存;不证明索引查询结果或完整 schema 一致性。
对已有数据,可在 Helm 升级时用 --set-file server.testGremlin=assertions.groovy 添加逐 Pod 的只读业务断言。
脚本必须用 assert 或抛异常表示结果不符,仅返回 false 不会让请求失败。
业务查询断言
给出了示例与检查边界。未配置脚本时明确显示业务断言已跳过,默认 hook 不创建 schema 或数据。
自定义脚本使用 hook 的 Server 凭据执行(开启鉴权时为 admin),不强制只读;请提供可信的只读断言。
Server API 根据 Accept-Encoding 协商响应压缩。支持 gzip 的客户端可请求 gzip 或使用 curl --compressed;
identity 或未请求压缩时返回未压缩内容。需从更新后的源码重新构建 Server 镜像才能包含该行为,仅更新 chart 不会改变现有镜像。
PD REST 鉴权
PD REST 使用 HTTP Basic 鉴权,hg、store、hubble 和 vermeer 共用 PD REST Secret 密码。
Server 的 admin 不是 PD REST 账户,使用它会返回 401。默认 release/Secret 的查询示例,地址应为可达的 PD REST 地址:
以上 HTTP 示例适用于可信内网。其他访问路径可使用 HTTPS 网关,或按需执行
kubectl -n hugegraph port-forward service/hugegraph-pd-client 8620:8620,再访问 http://127.0.0.1:8620。
使用 pd.auth.existingSecret 或自定义 pd.auth.key 时读取实际 Secret 和 key,不使用 Server 管理员密码。
变量式示例避免将密码字面值写入 shell 历史,但展开后的凭据可能短暂出现在进程参数中。
共享终端可选用 curl --user hg 提示输入密码,或权限为 600 的私有 curl 配置文件;
凭据操作说明
也包含改密请求体的处理方式。不要记录或提交凭据文件。
3 调度
默认 preferred 反亲和允许节点少于副本数时调度;values-cluster.yaml 对 PD/Store 设置 required 反亲和,因此需要至少三个可调度节点。
显式 affinity 优先于预设。local PV 节点亲和必须匹配工作负载位置约束,PV 容量声明不等于文件系统配额。
持久化 PD/Store 的 Raft 主机名和端口会记录为成员身份,不能作为普通配置随意变更。
4 分区副本
首次初始化时,Store 至少三个则默认每个分区三副本,否则一副本。 PD 会持久化分区设置,初始化后修改 chart 值不会覆盖已有元数据,应使用 PD 配置 API 并协调分区巡检。 显式 shard 数必须为奇数且不超过 Store 数,操作在线集群前先核对 拓扑约束;chart 不负责迁移已有 shard 元数据。
5 NetworkPolicy
easy 模式及普通集群预设默认关闭,strict 模式默认开启;显式 networkPolicy.enabled 在任何模式都优先。
集群网络插件必须支持策略执行,才有实际隔离效果。
生成策略允许组件间通信和 DNS,外部客户端、Ingress 控制器需要适当的 networkPolicy.<component>.extraIngress,
外部发现地址可能还需要 extraEgress。空列表合法但可能阻止外部访问;支持 Kubernetes 原生规则,包括允许全部的 {},不要求额外来源确认。
按实际来源地址或 selector 配置,并考虑 NodePort SNAT 和控制器行为。
6 逐个升级 Store
集群预设使用 store.updateStrategy.type=OnDelete 便于维护时控制逐个替换。
每次只删除一个 Store Pod,下一次删除前确认上一个 Pod Ready、Store 心跳新鲜,并从 PD leader 查询每个 shard group 都有完整成员及唯一 leader。
PD 的 Up 状态本身不证明 shard 恢复完成。PDB 限制主动驱逐,不限制 StatefulSet 控制器更新。
发现缺成员或无 leader 时停止继续替换。
运维参考说明这些升级条件,
但不提供完整的逐组诊断或丢盘恢复步骤。
即使副本完整,替换单个 Store 时,Raft leader 和客户端路由收敛期间仍可能出现请求失败或超时,不保证零错误。 继续维护前同时观察应用错误和 shard 恢复状态,不要盲目重试写请求。
PD 巡检和 leader 均衡
分区巡检修复 shard 成员关系;leader 均衡是单独的手动任务,不会自动定时执行。
执行前通过鉴权的 /v1/members 查询 data.pdLeader.restUrl,并确认该 PD 的 /v1/ready 返回 isLeader: true。
GET 任务 /v1/task/patrolPartitions 和 /v1/task/balanceLeaders 会改变集群状态,应携带 PD REST 凭据请求已确认的 leader。
成员恢复和 split/move 任务完成后才能执行 leader 均衡;Store 心跳需新鲜,各组成员需完整、健康。
忙碌任务返回 body status: 1001。follower 可能返回空成功,leader 转移是异步的,HTTP 200 或转移计划不代表执行完成。
继续维护前重新检查 /v1/partitions、/v1/stores 和应用错误。
任务操作步骤
说明巡检和均衡的独立操作;维护忙碌时不要循环请求任务。
7 灾难恢复
保留原卷、claim 身份和 PD 成员关系,不通过删除 RocksDB lock 文件恢复,也不把持久化成员配置替换为全新的节点。 Store 丢盘后,新建空 PVC 并不能恢复原有数据。 local 磁盘不能在节点故障时自动迁移文件。备份应放在这些 PV 之外,并单独验证恢复;chart 不提供自动备份和自动恢复。 恢复说明列出恢复约束,不是完整的恢复操作顺序。 破坏性变更前,应结合部署版本、剩余副本或备份制定并验证恢复方案。
8 扩缩容
Server 副本可以常规变更,HPA 还需要 CPU requests。Store 扩容需要协调存储和 shard。
PD 扩缩容及 Store 缩容不能仅修改副本数,需要先更新持久化 Raft/shard 成员关系。
chart 对已初始化 StatefulSet 检查不支持的身份和成员变更,首次安装不执行升级专用查询。
按生命周期流程扩缩容,避免直接 kubectl scale 使 Hubble 的 Store metrics 配置过期。
9 集群外的 Hubble
direct 模式只需要可达的 Server URL;PD discovery 还需要集群外可达的 PD gRPC,PD 注册的 Server 地址也必须可达。
必要时用 server.advertiseUrl 注册共享 Server 地址,这会影响所有 discovery 客户端,包括集群内 Hubble。
chart 内置 Hubble 已配置内部服务发现,不需要公开 PD 入口。
HTTP 可以直接使用,TLS 终止可选。Hubble 仍是单副本,当前登录依赖 Server 鉴权。
10 Gremlin 报 Could not rebind
PD 滚动更新期间,Server 可能 Ready、能响应 REST,但 Gremlin binding 失败。
执行 helm test hugegraph -n hugegraph --logs --timeout 5m 检查每个 Server Pod 的鉴权图查询;PD 稳定后替换失败 Pod 并再次验证。
只查询 /versions 不证明图绑定成功,还应检查 Hubble 新登录和图查询。
出现 ERROR: missing required env 'HG_PD_AUTH_SECRET_KEY' 时,检查 PD Pod 的 Secret 引用和对应 key,不要把 Secret 值输出到日志。
chart 正常情况下自动注入共享 PD REST 凭据,自定义容器或 manifest 必须向 PD 和客户端提供同一值。
GitOps 先创建外部 Secret 再调谐工作负载,普通 Helm 保留自动创建的 release Secret。