这是本节的多页打印视图。 .
图导入
需要把文件、数据库或消息数据写入 HugeGraph 时,从这里选择工具。直接导入可使用 Loader;已有 Source、Transform、Sink 管道时使用 SeaTunnel Sink;Spark 作业可使用 Spark Connector。
1 - 使用 SeaTunnel Sink 导入图数据
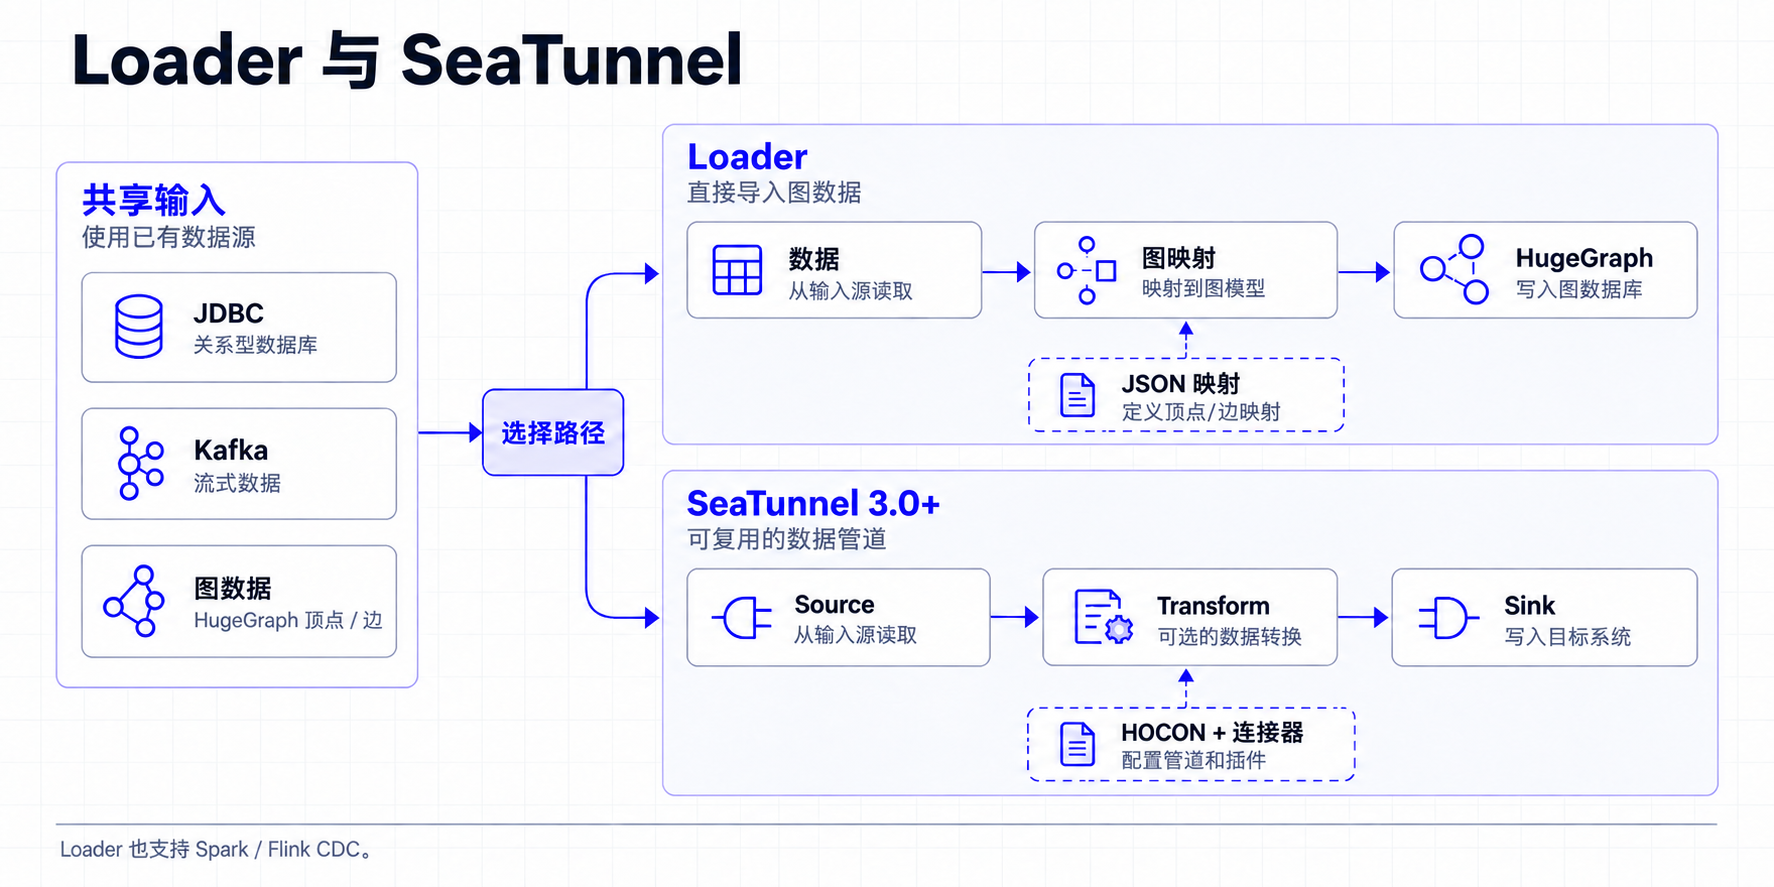
SeaTunnel 可以把数据库、Kafka 等数据源接入 HugeGraph。连接器分为两部分:Source 负责读取,Sink 负责写入[1][2],中间可以接 SeaTunnel 的数据转换组件。需要从 HugeGraph 导出或迁移数据时,请查看SeaTunnel Source 导出与迁移文档。
版本要求:本文面向 SeaTunnel 3.0+。 所有示例使用
mappings
点击配图可查看原图。
1 与 Loader 和 Tools 的区别
HugeGraph-Loader 适合把常见数据直接导入 HugeGraph;HugeGraph-Tools 主要用于单机图管理、备份和导出;SeaTunnel 则把任务组织成 Source → Transform → Sink,适合复用已有的连接器、转换步骤和数据处理管道。
表格标记
✅ 原生支持;⚠️ 有条件支持,或需要额外组件/外部平台;❌ 不提供该能力
| 对比点 | Loader | Tools | SeaTunnel |
|---|---|---|---|
| 任务覆盖 | ✅ 直接导入图数据 | ✅ 备份、恢复和导出 | ✅ 导入、导出与迁移,可组合 Source、Transform、Sink |
| 任务配置 | JSON 映射文件,描述输入源、顶点和边 | 命令行参数和运维命令 | HOCON 作业文件[3],组合 Source、Transform 和 Sink |
| 默认部署 | ✅ 单机 CLI;⚠️ 可借助 Spark Loader 扩展 | ✅ 单机 CLI | ✅ 单机;✅ 分布式 |
| 执行引擎 | ⚠️ 以 CLI 为主,Spark Loader 是独立扩展 | ❌ 不提供 Spark/Flink 执行引擎 | ✅ HugeGraph Source/Sink 支持 Zeta、Spark、Flink[1][2][7][8][9][10] |
| 前端与可观测性 | ❌ 无内置前端,查看 CLI 日志 | ❌ 无内置前端,查看 CLI 日志 | ✅ 内置 Web UI 作业面板,方便查看任务状态和运行情况 |
| 输入与输出 | ⚠️ 围绕图导入,支持常见文件、JDBC、Kafka 等 | ⚠️ 围绕图数据和备份文件,支持常见存储 | ✅ 数十种连接器,含 JDBC、Kafka、SQL-CDC 等 |
| 调度与资源管理 | ❌ 无统一的跨任务调度和资源分配机制 | ❌ 无统一的跨任务调度和资源分配机制 | ⚠️ 可结合 DolphinScheduler 做调度和任务管理 |
| 易用性 | ✅ 专注导入,配置简单;后续提供二进制 CLI 后更方便快速使用 | ✅ 命令直接,适合单机运维 | ⚠️ 配置和运行组件较多,适合长期数据管道 |
| 高性能导入 | ✅ 支持 bypass-server 等优化;特定后端和硬件条件下,实测峰值可达 100~200 万条/秒,需按实际场景压测 | ⚠️ 重点是备份和导出,不以批量导入吞吐为主要目标 | ✅ 依靠并行度、分布式引擎和连接器扩展吞吐 |
SeaTunnel 覆盖 Loader 的图导入和 Tools 的导出、迁移场景,可以把两类任务放进同一条可扩展管道,还支持 SQL-CDC 和数十种输入输出类型。默认情况下,Loader 和 Tools 都在单机运行;SeaTunnel 同时支持单机和分布式部署,可随着数据量和任务数量扩展。Tools 的 schedule-backup 可以创建 crontab 任务,但它不负责统一的任务编排和资源管理。
已有 Spark/Flink 每日任务
HugeGraph Source 和 Sink 在 SeaTunnel 3.0.0-release 中都支持 SeaTunnel Engine(Zeta)、Spark 和 Flink。若把每日任务改成 SeaTunnel 作业,并用对应引擎提交,数据可以在 Source → Transform → Sink 之间直接传递,不需要先落盘再交给 Loader。若保留现有 Spark/Flink DAG,SeaTunnel 不会自动接管内存中的 DataFrame 或 Stream,需要改造成 SeaTunnel 作业,或让 Source 读取已有系统中的数据
Loader 和 Tools 的优势是专注、直接、上手快。需要直接导入图数据时可先用 Loader;需要备份、恢复、导出或日常运维时可用 Tools。如果已经有 SeaTunnel 作业,通常在原管道中接入 HugeGraph 更方便。需要更高导入吞吐时,Loader 的 bypass-server 和其他导入优化更合适;Loader 在特定后端、数据规模和硬件条件下实测峰值可达 100~200 万条/秒,不能直接当作通用性能承诺,仍需单独压测。新建 SeaTunnel 任务使用 3.0+ 和 mappings。使用其他版本时,请重新核对连接器配置。
2 准备环境
2.1 获取 SeaTunnel 3.0+
SeaTunnel 3.0+ 官方开发文档列出 JDK 8 和 JDK 11;本文统一使用 JDK 11,并设置 JAVA_HOME。从 SeaTunnel 3.0+[4] 获取源码,按上游开发环境文档[5]构建发行包:
解压 seatunnel-dist/target/ 中生成的二进制包,后续命令都在解压后的 SeaTunnel 安装目录执行。需要更新功能时,可以切换到其他版本;引擎与连接器插件应来自同一次构建,避免混用不同版本的 JAR。
本文使用 SeaTunnel 自带的 Zeta 引擎和 local 模式[6][7]。确认安装目录的 connectors/ 中包含 HugeGraph,以及所需的 JDBC 或 Kafka 连接器[11][12];如果自定义构建没有包含它们,需补齐同一次构建产出的插件。JDBC 示例还需要将 MySQL 驱动 JAR 放入 lib/,驱动类为 com.mysql.cj.jdbc.Driver。
2.2 准备 HugeGraph 和数据源
先启动 HugeGraph Server,创建可用于测试的图。本文示例使用 hugegraph 图、DEFAULT 图空间,请按服务端实际配置修改;图空间名称区分大小写。启用了身份验证时,在 HugeGraph Source 和 Sink 中填写 username、password。
下面的图模型贯穿 JDBC 和 Kafka 示例。mappings 默认会创建缺失的 PropertyKey、VertexLabel 和 EdgeLabel;已有图模型必须与配置兼容。
| 图元素 | 名称与属性 |
|---|---|
| 属性 | name 为 Text,age 和 since 为 Int |
| 顶点 | person,主键为 name,属性为 name、age |
| 边 | knows,从 person 指向 person,属性为 since |
所有示例中的 mysql、kafka、hugegraph 都是占位主机名,需替换为 SeaTunnel 运行环境可访问的地址。容器中的 127.0.0.1 指向容器自身;同一 Docker 网络可使用服务名。host 只填主机名或 IP,端口单独填写。
3 从关系库导入(sql2graph)
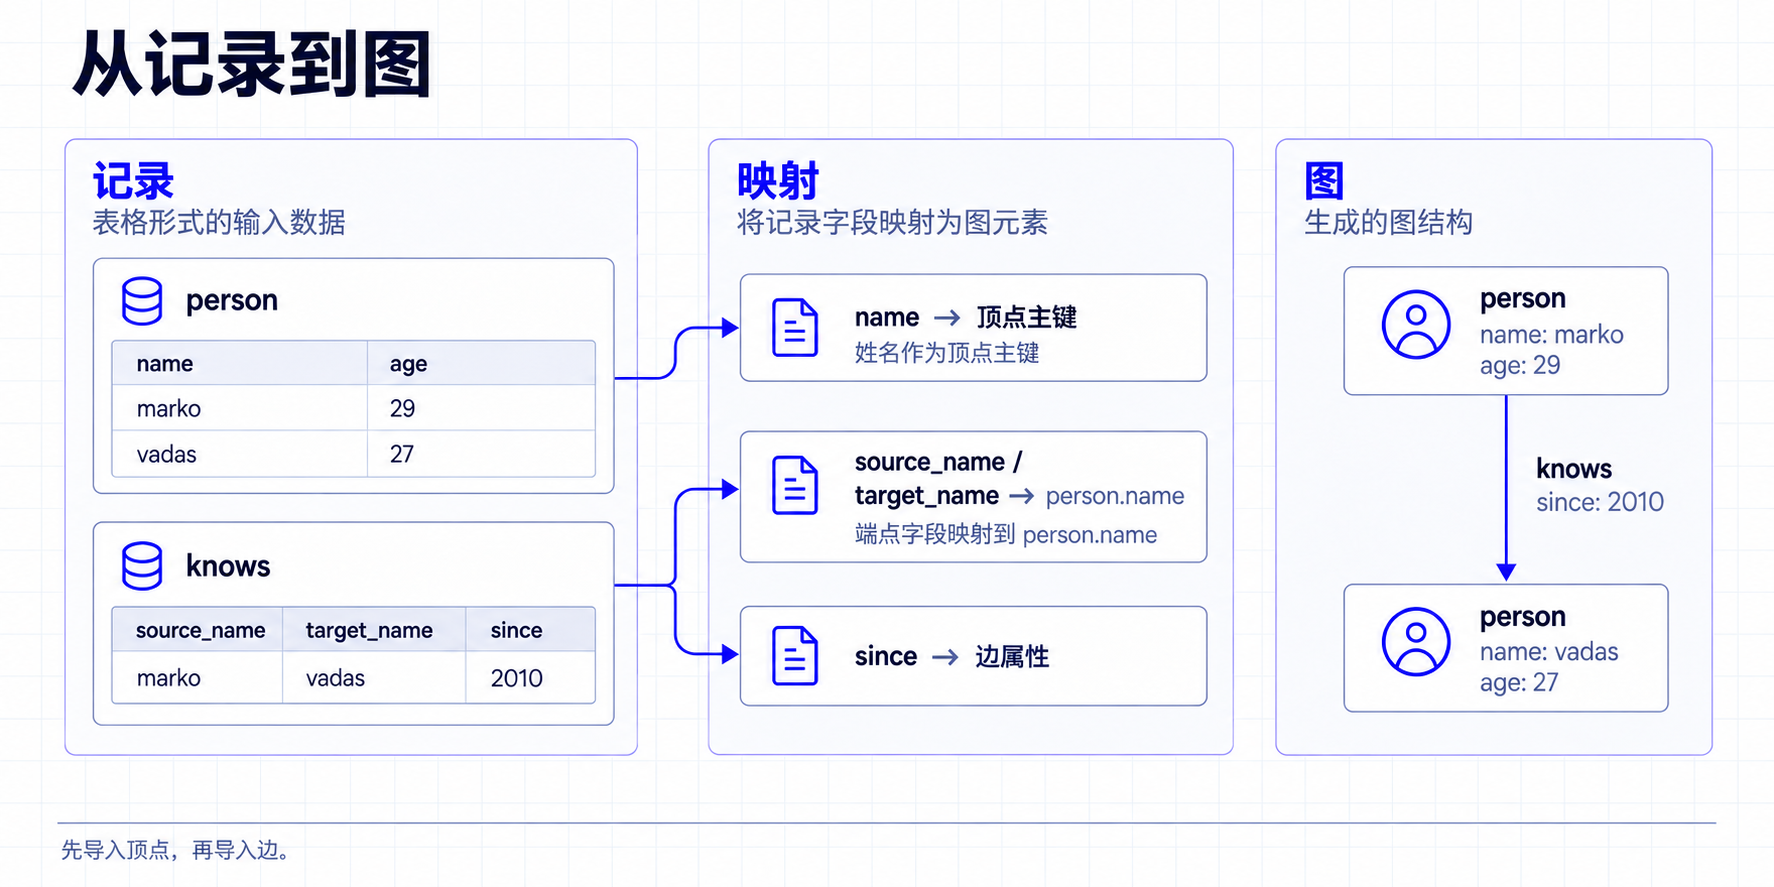
用两个任务完成导入:先把 person 表写成顶点,再把 knows 表写成边。这样写边时,两个端点都已经存在。
3.1 导入顶点
在 MySQL 的 demo 数据库中准备示例数据,并让配置中的账号有读取权限:
保存为 config/sql2graph-person.conf,将数据库账号和密码替换为实际值:
在 Hubble 或 Gremlin 中检查结果,应能查到 marko 和 vadas 及其年龄:
idFields = ["name"] 表示使用名字生成主键。重复导入同一个 name 会写到同一个顶点;properties 指定要写入的源字段。
3.2 导入边
准备关系表,其中两个端点字段对应前面导入的 person.name:
确认顶点任务成功后,再执行边任务:
下面的查询应返回 marko 到 vadas 的 knows 边,属性 since 为 2010:
sourceConfig 和 targetConfig 指定端点字段,fieldMapping 将它们对应到顶点主键 name,properties = ["since"] 只写边属性。示例启用 check_vertex = true,并关闭失败后逐条跳过的回退(batch_failure_fallback = false);端点不存在或写入失败时,任务会报错。
如果关系表只有数字外键,而图的主键使用姓名,请先在 SQL 中关联出姓名,再交给 Sink。MySQL CDC 接入方式见 MySQL CDC Source[13]。
4 从 Kafka 导入(kafka2graph)
Kafka 适合持续接收事件。先创建 user-events topic,再写入以下 JSON 消息,每条消息对应一个 person 顶点:
保存为 config/kafka2graph.conf:
用第 3.1 节的 Gremlin 查询检查数据。流式任务会持续运行;checkpoint.interval 每 10 秒保存一次任务状态,sink.flush.interval 让 Zeta 每 5 秒触发一次刷新,避免少量消息一直等到批次填满。
HugeGraph Sink 是 at-least-once(至少一次) 写入,故障恢复可能重放记录。使用 PRIMARY_KEY 能让相同 name 落到同一个顶点,但不等于所有更新操作都具备 exactly-once 语义。定时刷新由 Zeta 提供,不适用于 Spark 或 Flink 引擎。
5 常用配置与排错
下表适用于本文使用的 SeaTunnel 3.0+ 版本:
| 配置 | 用途 |
|---|---|
host、port | 分别指定 HugeGraph 主机和端口 |
graph_name、graph_space | 选择已创建的图与图空间 |
mappings | 定义输入字段如何生成顶点或边 |
properties | 每个 mapping 内要写入的源字段列表 |
schema_save_mode | mappings 默认自动创建缺失的 Schema;已有 Schema 仍需兼容 |
batch_size | 单批记录数,默认 500 |
env.sink.flush.interval | Zeta 定时刷新间隔,单位毫秒 |
check_vertex | 写边时检查端点,本文的边任务设为 true |
batch_failure_fallback[2] | 默认 true,批量失败后逐条重试,最多跳过 max_insert_errors 条失败记录;本文示例显式设为 false,让批量失败直接终止任务 |
max_insert_errors | 逐条回退时允许跳过的失败记录数;默认 500,-1 表示不限制,仅在开启 batch_failure_fallback 时生效 |
遇到问题时可按下面检查:
- 不识别
mappings或找不到 HugeGraph Source:检查引擎与 HugeGraph connector 是否来自同一次 3.0+ 构建。 - 连接失败:检查主机、端口、图空间、认证信息,以及 SeaTunnel 所在环境能否访问服务。
- Schema 不兼容:检查标签的 ID 策略、属性类型和边端点。自动创建不会把已有
PRIMARY_KEY标签改成CUSTOMIZE_STRING。 - Kafka 少量数据未及时出现:确认使用 Zeta,并在
env中设置sink.flush.interval。此版本的batch_interval_ms仅为兼容保留,不能代替它。
6 选型小结
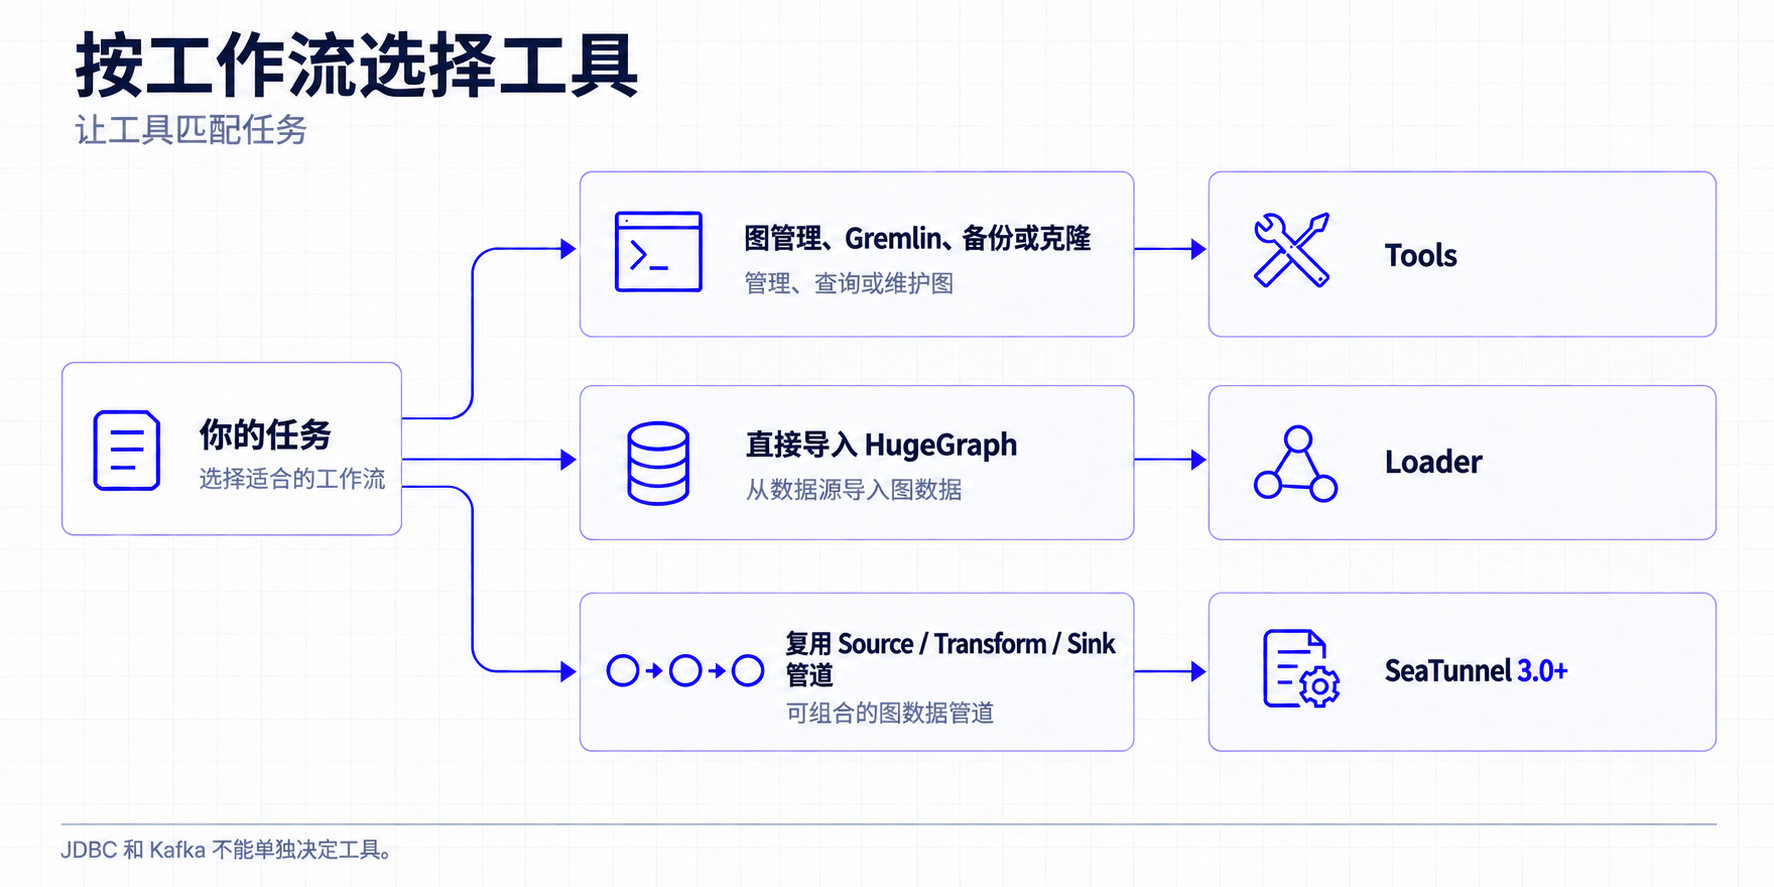
选工具时,先看要完成的工作:图管理、Gremlin、备份或克隆可用 Tools;直接导入图可先看 Loader;需要复用 Source、Transform、Sink 管道时选 SeaTunnel。使用 SeaTunnel 的图读取和迁移能力时,请按本文使用的 3.0+ 版本准备环境。
7 参考文档
HugeGraph 连接器
[1] HugeGraph Source
[2] HugeGraph Sink
配置与部署
[3] HOCON 作业文件配置说明
[4] SeaTunnel 3.0.0-release 分支
[5] SeaTunnel 开发环境文档
[6] SeaTunnel 本地部署
执行引擎
[7] SeaTunnel 引擎概览
[8] SeaTunnel Spark 引擎
[9] SeaTunnel Flink 引擎
[10] Connector V2 多引擎说明
数据源连接器
[11] JDBC Source
[12] Kafka Source
[13] MySQL CDC Source
旧版本兼容
[14] SeaTunnel 2.3.13 HugeGraph Sink
旧版本说明
本文面向 SeaTunnel 3.0+,文中的 Source、
mappings和图迁移示例不适用于 2.3.13。2.3.13 已过时,仅提供 HugeGraph Sink,配置使用schema_config,并且需要提前创建图模型。如必须使用 2.3.13,请参考官方 Sink 文档[14],不要套用本文配置