HugeGraph 设计理念
1. 属性图模型
版本说明:本页保留早期设计内容。属性图模型和顶点 ID 策略仍与 当前主线源码相符;图示、分区结论及事务实现描述按各节注明的范围阅读,不能直接当作当前部署或存储实现说明。
常见的图数据表示模型有两种,分别是RDF(Resource Description Framework)模型和属性图模型。 RDF和Property Graph都是最基础、最有名的图表示模式,都能够表示各种图的实体关系建模。 RDF是W3C标准,而Property Graph是工业标准,受到广大图数据库厂商的广泛支持。HugeGraph目前采用Property Graph。
HugeGraph采用属性图模型。下图以人物和图书为例,展示顶点与有向边各自的标签和属性;这是逻辑模型示意,不描述 当前主线的内部数据布局。
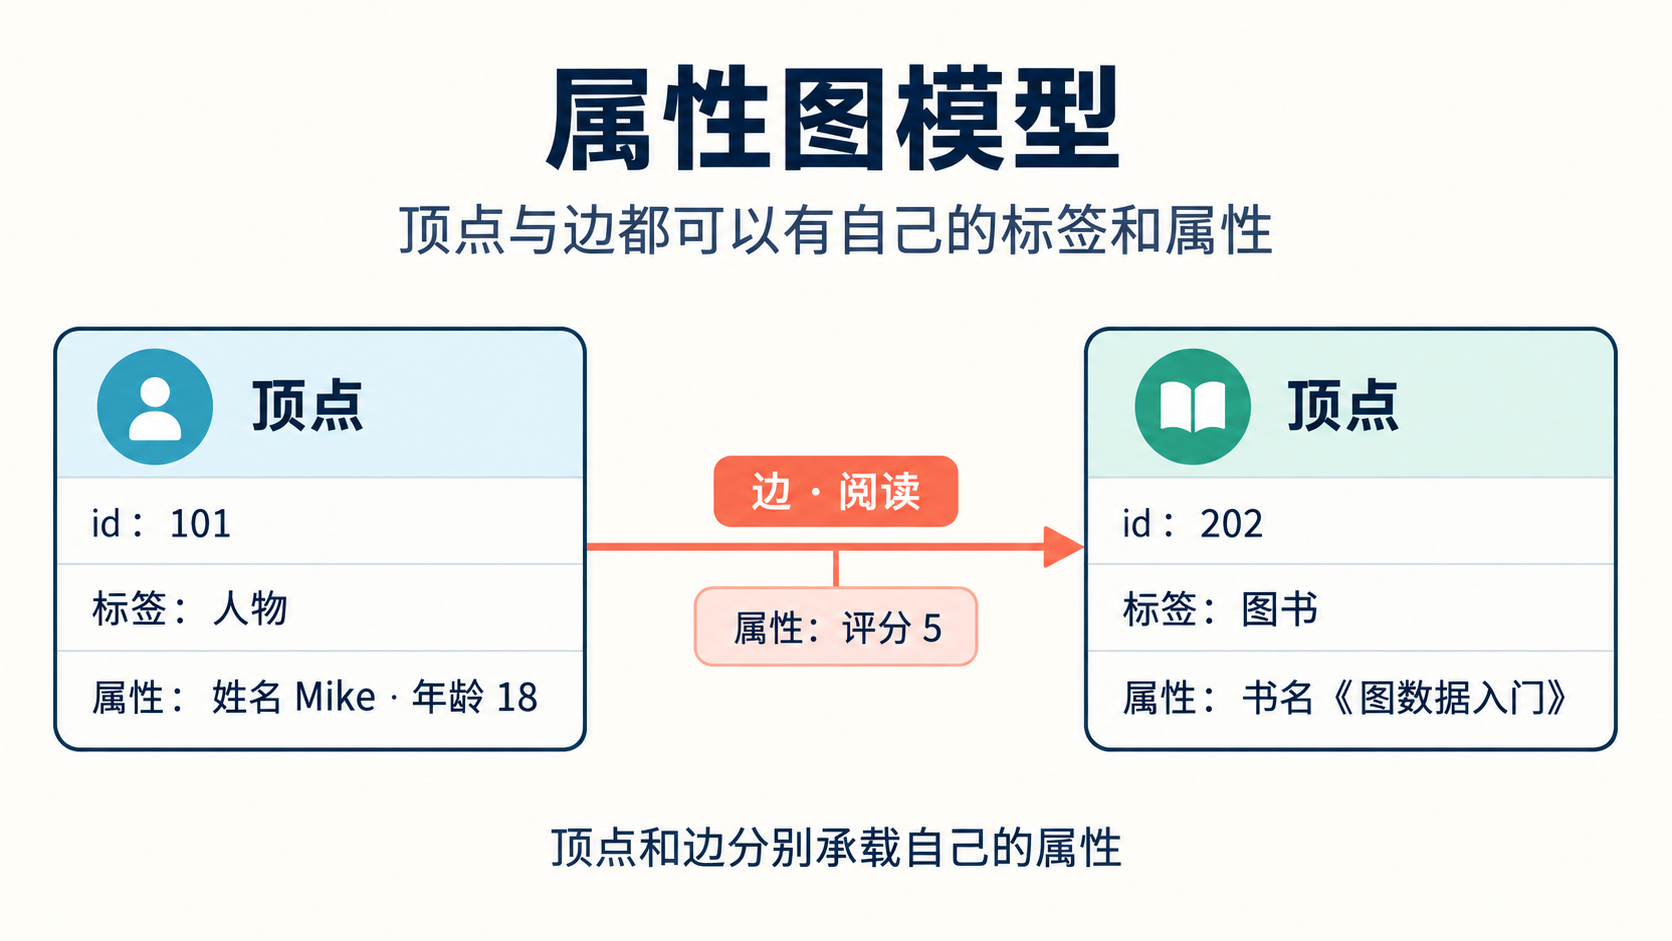
图:顶点和边分别携带自己的标签与属性。
在HugeGraph内部,每个顶点 / 边由唯一的 VertexId / EdgeId 标识,属性存储在对应点 / 边内部。而顶点与顶点之间的关系 / 映射则是通过边来存储的。
顶点属性值通过边指针方式存储时,如果要更新一个顶点特定的属性值直接通过覆盖写入即可,其弊端是冗余存储了VertexId;如果要更新关系的属性需要通过read-and-modify方式,先读取所有属性,修改部分属性,然后再写入存储系统,更新效率较低。 从经验来看顶点属性的修改需求较多,而边的属性修改需求较少,例如PageRank和Graph Cluster等计算都需要频繁修改顶点的属性值。
2. 图分区方案
版本说明:Edge Cut 与 Vertex Cut 的比较属于历史设计背景。当前主线的 PD 与 Store 源码没有把“HugeGraph 采用 Edge Cut”定义为实现契约,因此下文该结论不适用于描述 当前主线的实际分区与副本机制;当前分布式部署请参考 HStore 快速上手。
对于分布式图数据库而言,图的分区存储方式有两种:分别是边分割存储(Edge Cut)和点分割存储(Vertex Cut),如下图所示。使用Edge Cut方式存储图时,任何一个顶点只会出现在一台机器上,而边可能分布在不同机器上,这种存储方式有可能导致边多次存储。 使用Vertex Cut方式存储图时,任何一条边只会出现在一台机器上,而每相同的一个点可能分布到不同机器上,这种存储方式可能会导致顶点多次存储。
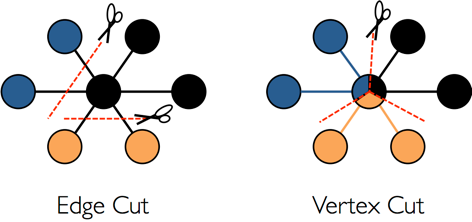
采用EdgeCut分区方案可以支持高性能的插入和更新操作,而VertexCut分区方案更适合静态图查询分析,因此EdgeCut适合OLTP图查询,VertexCut更适合OLAP的图查询。早期设计资料曾记载 HugeGraph 采用 Edge Cut。此处保留该历史结论,不将其视为当前分区实现说明。
3. VertexId 策略
HugeGraph的Vertex支持四种ID策略,在同一个图数据库中不同的VertexLabel可以使用不同的Id策略,目前HugeGraph支持的Id策略分别是:
- 自动生成(AUTOMATIC):使用Snowflake算法自动生成全局唯一Id,Long类型;
- 主键(PRIMARY_KEY):通过VertexLabel+PrimaryKeyValues生成Id,String类型;
- 自定义(CUSTOMIZE_STRING|CUSTOMIZE_NUMBER):用户自定义Id,分为String和Long类型两种,需自己保证Id的唯一性;
- 自定义UUID(CUSTOMIZE_UUID):用户自定义UUID形式的Id,需自己保证Id的唯一性;
默认的Id策略是AUTOMATIC,如果用户调用primaryKeys()方法并设置了正确的PrimaryKeys,则自动启用PRIMARY_KEY策略。启用PRIMARY_KEY策略后HugeGraph能根据PrimaryKeys实现数据去重。
- AUTOMATIC ID策略
- PRIMARY_KEY ID策略
- CUSTOMIZE_STRING ID策略
- CUSTOMIZE_NUMBER ID策略
- CUSTOMIZE_UUID ID策略
如果用户需要Vertex去重,有三种方案分别是:
- 采用PRIMARY_KEY策略,自动覆盖,适合大数据量批量插入,用户无法知道是否发生了覆盖行为
- 采用AUTOMATIC策略,read-and-modify,适合小数据量插入,用户可以明确知道是否发生覆盖
- 采用CUSTOMIZE_STRING或CUSTOMIZE_NUMBER策略,用户自己保证唯一
4. EdgeId 策略
当前实现提示:本节的四项组合是历史简化描述。当前
EdgeId还区分边方向及父、子边标签;其实际字段见 Server 源码中的EdgeId实现。需要依赖 ID 格式或持久化键时,应以对应版本源码为准。
HugeGraph的EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合而成。其中sortKey是HugeGraph的一个重要概念。在Edge中加入sortKey作为Edge的唯一标识的原因有两个:
- 如果两个顶点之间存在多条相同Label的边可通过
sortKey来区分 - 对于SuperNode的节点,可以通过
sortKey来排序截断。
由于EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合,多次插入相同的Edge时HugeGraph会自动覆盖以实现去重。需要注意的是如果批量插入模式下Edge的属性也将会覆盖。
另外由于HugeGraph的EdgeId采用自动去重策略,对于self-loop(一个顶点存在一条指向自身的边)的情况下HugeGraph认为仅有一条边,对于采用AUTOMATIC策略的图数据库(例如TitianDB )则会认为该图存在两条边。
HugeGraph的边仅支持有向边,无向边可以创建Out和In两条边来实现。
5. HugeGraph 事务概览
版本范围:下文关于 HugeGraph 隔离级别、线程绑定和后端原子性的描述保留为历史实现说明。各后端的事务隔离与失败回滚边界应以对应实现为准,不应将下述历史描述当作跨后端保证。
TinkerPop事务概述
TinkerPop 事务是对数据库执行操作的工作单元,一个事务内的一组操作要么执行成功,要么全部失败。详细介绍请参考TinkerPop官方文档:http://tinkerpop.apache.org/docs/current/reference/#transactions
TinkerPop事务操作接口
- open 打开事务
- commit 提交事务
- rollback 回滚事务
- close 关闭事务
TinkerPop事务规范
- 事务必须显式提交后才可生效(未提交时修改操作只有本事务内查询可看到)
- 事务必须打开之后才可提交或回滚
- 如果事务设置自动打开则无需显式打开(默认方式),如果设置手动打开则必须显式打开
- 可设置事务关闭时:自动提交、自动回滚(默认方式)、手动(禁止显式关闭)等3种模式
- 事务在提交或回滚后必须是关闭状态
- 事务在查询后必须是打开状态
- 事务(非threaded tx)必须线程隔离,多线程操作同一事务互不影响
更多事务规范用例见:Transaction Test
HugeGraph事务实现
- 一个事务中所有的操作要么成功要么失败
- 一个事务只能读取到另外一个事务已提交的内容(Read committed)
- 所有未提交的操作均能在本事务中查询出来,包括:
- 增加顶点能够查询出该顶点
- 删除顶点能够过滤掉该顶点
- 删除顶点能够过滤掉该顶点相关边
- 增加边能够查询出该边
- 删除边能够过滤掉该边
- 增加/修改(顶点、边)属性能够在查询时生效
- 删除(顶点、边)属性能够在查询时生效
- 所有未提交的操作在事务回滚后均失效,包括:
- 顶点、边的增加、删除
- 属性的增加/修改、删除
示例:一个事务无法读取另一个事务未提交的内容
事务实现原理
- 服务端内部通过将事务与线程绑定实现隔离(ThreadLocal)
- 本事务未提交的内容按照时间顺序覆盖老数据以供本事务查询最新版本数据
- 底层依赖后端数据库保证事务原子性操作(如RocksDB的batch接口保证原子性)
注意
REST API 未提供独立的事务生命周期接口;写操作接口会在服务端调用相应的事务提交逻辑。
TinkerPop API允许打开事务,请求完成时会自动关闭(Gremlin Server强制关闭)