HugeGraph-LLM
HugeGraph-LLM 用于知识图谱构建、GraphRAG 和自然语言图查询。演示服务把 Gradio 页面和 FastAPI 接口挂在同一个进程上,直接从源码启动时默认只监听本机 127.0.0.1:8001,可用 http://localhost:8001 访问。若显式启动源码入口且只需本机访问,可指定 --host 127.0.0.1;源码 Docker 镜像的 Dockerfile.llm 会覆盖默认值并监听 0.0.0.0:8001,不要在容器内改为 loopback,否则容器外无法通过映射端口访问。
生产环境必须为 HugeGraph-LLM 启用自身的登录认证(ENABLE_LOGIN=True,并替换 USER_TOKEN、ADMIN_TOKEN),同时在防火墙或网络入口设置来源 IP 白名单。HugeGraph Server 还必须单独开启认证与授权(见认证与授权说明)并保留 Server 审计日志(标准日志文件为 audit-*.log),为 GRAPH_USER 配置只具备该服务所需权限的账号。AI 服务 token 只认证 LLM 页面和 API,不能替代 HugeGraph Server 认证。
环境要求
AI 总结项目文档:Ask DeepWiki
- Python 3.10 或 3.11(
>=3.10,<3.12) uv0.7 或更高版本- HugeGraph Server 1.5.0 或更高版本;当前 workspace 中的 Python 客户端会拒绝可探测到的更低版本
Docker Compose 部署
在 HugeGraph-AI 仓库根目录准备环境文件:
启动后可访问:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 页面:
http://localhost:8001
Compose 文件会把 ${PROJECT_PATH}/hugegraph-llm/.env 挂载到容器内的 /home/work/hugegraph-llm/.env,因此该文件必须在容器启动前存在。资源目录 hugegraph-llm/src/hugegraph_llm/resources 也可以用同样方式挂载,该挂载默认被注释掉。
应用读取 GRAPH_URL,Compose 注入的 HUGEGRAPH_HOST 和 HUGEGRAPH_PORT 不会覆盖它;因此容器内要将 GRAPH_URL 设为 server:8080,并在 .env 中配置匹配 HugeGraph Server 的用户名和密码。
容器镜像
| 镜像 | 构建文件 | 内容 |
|---|---|---|
docker/Dockerfile.llm | 源码运行镜像构建配方,入口是 python -m hugegraph_llm.demo.rag_demo.app --host 0.0.0.0 --port 8001 | |
docker/Dockerfile.nk | 基于 nk-llm extra 用 Nuitka 编译的二进制镜像构建配方,入口是 ./app.dist/app.bin |
Compose 文件引用未指定标签的 hugegraph/rag,Docker 会使用默认的 latest 标签。scripts/build_llm_image.sh 则以 docker/Dockerfile.llm 在本地构建 hugegraph/graphrag:1.7.0。Compose 引用的 hugegraph/rag:latest 与本地构建的 hugegraph/graphrag:1.7.0 是不同镜像;本地构建不会自动替换 Compose 所用镜像。要在 Compose 中运行本地构建结果,需将 Compose 的 image 改为 hugegraph/graphrag:1.7.0。该脚本只构建镜像,不会推送。两个 Dockerfile 都声明 8001 端口、以非 root 用户 work 运行,并用 curl -f http://localhost:8001/ 做镜像健康检查;两者都为资源目录声明数据卷。
scripts/build_llm_image.sh 会用 docker/Dockerfile.llm 构建并打上 hugegraph/graphrag:1.7.0 标签。
Kubernetes 部署
docker/charts/hg-llm 是 RAG 服务的 Helm chart,部署 hugegraph/graphrag 镜像。默认发布 NodePort 类型的 Service,把节点端口 8039 和服务端口 8080 映射到容器端口 8001,名称固定为 hg-llm-service。Ingress 和水平自动扩缩容已定义但默认关闭。
该 chart 只部署 RAG 服务,不会部署 HugeGraph Server。挂载的 .env 中要把 GRAPH_URL 设为 Pod 可访问的 HugeGraph 地址,并配置匹配的用户名和密码。
chart 中 image.tag 仍默认为 v0.0.1。当前构建脚本生成的标签是本地 hugegraph/graphrag:1.7.0;部署前须确保同名镜像已推送到集群可访问的仓库,或已加载到集群节点,并将 chart 的标签和拉取策略设为匹配的值。
chart 的 values.yaml 中,.env 和提示词 YAML 的挂载默认被注释掉。提示词 YAML 可用 ConfigMap;.env 可能含有密钥和密码,应使用 Secret,并把 volumes 中 env-config 的 configMap 改为 secret。Secret 和提示词 ConfigMap 可分别创建:
随后取消 volumeMounts 段落的注释,并按需要启用提示词 ConfigMap 的 volumes 和挂载。Helm 模板会直接渲染 values.yaml 中的卷定义。
从源码启动
依赖应从仓库根目录按 workspace 安装:
自定义监听地址和端口:
设置 HG_DEV_RELOAD=1 可让 uvicorn 以自动重载方式启动,便于开发调试。
服务以 hugegraph-llm/.env 保存模型、HugeGraph 和登录配置。提示词放在 hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml。缺少文件时,配置代码会按默认值创建。
.env 路径按以下顺序解析:先看是否设置了 HUGEGRAPH_LLM_ENV_PATH;未设置时,从源码运行则使用 hugegraph-llm/.env;否则使用当前工作目录下的 .env。
主要功能
构建 RAG 索引
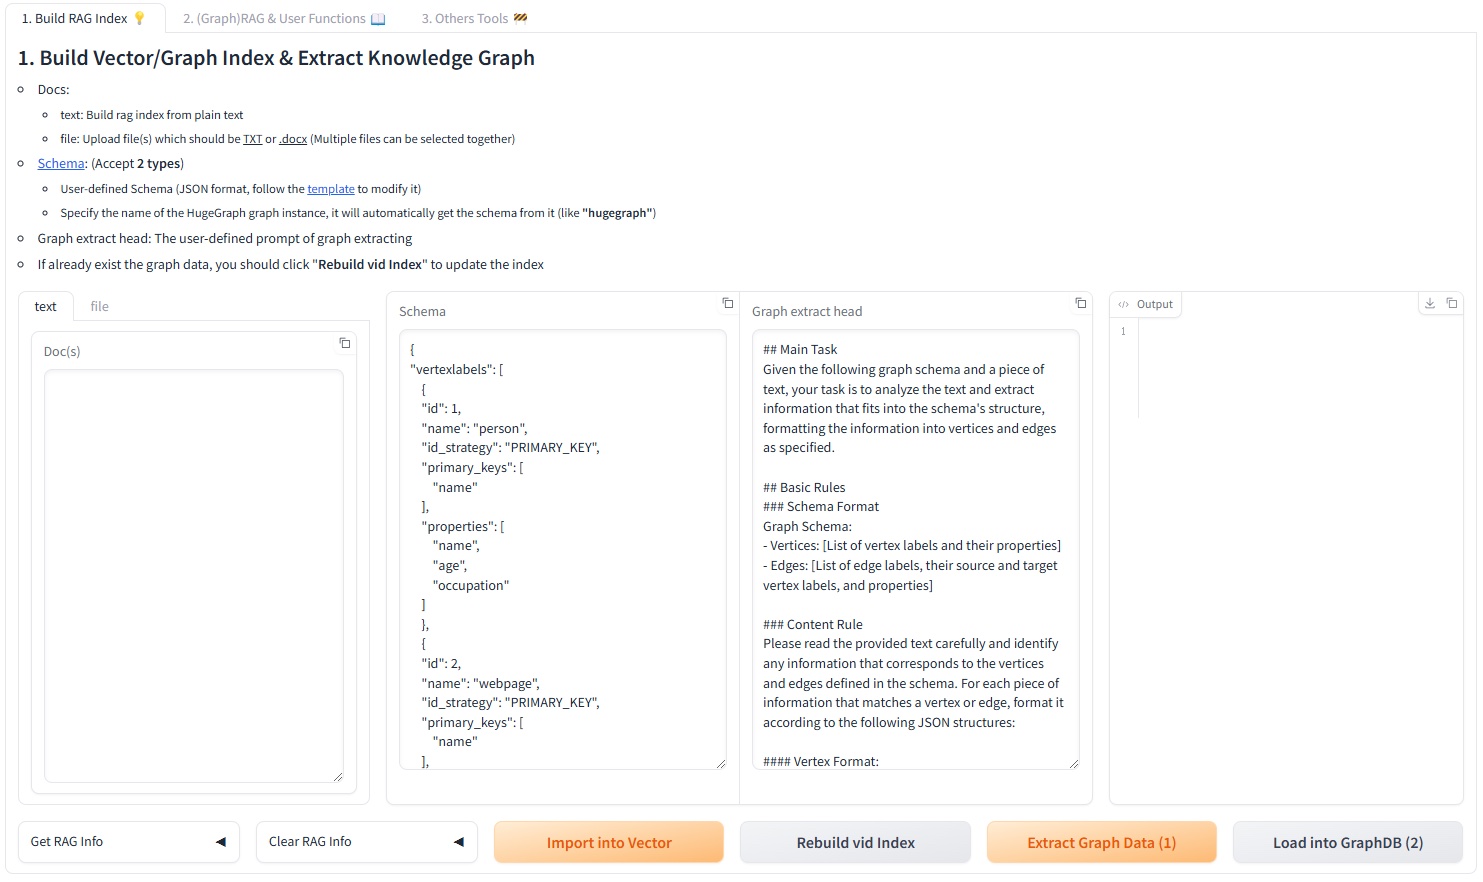
Web 页面的第一个标签页可以处理文本或文件,并执行以下操作:
- 切分文本并写入 chunk 向量索引。
- 按给定 Schema 从文本抽取顶点和边。
- 将抽取结果写入 HugeGraph,并更新顶点向量索引。
文本可以在 text 子页直接输入,也可以在 file 子页上传。上传支持 .txt、.docx 和 .pdf,并可一次选择多个文件。加密 PDF 以及没有可提取文本层的扫描件 PDF 会被拒绝。
Schema 可以是内联 JSON,也可以是现有图名。通过 REST API 使用图名时,必须同时传入匹配的 client_config.graph;内联 JSON 不会连接 HugeGraph,也不能附带 client_config。
该标签页还提供两个生成器。Graph Schema Generator 根据查询示例和少样本示例生成 Schema。Graph Extraction Prompt Generator 根据描述的场景和选定的参考示例生成抽取提示词。Graph Extraction Split Type 下拉框可在抽取前选择 document、paragraph 或 sentence 粒度。
GraphRAG
查询流程可以组合直接回答、chunk 向量召回和图召回。图召回先抽取关键词并匹配顶点,再尝试 Text2Gremlin;生成或执行失败时可回退到预定义的图遍历方式。请求参数可控制返回数量、向量距离阈值、模板数量和重排序方式。
同一标签页还有批量回归测试面板,可从 .xlsx 或 .csv 文件读取问题、逐条作答,并返回可下载的结果文件。上传控件旁提供模板文件下载。
Text2Gremlin
POST /text2gremlin 根据自然语言、图 Schema 和可选示例生成 Gremlin。自定义提示词必须保留 {query}、{schema}、{example} 和 {vertices} 四个占位符。
对应的页面标签可以先用问题与 Gremlin 对照文件(.json 或 .csv)构建示例向量索引。未上传文件时使用内置的 resources/demo/text2gremlin.csv。
图工具与管理工具
Graph Tools 标签页可直接执行 Gremlin 查询、手动触发图备份,以及初始化 HugeGraph 演示数据。Admin Tools 标签页在校验 ADMIN_TOKEN 后展示 logs/llm-server.log 的末尾内容,并可刷新或清空该文件。
进程运行期间还有两个后台任务:每天 01:00 执行图备份的定时任务,以及持续更新顶点 id 向量的任务。
模型与向量后端
聊天、信息抽取和 Text2Gremlin 可以分别使用 OpenAI 兼容接口、Ollama 或 LiteLLM。嵌入模型可独立选择,同样支持这三种提供方。重排序支持 Cohere 和 SiliconFlow。
默认向量索引使用 FAISS。CUR_VECTOR_INDEX 可选 Faiss、Milvus 或 Qdrant,Web 页面的 5. Set up the vector engine. 面板提供同样的选择。Milvus 和 Qdrant 需要安装可选依赖:
页面操作流程见使用流程,完整环境变量见配置参考,HTTP 请求格式见REST API。
程序化调用
原有的 RAGPipeline 和 KgBuilder 类已被流水线调度器取代。通过 SchedulerSingleton 按名称调用流程:
已注册的流程名包括 rag_raw、rag_vector_only、rag_graph_only、rag_graph_vector、text2gremlin、build_examples_index、build_vector_index、graph_extract、import_graph_data、update_vid_embeddings、get_graph_index_info、build_schema 和 prompt_generate。schedule_stream_flow 是对应的异步流式版本。
开发检查
先在仓库根目录安装模块和开发工具,再运行与 CI 一致的检查:
Git hook 通过 pre-commit 启用: