使用 Helm 部署 HugeGraph
本文适用于 HugeGraph 1.8.0 及以后版本,需要支持 OCI 的 Helm 3.10+ 和 Kubernetes (K8s) 1.23+。
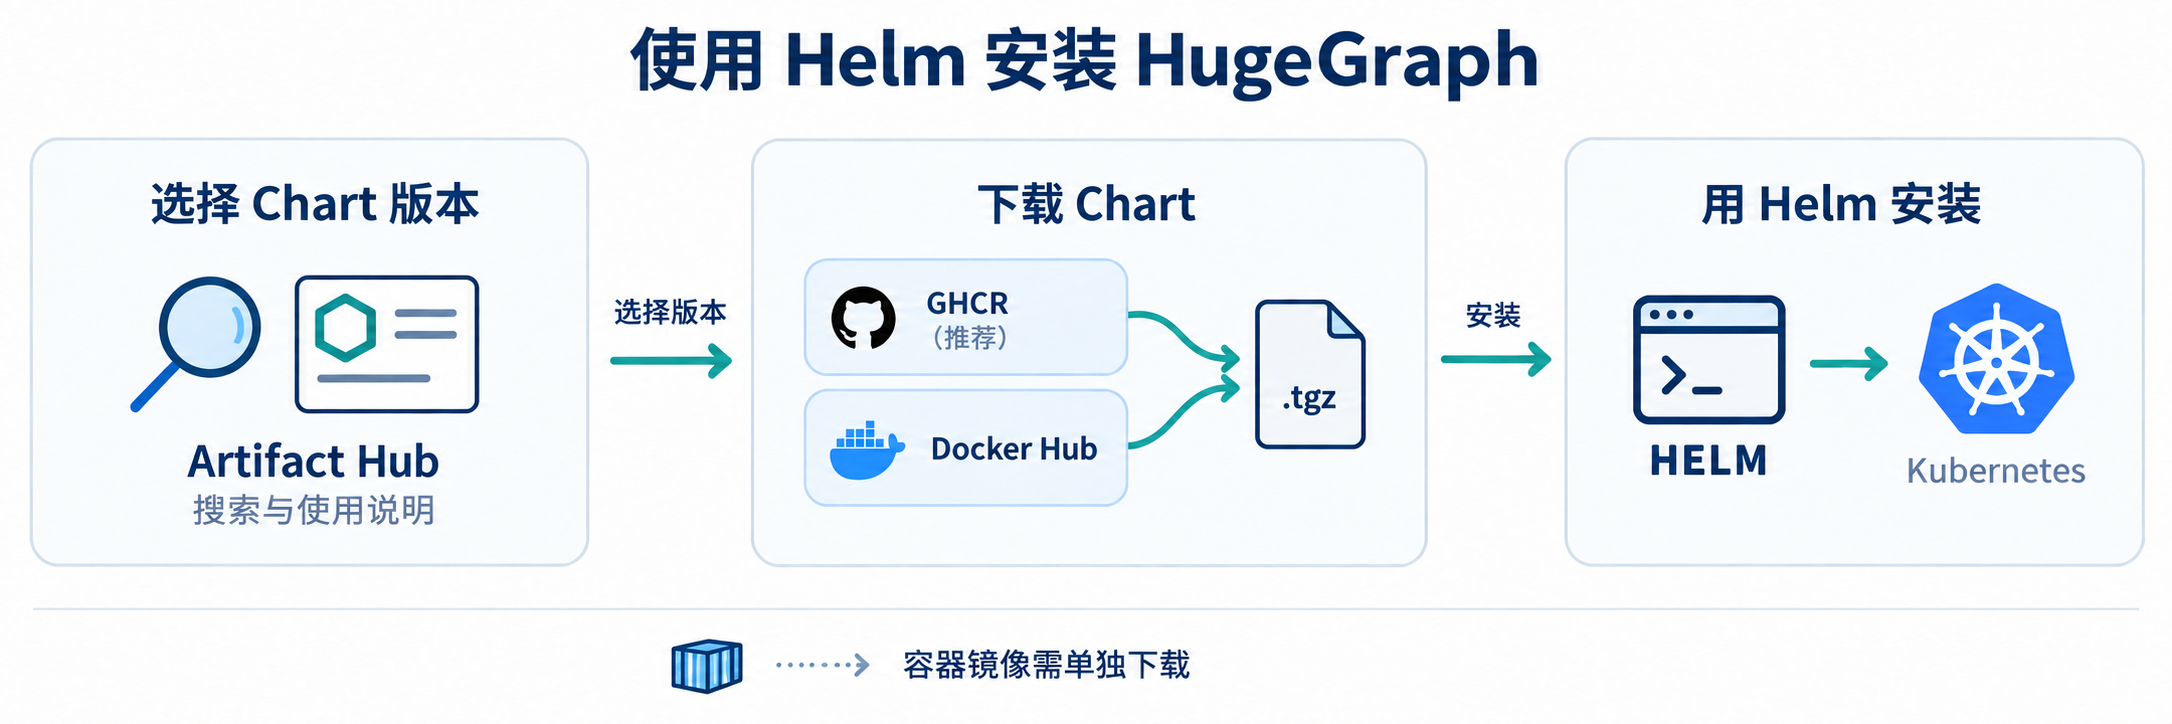
可从 GHCR 或 Docker Hub 安装 hugegraph-helm。Chart 与 HugeGraph 服务分别维护版本,例如 0.4.x 的 Chart 可以部署 1.8.x 的服务。
当前开发 Chart 的 HugeGraph 基础组件使用 latest 镜像,适合测试。
可选 Vermeer 已固定为经过验证的已发布镜像及 digest,见可选引擎。
对应 HugeGraph 服务正式发布后,生产环境请选择稳定 Chart,并检查其中的镜像版本。
镜像标签可能变化;需要固定镜像内容时,请配置各组件的 image.digest。
Artifact Hub 方便查找 Chart、查看版本和安装说明,实际安装包仍从 GHCR 或 Docker Hub 下载。 参数和源码开发方式见 chart README, 生命周期操作见 运维参考。
1 安装
默认部署规格与存储要求
- 拓扑组成:默认部署 3 PD + 3 Store + 3 Server 与 1 Hubble,默认开启鉴权与持久化存储。
- 存储依赖:需要集群具备默认动态 StorageClass 或预先匹配的静态 local PV,共需 7 个持久卷(3 个 10 GiB PD 卷、3 个 50 GiB Store 卷、1 个 1 GiB Hubble 卷)。
- 内存考量:保留镜像内 JVM 内存自动推导;按需调整 resource requests/limits,确保宿主机给 9 个图服务 JVM 与 Hubble 提供足够内存。
选择一个下载源即可,公共 CI 推荐 GHCR。本地轻量测试可直接使用单节点预设。
--devel 按版本号选择最新 Chart,包含开发版和稳定版,不限于某个版本系列。
生产部署或需要复现时,将 --devel 换成 --version <已发布版本>,固定你选定的版本。
单节点试用预设使用 HStore 的 1 PD + 1 Store + 1 Server 与 Hubble,放宽调度限制,适合资源受限环境。 SeaTunnel 和 Vermeer 仍保持关闭。
2 模式和访问入口
解压后目录为 hugegraph-helm/,源码目录仍为 helm/hugegraph/。
HugeGraph Helm 核心文件与结构
hugegraph-helm/
- Chart.yamlChart 元数据与版本定义
- values.yaml默认配置(easy 模式:3 PD + 3 Store + 3 Server + 1 Hubble,NodePort 入口)
- values-single.yaml单节点预设(本地 Minikube/Kind 测试,1 副本且关闭反亲和与 PDB)
- values-cluster.yaml生产集群预设(跨节点反亲和调度,Store 采用 OnDelete 逐个滚动升级)
- values-strict.yaml安全加固预设(strict 模式:全部 ClusterIP,强制启用 NetworkPolicy 隔离)
- values.schema.jsonvalues 配置参数校验规范
templates/Kubernetes 资源编排模板
- pd-statefulset.yamlPD 服务有状态副本集(元数据与调度中心)
- store-statefulset.yamlStore 存储节点有状态副本集(分布式存储引擎)
- server-deployment.yamlServer 引擎无状态 Deployment(注入 serviceId / graphSpace)
- hubble-deployment.yaml可视化控制台 Deployment
- tests/冒烟验证测试钩子(helm test,支持自定义 testGraphAlias)
- examples/部署示例(local PV、GitOps 凭据、可选引擎、Ingress 等)
- docs/operations.md生命周期进阶运维与故障恢复手册
默认 mode: easy,Server 和 Hubble 自动分配 NodePort,PD 保持 ClusterIP。可以直接使用 HTTP,无需域名、证书或额外确认参数。
mode: strict 默认将 Server/Hubble 设为 ClusterIP,并开启完整 NetworkPolicy 隔离。
SeaTunnel 和 Vermeer 启用后的原生 HTTP/UI 在 easy 模式下默认使用 NodePort,strict 模式下默认使用 ClusterIP,两种模式均需登录。
内部 RPC、Worker HTTP 与 SeaTunnel 成员端口仍保持私有。两个模式都保留鉴权和持久化。
优先级是组件显式参数高于全局参数,全局参数高于模式默认值,显式 false 也会生效。
全局参数包括 persistence.enabled 和 global.imageRegistry,严格预设为 values-strict.yaml。
| 入口 | 访问方式 | 前提 |
|---|---|---|
| NodePort | http://<可达节点IP>:<分配的NodePort> | 节点网络可达且防火墙放行,无需额外控制器 |
| ClusterIP | 集群内虚拟 Service IP/DNS,如 hugegraph-server.hugegraph.svc:8080 | 集群外通过 port-forward 或已有网关访问 |
| LoadBalancer | 基础设施分配的地址 | 集群有对应负载均衡控制器 |
| Ingress | 通过控制器路由 HTTP 请求 | 已安装 Ingress 控制器,域名和 TLS 都可选 |
使用 Hubble 的 NodePort 打开页面,以 admin 和查出的密码登录。
默认 externalTrafficPolicy: Cluster 下,访问的节点不必运行目标 Pod。ClusterIP 是集群内部的虚拟服务地址,不是节点 IP,普通笔记本通常不能直接访问。
也可以运行 kubectl -n hugegraph port-forward svc/hugegraph-hubble 8088:8088,在本机打开 http://127.0.0.1:8088。
基础 PD/Server/Hubble 三类客户端 Service 支持 externalTrafficPolicy、loadBalancerClass、loadBalancerIP、loadBalancerSourceRanges、externalIPs
和 allocateLoadBalancerNodePorts,具体行为取决于集群及负载均衡实现。LoadBalancer 专用字段应配合对应类型使用。
NodePort 省略或设为 0 时自动分配,固定端口由 Kubernetes 根据集群配置的范围校验,chart 不再强制 30000–32767。
原 HTTP 暴露确认参数保留兼容,但不再阻止渲染。
可选引擎:默认关闭
Chart 默认仅部署核心图服务(PD + Store + Server + Hubble)。针对数据集成与超大规模内存图计算场景,Chart 提供了 SeaTunnel 与 Vermeer 两款原生可选引擎,默认均保持关闭:
| 可选引擎 | 默认状态 | 核心用途 | 运行模式 (*.mode) | 访问控制 |
|---|---|---|---|---|
| Hubble | 开启 (true) | 图数据可视化、多图空间与任务监控 | 单副本 Deployment | 跟随全局 mode(NodePort 或 ClusterIP) |
| SeaTunnel | 关闭 (false) | 异构数据源批流导入与跨图整库迁移 | standalone / cluster | easy 为 NodePort,strict 为 ClusterIP;HTTP Basic 鉴权 |
| Vermeer | 关闭 (false) | 内存优先的高性能分布式图计算算法 | standalone / cluster | easy 为 NodePort,strict 为 ClusterIP;Token 鉴权,Hubble 自动集成 |
在 values 中将对应引擎的 enabled 设为 true 即可启用,管理密码与 Server 独立生成。
seatunnel.service.type 和 vermeer.service.type 为 null 时继承模式默认值:easy 为 NodePort,strict 为 ClusterIP。
显式 ClusterIP 保持私有;显式 NodePort(包括 strict 模式)开放需要登录的 HTTP/UI。
旧配置显式指定了 ClusterIP 时,需改回 null 才会继承 easy 默认值;省略 service.nodePort 或设为 null 时由 Kubernetes 分配端口。
引擎的 standalone / cluster 拓扑独立于上述访问设置。
SeaTunnel:按需开启原生数据导入、导出与迁移
运行模式:
standalone启动 1 个 Hybrid 节点(轻量测试);cluster模式启动多个同构节点(高并发批处理)。访问与凭据:easy 模式通过分配的 HTTP NodePort 打开
http://<可达节点IP>:<NodePort>/#/overview:使用 HTTP Basic 用户名
admin和hugegraph-seatunnel-authSecret 中的密码登录。 strict 默认 ClusterIP,可用kubectl -n hugegraph port-forward svc/hugegraph-seatunnel 8081:8080在本机访问;5801仍仅供内部通信。完整作业配置、内置示例验证及跨图迁移流程见 SeaTunnel 部署章节 或 SeaTunnel 部署指南。
Vermeer:按需开启内存图计算,自动接入 Hubble
运行模式:
standalone单机模式在同一个 Pod 中运行 Master 协调与 Worker 计算容器;cluster模式提供独立的 Master Pod 与可水平扩展的 Worker Pod 集群(默认 3 副本)。Hubble 一键集成:Hubble 会自动注入 Master 内部 Service 地址与访问令牌。管理员在 Hubble 控制台即可直接触发 15+ 种图算法,计算结果保留在内存副本中,不污染原图属性。
原生控制台直连:easy 模式通过
<release>-vermeer-master分配的 HTTP NodePort 打开http://<可达节点IP>:<NodePort>/:并在 Admin credential 输入框中填入
<release>-vermeer-adminSecret 的password(无需用户名)登录。 strict 模式默认 ClusterIP,可用kubectl -n hugegraph port-forward svc/hugegraph-vermeer-master 6688:6688转发访问;内部 Master/Worker RPC 与 Worker HTTP 保持私有。镜像固定策略与进阶凭据管理见 Vermeer 部署指南。
PD 元数据命名空间
顶层参数 metadataCluster(默认 hg-test)定义了 PD 中元数据的集群前缀。Chart 会将该值同步注入 Server 的 HG_SERVER_CLUSTER 与 Store 的 PD_CLUSTER,使得 Store 在接收 Vermeer 扫描请求时能准确定位 Server 写入的 Schema。
metadataCluster 是元数据存储的前缀空间,而非 Raft 分组名。修改该值不会自动迁移已有图数据。开启 Vermeer 时必须保留原有集群的前缀值;若加载图时遇到 Schema missing 或 no such vertex label,请优先检查各组件的元数据前缀是否一致。自定义前缀的核验流程请参考 元数据命名空间运维指引。
服务身份与图空间
默认 server.serviceId 与 server.graphSpace 均为 DEFAULT。如需将 Server 注册到指定的业务服务名或图空间,可通过 values 指定:
仅修改已有部署的配置时,保留当前 Chart 版本和 values。用 helm list 查看版本,替换下面的版本占位符:
注意:非默认图空间必须在启动 Server 前先调用 PD API 创建;server.testGraphAlias 用于指定 helm test 验证的 Gremlin 图别名(区分大小写),
不会从 graphSpace 自动推导。请勿在 server.extraEnv 中重复声明服务 ID 或图空间。
3 内网镜像和存储
完整例子包含内网镜像、动态存储、七个 local PV、 GitOps 凭据、仅 API 部署以及无域名的 HTTP Ingress。
global.imageRegistry 为未指定 registry 的镜像仓库加前缀,组件指定完整 registry 地址时优先采用组件配置。
默认只需镜像仓库中的 hugegraph/pd、hugegraph/store、hugegraph/server 和 hugegraph/hubble 四个镜像,标签或 digest 按实际配置选取。
等待 PD 的 init container 复用 Store 镜像,Helm test 复用 Server 镜像。这两个镜像已包含 curl,无需额外 curl 镜像或启动时安装软件。
自定义镜像可以继续使用显式 store.waitImage 和 server.waitImage 覆盖。
启用 SeaTunnel 时还需同步其配置的 apache/seatunnel 镜像,启用 Vermeer 时使用上文固定的已发布构建。
Vermeer 的 Master、Worker 和服务令牌初始化复用同一镜像;所有已启用镜像及显式 helper 覆盖都应同步。
使用自定义 Vermeer 镜像时,还需更新 vermeer.image.digest,或在按标签选择时显式清空;非空 digest 优先于标签。
存储配置
storageClassName 为空时继承集群默认 StorageClass,"-" 表示显式不使用 StorageClass。
local PV 需要预建宿主机目录、匹配容量、nodeAffinity 和 kubernetes.io/no-provisioner StorageClass。
WaitForFirstConsumer 根据 Pod 调度约束绑定,创建资源前请查看七个卷的完整例子。
新建临时实例可以设置 persistence.enabled=false 使用 emptyDir,组件存储开关优先。
PVC 失败不会自动降级为临时存储,已经初始化的 PD/Store 切换存储模式会被拒绝。
Vermeer 的 Master 和 Worker 使用独立数据卷,单 Pod 模式也不共享 Pebble 目录。 单机模式增加 2 个卷;集群模式为 1 个 Master 卷加每 Worker 1 个卷,默认增加 4 个。 因此默认基础拓扑加 Vermeer 单机/集群分别需要 9/11 个卷,轻量 HugeGraph 预设加 Vermeer 单机需要 5 个。 七卷 local PV 示例仅覆盖基础安装;SeaTunnel checkpoint 仍使用临时本地文件。
离线安装和私库
先选择最新版本,再按该版本下载 Chart,将 .tgz 搬入内网。可以直接安装,也可以接入已有的 OCI 或 HTTP 私库。
内网安装需通过 --set global.imageRegistry=... 覆盖镜像私库,
参见 values-internal-registry.yaml。
私库地址请替换为实际地址。Chart 包不包含容器镜像;完整离线部署还需搬运配置引用的所有容器镜像,并覆盖镜像地址。
4 鉴权和 Secret
普通 Helm 安装自动生成、复用三份凭据,分别为 <release>-admin 的 password、<release>-auth-token 的 token_secret
以及 <release>-pd-auth 的 secret-key。PD REST 使用共享的 PD Secret,通过 HG_PD_AUTH_SECRET_KEY 注入 PD 容器,
Server 等待存储和 Hubble 使用同一份凭据,不需要用户为每个 PD Pod 单独发明密码。
GitOps 使用加密的固定值,或预先创建 Secret 并配置 pd.auth.existingSecret、server.auth.admin.existingSecret
和 server.auth.token.existingSecret。existingSecret 高于内联值,chart 不管理这类外部 Secret。
管理员密码需要可打印 ASCII,不能包含空格、冒号、反斜杠;PD 密码需要可打印 ASCII,不能包含首尾空白和反斜杠;JWT key 至少 32 字节。
离线渲染器不能通过 lookup 读取在线已生成 Secret,因此不能依赖每次渲染随机生成凭据。
管理员 Secret 是初始凭据,更新 Secret 不会修改已经创建的账户密码。
先使用旧密码调用 PUT /graphspaces/DEFAULT/auth/users/admin,请求体为 {"user_password":"<新密码>"},
再把 Secret 和源配置同步为新密码,最后重启 Server Deployment 清理所有副本的鉴权缓存。
Hubble 默认开启,当前镜像的登录仍依赖 Server 鉴权。只使用 API 可以设置 hubble.enabled=false,
如需关闭 API 鉴权,再设置 server.auth.enabled=false。未使用的凭据配置可以留在 values 中。
可选引擎的原生入口始终需要登录,easy 模式也不例外。新生成的独立管理员密码在 easy 模式下为 6 位随机字母数字,strict 模式下为 16 位。
SeaTunnel 使用 HTTP Basic,Vermeer 使用 <release>-vermeer-admin Secret 与 Admin credential 登录。
升级保留既有密码,切换模式也不会自动轮换。
Vermeer 管理密码可通过 vermeer.auth.admin.password 或 vermeer.auth.admin.existingSecret/key 配置,仅 Master 读取。
原生管理按最终 Service 类型访问:NodePort 直接通过节点 IP 和分配端口访问,ClusterIP 使用 port-forward 转发,Hubble 的服务凭据自动配置。
高级:Vermeer 部署凭据与 GitOps
GitOps 需保留稳定的管理员凭据和独立的内部服务身份。
服务签名因子通过 vermeer.auth.value 或 vermeer.auth.existingSecret/key 配置,Hubble 自动生成服务令牌;
日常 Hubble 使用和原生密码登录都不需要手工获取该令牌。
更改外部管理密码 Secret 只需重启 Master;服务签名因子轮换需重启 Master 与 Hubble,无需重启 Worker。
Worker Schema 读取默认复用部署管理员,也可通过 vermeer.hugegraphCredentials.existingSecret/key 指向现有用户的受保护用户名密码 JSON。
该用户需具备目标图的 Schema 权限,Chart 不会自动创建账户。
5 升级和验证
使用 Helm 原生值复用保留已有部署的 UI、入口、存储和凭据设置。
已有配置中的显式 helper 镜像也会保留。添加 --set-string store.waitImage= --set-string server.waitImage= 可清空覆盖并复用组件镜像。
要采用新的默认值,先审阅已有配置,再使用 --reset-values 和保留镜像、凭据、存储、拓扑设置的配置文件。
PD 成员、持久存储和共享凭据变更需要按生命周期说明协调处理。
基于当前 master 构建的 PD、Store 和 Server 镜像以 UID/GID 10001 运行。除非 podSecurityContext 已设置 fsGroup,Chart 会为 PD 和 Store Pod 设置
fsGroup: 10001(以及 fsGroupChangePolicy: OnRootMismatch),即使 --reuse-values 保留了旧 Release 的空值也是如此,使其能写入旧镜像(以 root 运行)创建的 PVC。
请在首次应用 fsGroup 的同一次滚动更新中,将 PD 和 Store 切换到基于此版本构建的镜像,使 kubelet 在 10001 镜像启动前修改卷的属主。不要先用仍以 root
运行的镜像(例如尚未更新到此版本的 latest)运行此 Chart:这些镜像创建的文件归 root 所有,而 OnRootMismatch 只检查卷的根目录,之后不会再修正它们。
请将 pd.image 和 store.image 固定为基于此版本构建的镜像,而不要依赖 latest。非空的 image.digest 优先于 image.tag,且 --reuse-values
会保留已有的 digest,因此按 digest 固定镜像的 Release 必须修改 digest,而不能只修改标签。
如果 Release 已在设置了 fsGroup 的情况下运行过 root 镜像,请在首次滚动更新到 10001 镜像的同时执行一次递归属主变更。请在同一条命令中设置镜像,
使递归变更作用于 10001 镜像,而不是已固定的 root 镜像。示例清空了保留下来的 digest,使标签生效;按 digest 固定镜像的 Release 应改为将 pd.image.digest
和 store.image.digest 设为此版本镜像的 digest:
改回原策略前,请确认每个 PD 和 Store Pod 运行的都是你设置的 10001 镜像,而不是旧的 root 镜像:
--reuse-values 会保留 Always,而它会在每次 Pod 启动时遍历整个卷,因此请在这些 Pod 运行后改回原策略:
CSI 驱动忽略 fsGroup 的卷(例如许多 NFS 驱动)和 hostPath 卷需要改为执行一次 chown -R 10001:10001。
server.storageWaitTimeoutSeconds 默认 300,通过 WAIT_STORAGE_TIMEOUT_S 传给启动脚本。
未指定的启动探针阈值按存储等待加 150 秒推导;显式探针不会被改写,但预算必须覆盖存储等待和至少 120 秒 Server 启动时间。
矛盾预算会在渲染时报出对应参数。这个等待超时不是 JVM 内存配置。
默认 helm test hook 检查连接和读取。安装或恢复后,还应重新登录 UI,并验证应用实际使用的读写查询。
调度、NetworkPolicy、滚动升级和恢复见 Kubernetes 运维。
6 部署与使用 SeaTunnel(可选引擎)
SeaTunnel 是 HugeGraph 支持的可选数据集成引擎,默认关闭。启用后,Helm 会在集群内拉起常驻的 SeaTunnel Zeta 引擎及任务 Web 前端。
官方 apache/seatunnel:3.0.0 镜像已内置 HugeGraph 连接器(Source 与 Sink),无需额外构建镜像或安装插件。
flowchart TB
    A["外部数据源 / 远端源图"] --> ST
    subgraph Release["同一个 Helm Release"]
        ST["SeaTunnel Zeta<br/>Hybrid 混合节点"] -->|读写| HG["HugeGraph<br/>Server + PD + Store"]
    end
U["管理人员"] -->|Web UI / REST (HTTP Basic)| ST6.1 选择单机或集群模式
SeaTunnel 采用 Hybrid 节点架构,单个节点同时负责作业协调调度与任务执行:
- 单机模式(Standalone):启动 1 个常驻节点,内存占用小,适合开发测试与小规模数据处理。
- 集群模式(Cluster):启动多个同构节点组成集群,支持分布式高可用和更大吞吐。
SeaTunnel 的副本规模与 HugeGraph 拓扑完全独立解耦。在解压包目录(或源码根目录)下,可通过组合 values 快速安装:
若为已有 HugeGraph 集群追加 SeaTunnel,只需在现有 values 中加入 seatunnel.enabled: true 及相应模式配置,执行 helm upgrade 即可,无需重建已有图服务。SeaTunnel 镜像体积较大,建议在离线环境提前同步至私有镜像仓库。
6.2 访问 Web 控制台与鉴权
seatunnel.service.type: null 时继承全局 mode:easy 默认 NodePort,strict 默认 ClusterIP。
显式 ClusterIP 保持私有;显式 NodePort(包括 strict 模式)开放 HTTP/UI,仍需正常登录。
旧配置显式指定 ClusterIP 时,需改回 null 才会继承 easy;省略 seatunnel.service.nodePort 或设为 null 时自动分配端口。
standalone / cluster 拓扑不改变上述访问选择:
SeaTunnel 前端及 REST API 在两种模式下均需独立的 HTTP Basic 认证,与 HugeGraph 账户体系相互独立。
用户名为 admin;新生成密码在 easy 下为 6 位随机字母数字,strict 下为 16 位,升级与模式切换保留既有密码。
从 release 的 Secret 读取密码:
端口 5801 为 Zeta 内部通信与 CLI 命令通道,不经过 HTTP Basic 鉴权,继续保持私有。
对外仅通过分配的 NodePort 访问需要登录的 HTTP Service,应用仍监听 8080。
6.3 运行内置示例作业
Chart 在 SeaTunnel Pod 内预置了连接 HugeGraph 的示例作业,并通过环境变量自动注入了当前 Release 内的 Server 地址、图空间及认证凭据:
准备图实例:在 Hubble 控制台或通过 REST API 创建空的测试图(默认为
DEFAULT/graph_a)。执行导入作业:向图中的
seatunnel_demo_person标签批量写入 10 条数据:执行读取验证:运行 Source 示例读取同一批顶点,并在控制台日志中查看输出:
作业执行状态可进入 Web 控制台实时查看 DAG 拓扑与指标统计。如需修改目标图或连接凭据,可在 values 的 seatunnel.env 中覆盖环境变量,或在 seatunnel.config 中挂载自定义的 .conf 配置文件。
6.4 跨图迁移与模式切换
- 拓扑切换:单机与集群模式切换时直接修改 values 并执行
helm upgrade。切换会重置引擎进程,建议在所有批处理任务完成后再执行。 - 跨图整库迁移:建议遵循 Schema 元数据 → 顶点数据 → 边数据 的标准顺序。可参考
examples/seatunnel/clone/下的自动化脚本与配置模板。迁移含有DATE类型字段时,务必在 Sink 配置中显式指定与源端 Server 相同的时区(如timeZone = "UTC"),避免跨时区解析偏差。详细配置可参阅 SeaTunnel 导出与迁移文档。