跳转到主要内容

使用 SeaTunnel Source 导出与迁移图数据

如果你需要把数据从一张 HugeGraph 图复制到另一张图,使用 graph2graph:HugeGraph Source 从源图(A 图)读取顶点和边,数据经过可选的 Transform 后,由 HugeGraph Sink 写入目标图(B 图)。数据方向是 A 图 → HugeGraph Source →(可选 Transform)→ HugeGraph Sink → B 图。如果要把图数据导出到文件、JDBC、Kafka 等其他系统,则使用 graph2any,由下游 Sink 接收 Source 读取的数据。本文介绍这两类任务。

版本要求:本文面向 SeaTunnel 3.0+

SeaTunnel 3.0+ 提供 HugeGraph Source,支持图模型自动发现和多标签读取。 并行扫描的后端要求和配置限制见官方 Source 文档。

开始前请先完成导入页中的通用环境准备和配置,其中包含 JDK、HOCON、插件安装和图模型说明。

1 迁移 HugeGraph 图(graph2graph)

下面从源图迁移 person 顶点和 knows 边。请使用独立的目标图:本节采用 CUSTOMIZE_STRING 保留顶点 ID,不要复用前面已经创建为 PRIMARY_KEY 的 person 标签。

这两个任务只迁移指定标签和属性,不会完整复制源图的索引、TTL 等全部 Schema 配置。运行期间应暂停源图写入,避免两个任务读到不同时间的数据;完成后核对顶点、边数量及抽样属性。
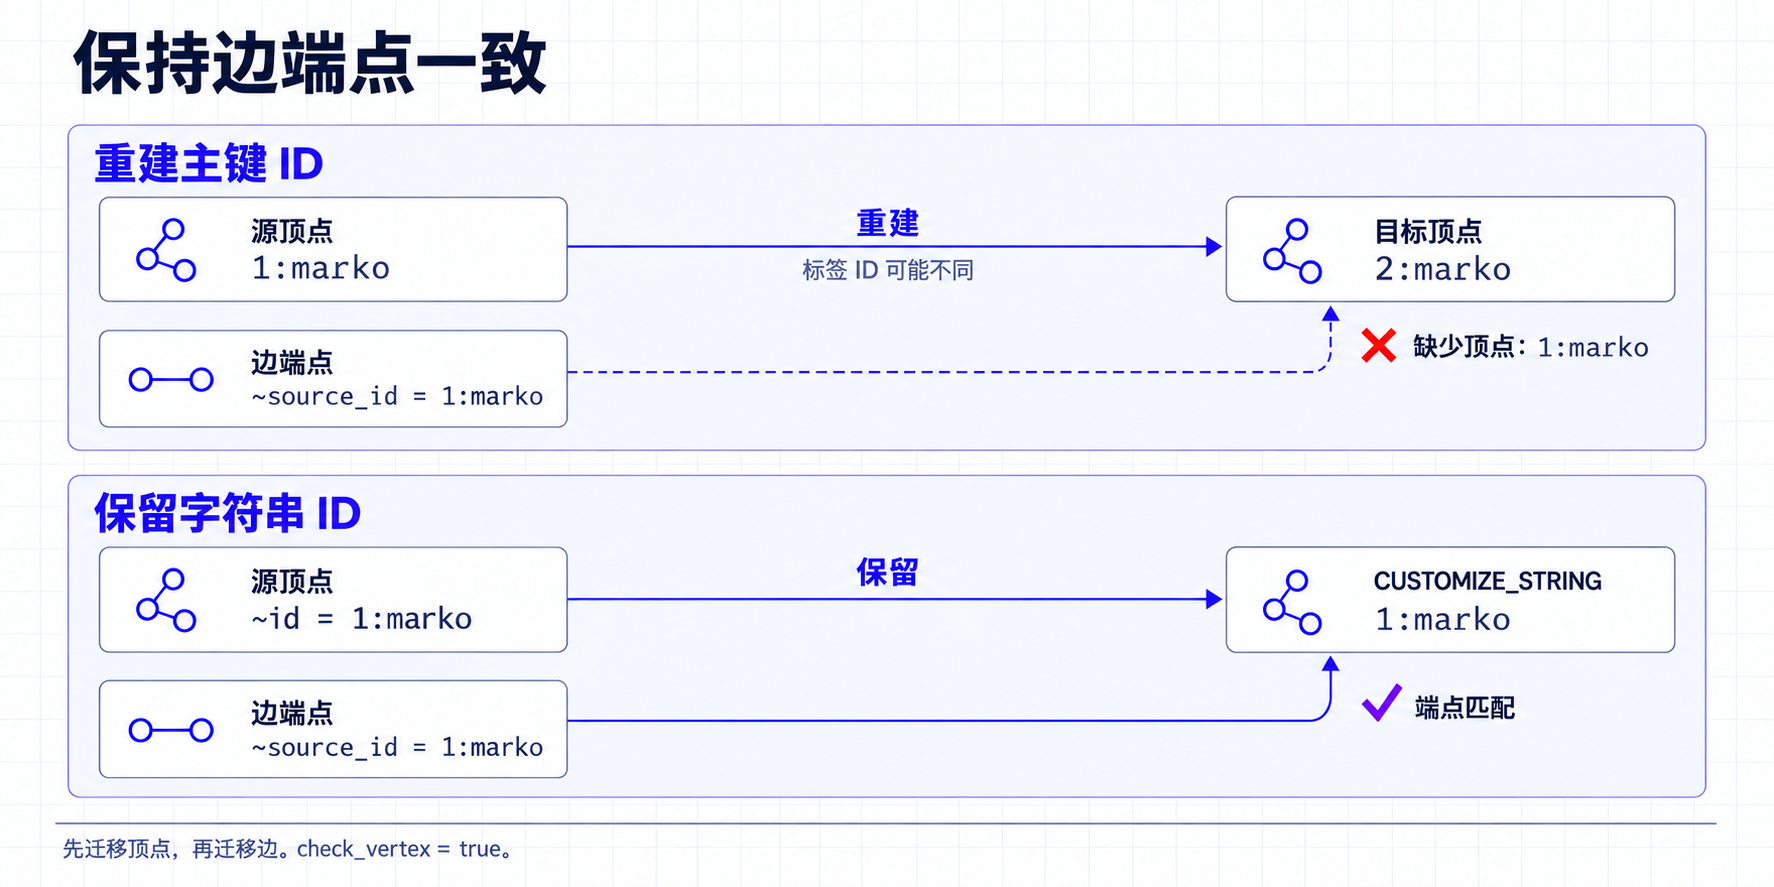
跨图迁移时重建主键可能改变顶点 ID;使用 CUSTOMIZE_STRING 保留原 ID,确保边端点匹配

1.1 先迁移顶点

Source 自动补充 ~id 保留列,Sink 把原 ID 作为字符串保存。无需在 schema.fields 中声明 ~id,手动声明保留列会被拒绝。

展开配置,保存为 config/graph2graph-person.conf
 1env {
 2  job.mode = "BATCH"
 3}
 4
 5source {
 6  HugeGraph {
 7    host = "source-hugegraph"
 8    port = 8080
 9    graph_name = "hugegraph"
10    graph_space = "DEFAULT"
11    label = "person"
12    label_type = "VERTEX"
13    schema = {
14      fields = {
15        name = "string"
16        age = "int"
17      }
18    }
19  }
20}
21
22sink {
23  HugeGraph {
24    host = "target-hugegraph"
25    port = 8080
26    graph_name = "hugegraph"
27    graph_space = "DEFAULT"
28    batch_failure_fallback = false
29    mappings = [
30      {
31        type = "VERTEX"
32        label = "person"
33        idStrategy = "CUSTOMIZE_STRING"
34        idFields = ["~id"]
35        properties = ["name", "age"]
36      }
37    ]
38  }
39}
1./bin/seatunnel.sh --config ./config/graph2graph-person.conf -m local

1.2 再迁移边

确认顶点任务成功后,使用 Source 自动补充的 ~source_id 和 ~target_id 定位端点。因为上一任务保留了原 ID,这两列可以直接引用目标图中的顶点。

展开配置,保存为 config/graph2graph-knows.conf
 1env {
 2  job.mode = "BATCH"
 3}
 4
 5source {
 6  HugeGraph {
 7    host = "source-hugegraph"
 8    port = 8080
 9    graph_name = "hugegraph"
10    graph_space = "DEFAULT"
11    label = "knows"
12    label_type = "EDGE"
13    schema = {
14      fields = {
15        since = "int"
16      }
17    }
18  }
19}
20
21sink {
22  HugeGraph {
23    host = "target-hugegraph"
24    port = 8080
25    graph_name = "hugegraph"
26    graph_space = "DEFAULT"
27    check_vertex = true
28    batch_failure_fallback = false
29    mappings = [
30      {
31        type = "EDGE"
32        label = "knows"
33        sourceConfig = {
34          label = "person"
35          idFields = ["~source_id"]
36        }
37        targetConfig = {
38          label = "person"
39          idFields = ["~target_id"]
40        }
41        properties = ["since"]
42      }
43    ]
44  }
45}
1./bin/seatunnel.sh --config ./config/graph2graph-knows.conf -m local

本例打开端点检查,并让写入错误直接导致任务失败。默认的 check_vertex = false 不保证最终一致:缺少端点可能产生悬空边,因此不能用任务成功代替迁移结果检查。

为什么保留 ID? HugeGraph 的 PRIMARY_KEY ID 包含顶点标签的内部 ID,两张图可能不同。例如源图顶点是 1:marko,目标图重新按主键生成的可能是 2:marko。如果重新生成顶点 ID 后仍复用源图的边端点,边就会连错。本例将原 ID 保存为字符串,因此会改变目标图的 ID 策略

若要一次读取全部标签,省略 Source 的 label 后会读取 label_type(默认 VERTEX)下的全部 label,每个 label 输出一张表。这时需用 sourceTable 将各 Sink 映射绑定到对应表,例如 sourceTable = "default.person";具体值以 Writer 日志中的完整表名为准。不能直接套用本节的单标签配置。其他限制见 HugeGraph Source 文档。

2 导出到其他系统(graph2any)

graph2any 使用 HugeGraph Source[1] 读取顶点或边,再交给下游 Sink。下面示例将 person 顶点导出为本地 JSON 文件;导出到 JDBC、Kafka 等系统时,替换 LocalFile[2] 及其配置即可。

 1env {
 2  job.mode = "BATCH"
 3}
 4
 5source {
 6  HugeGraph {
 7    host = "hugegraph"
 8    port = 8080
 9    graph_name = "hugegraph"
10    graph_space = "DEFAULT"
11    label = "person"
12    label_type = "VERTEX"
13    schema = {
14      fields = {
15        name = "string"
16        age = "int"
17      }
18    }
19  }
20}
21
22sink {
23  LocalFile {
24    path = "/tmp/hugegraph-export/${table_name}"
25    file_format_type = "json"
26  }
27}

保存为 config/graph2file-person.conf,在 SeaTunnel 安装目录执行:

1./bin/seatunnel.sh --config ./config/graph2file-person.conf -m local

导出边时,将 Source 的 label 改为边标签、label_type 改为 EDGE,并在 schema.fields 中声明边属性。Source 会额外输出 ~source_id、~source_label、~target_id 和 ~target_label,这些保留列可直接写入文件或交给下游转换步骤。

本页只介绍数据行的读取和写出,不会自动复制源图的索引、TTL 或其他 Schema 设置。完整 Source 参数和通用环境说明请回到SeaTunnel 图导入文档[3]。

3 参考文档

连接器

[1] HugeGraph Source
[2] LocalFile Sink

关联文档

[3] SeaTunnel 图导入文档