这是本节的多页打印视图。 .
GUIDES
1 - HugeGraph Architecture Overview
1 概述
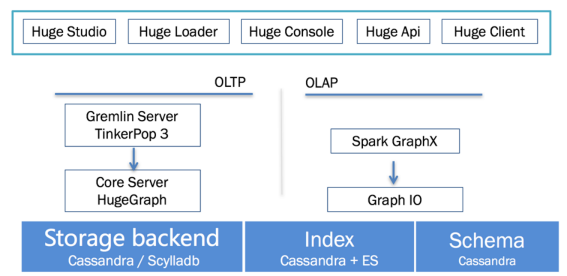
作为一款通用的图数据库产品,HugeGraph需具备图数据的基本功能,如下图所示。HugeGraph包括三个层次的功能,分别是存储层、计算层和用户接口层。 HugeGraph支持OLTP和OLAP两种图计算类型,其中OLTP实现了Apache TinkerPop3框架,并支持Gremlin查询语言。 OLAP计算是基于SparkGraphX实现。
2 组件
HugeGraph的主要功能分为HugeCore、ApiServer、HugeGraph-Client、HugeGraph-Loader和HugeGraph-Studio等组件构成,各组件之间的通信关系如下图所示。
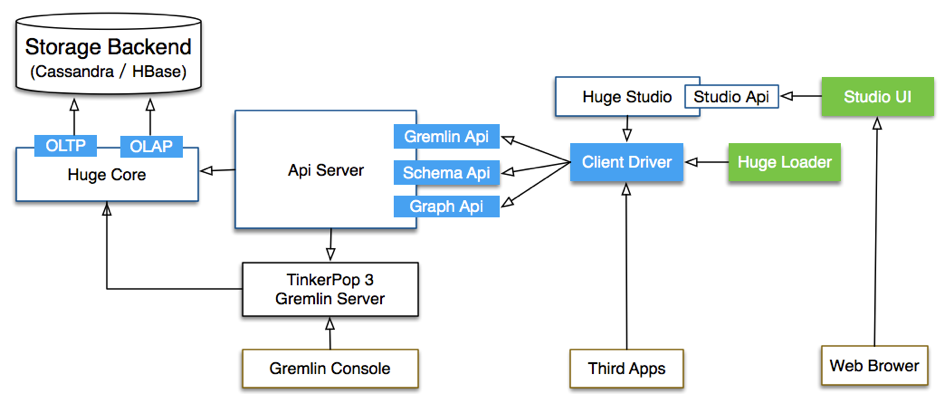
- HugeCore :HugeGraph的核心模块,TinkerPop的接口主要在该模块中实现。HugeCore的功能涵盖包括OLTP和OLAP两个部分。
- ApiServer :提供RESTFul Api接口,对外提供Graph Api、Schema Api和Gremlin Api等接口服务。
- HugeGraph-Client:基于Java客户端驱动程序。HugeGraph-Client是Java版本客户端驱动程序,后续可根据需要提供Python、Go、C++等多语言支持。
- HugeGraph-Loader:数据导入模块。HugeGraph-Loader可以扫描并分析现有数据,自动生成Graph Schema创建语言,通过批量方式快速导入数据。
- HugeGraph-Studio:基于Web的可视化IDE环境。以Notebook方式记录Gremlin查询,可视化展示Graph的关联关系。HugeGraph-Studio也是本系统推荐的工具。
- HugeGraph-Computer:HugeGraph-Computer是一个分布式图处理系统 (OLAP)。
2 - HugeGraph Design Concepts
1. Property Graph
常见的图数据表示模型有两种,分别是RDF(Resource Description Framework)模型和属性图(Property Graph)模型。 RDF和Property Graph都是最基础、最有名的图表示模式,都能够表示各种图的实体关系建模。 RDF是W3C标准,而Property Graph是工业标准,受到广大图数据库厂商的广泛支持。HugeGraph目前采用Property Graph。
HugeGraph对应的存储概念模型也是参考Property Graph而设计的,具体示例详见下图:(此图为旧版设计已过时,请忽略它,后续更新)
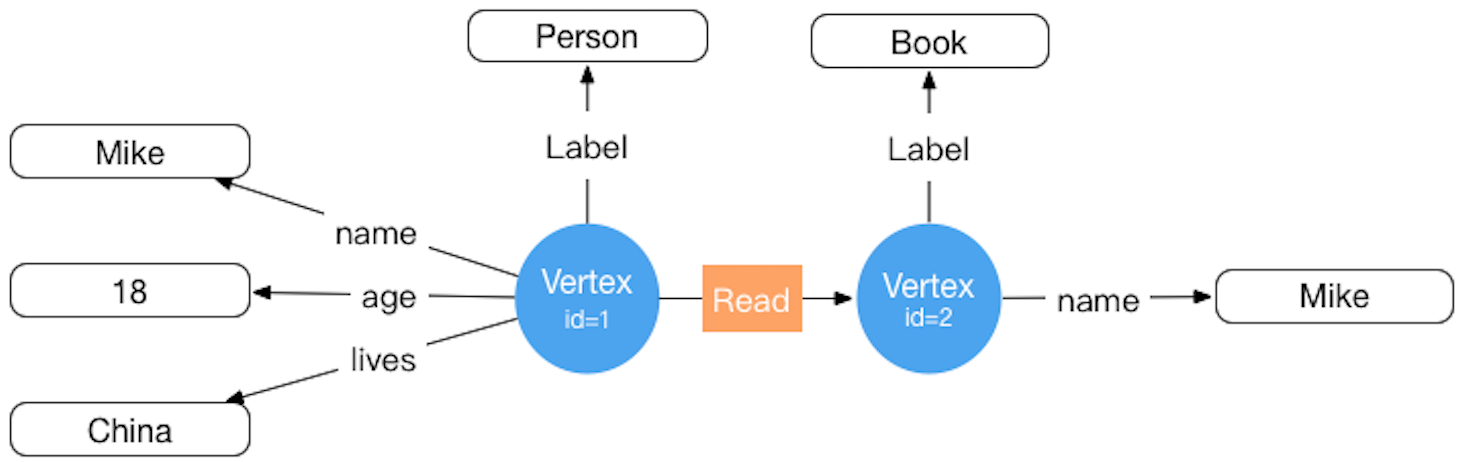
在HugeGraph内部,每个顶点 / 边由唯一的 VertexId / EdgeId 标识,属性存储在对应点 / 边内部。而顶点与顶点之间的关系 / 映射则是通过边来存储的。
顶点属性值通过边指针方式存储时,如果要更新一个顶点特定的属性值直接通过覆盖写入即可,其弊端是冗余存储了VertexId; 如果要更新关系的属性需要通过read-and-modify方式,先读取所有属性,修改部分属性,然后再写入存储系统,更新效率较低。 从经验来看顶点属性的修改需求较多,而边的属性修改需求较少,例如PageRank和Graph Cluster等计算都需要频繁修改顶点的属性值。
2. 图分区方案
对于分布式图数据库而言,图的分区存储方式有两种:分别是边分割存储(Edge Cut)和点分割存储(Vertex Cut),如下图所示。 使用Edge Cut方式存储图时,任何一个顶点只会出现在一台机器上,而边可能分布在不同机器上,这种存储方式有可能导致边多次存储。 使用Vertex Cut方式存储图时,任何一条边只会出现在一台机器上,而每相同的一个点可能分布到不同机器上,这种存储方式可能会导致顶点多次存储。
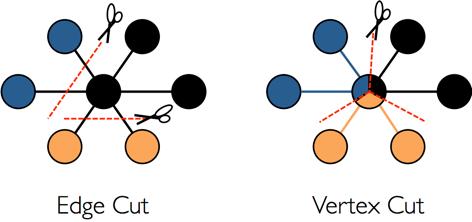
采用EdgeCut分区方案可以支持高性能的插入和更新操作,而VertexCut分区方案更适合静态图查询分析,因此EdgeCut适合OLTP图查询,VertexCut更适合OLAP的图查询。 HugeGraph目前采用EdgeCut的分区方案。
3. VertexId 策略
HugeGraph的Vertex支持三种ID策略,在同一个图数据库中不同的VertexLabel可以使用不同的Id策略,目前HugeGraph支持的Id策略分别是:
- 自动生成(AUTOMATIC):使用Snowflake算法自动生成全局唯一Id,Long类型;
- 主键(PRIMARY_KEY):通过VertexLabel+PrimaryKeyValues生成Id,String类型;
- 自定义(CUSTOMIZE_STRING|CUSTOMIZE_NUMBER):用户自定义Id,分为String和Long类型两种,需自己保证Id的唯一性;
默认的Id策略是AUTOMATIC,如果用户调用primaryKeys()方法并设置了正确的PrimaryKeys,则自动启用PRIMARY_KEY策略。 启用PRIMARY_KEY策略后HugeGraph能根据PrimaryKeys实现数据去重。
- AUTOMATIC ID策略
- PRIMARY_KEY ID策略
- CUSTOMIZE_STRING ID策略
- CUSTOMIZE_NUMBER ID策略
如果用户需要Vertex去重,有三种方案分别是:
- 采用PRIMARY_KEY策略,自动覆盖,适合大数据量批量插入,用户无法知道是否发生了覆盖行为
- 采用AUTOMATIC策略,read-and-modify,适合小数据量插入,用户可以明确知道是否发生覆盖
- 采用CUSTOMIZE_STRING或CUSTOMIZE_NUMBER策略,用户自己保证唯一
4. EdgeId 策略
HugeGraph的EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合而成。其中sortKey是HugeGraph的一个重要概念。
在Edge中加入sortKey作为Edge的唯一标识的原因有两个:
- 如果两个顶点之间存在多条相同Label的边可通过
sortKey来区分 - 对于SuperNode的节点,可以通过
sortKey来排序截断。
由于EdgeId是由srcVertexId+edgeLabel+sortKey+tgtVertexId四部分组合,多次插入相同的Edge时HugeGraph会自动覆盖以实现去重。
需要注意的是如果批量插入模式下Edge的属性也将会覆盖。
另外由于HugeGraph的EdgeId采用自动去重策略,对于self-loop(一个顶点存在一条指向自身的边)的情况下HugeGraph认为仅有一条边,对于采用AUTOMATIC策略的图数据库(例如TitianDB )则会认为该图存在两条边。
HugeGraph的边仅支持有向边,无向边可以创建Out和In两条边来实现。
5. HugeGraph transaction overview
TinkerPop事务概述
TinkerPop transaction事务是指对数据库执行操作的工作单元,一个事务内的一组操作要么执行成功,要么全部失败。 详细介绍请参考TinkerPop官方文档:http://tinkerpop.apache.org/docs/current/reference/#transactions
TinkerPop事务操作接口
- open 打开事务
- commit 提交事务
- rollback 回滚事务
- close 关闭事务
TinkerPop事务规范
- 事务必须显式提交后才可生效(未提交时修改操作只有本事务内查询可看到)
- 事务必须打开之后才可提交或回滚
- 如果事务设置自动打开则无需显式打开(默认方式),如果设置手动打开则必须显式打开
- 可设置事务关闭时:自动提交、自动回滚(默认方式)、手动(禁止显式关闭)等3种模式
- 事务在提交或回滚后必须是关闭状态
- 事务在查询后必须是打开状态
- 事务(非threaded tx)必须线程隔离,多线程操作同一事务互不影响
更多事务规范用例见:Transaction Test
HugeGraph事务实现
- 一个事务中所有的操作要么成功要么失败
- 一个事务只能读取到另外一个事务已提交的内容(Read committed)
- 所有未提交的操作均能在本事务中查询出来,包括:
- 增加顶点能够查询出该顶点
- 删除顶点能够过滤掉该顶点
- 删除顶点能够过滤掉该顶点相关边
- 增加边能够查询出该边
- 删除边能够过滤掉该边
- 增加/修改(顶点、边)属性能够在查询时生效
- 删除(顶点、边)属性能够在查询时生效
- 所有未提交的操作在事务回滚后均失效,包括:
- 顶点、边的增加、删除
- 属性的增加/修改、删除
示例:一个事务无法读取另一个事务未提交的内容
事务实现原理
- 服务端内部通过将事务与线程绑定实现隔离(ThreadLocal)
- 本事务未提交的内容按照时间顺序覆盖老数据以供本事务查询最新版本数据
- 底层依赖后端数据库保证事务原子性操作(如Cassandra/RocksDB的batch接口均保证原子性)
注意
RESTful API暂时未暴露事务接口
TinkerPop API允许打开事务,请求完成时会自动关闭(Gremlin Server强制关闭)
3 - HugeGraph Plugin机制及插件扩展流程
背景
- HugeGraph不仅开源开放,而且要做到简单易用,一般用户无需更改源码也能轻松增加插件扩展功能。
- HugeGraph支持多种内置存储后端,也允许用户无需更改现有源码的情况下扩展自定义后端。
- HugeGraph支持全文检索,全文检索功能涉及到各语言分词,目前已内置8种中文分词器,也允许用户无需更改现有源码的情况下扩展自定义分词器。
可扩展维度
目前插件方式提供如下几个维度的扩展项:
- 后端存储
- 序列化器
- 自定义配置项
- 分词器
插件实现机制
- HugeGraph提供插件接口HugeGraphPlugin,通过Java SPI机制支持插件化
- HugeGraph提供了4个扩展项注册函数:
registerOptions()、registerBackend()、registerSerializer()、registerAnalyzer() - 插件实现者实现相应的Options、Backend、Serializer或Analyzer的接口
- 插件实现者实现HugeGraphPlugin接口的
register()方法,在该方法中注册上述第3点所列的具体实现类,并打成jar包 - 插件使用者将jar包放在HugeGraph Server安装目录的
plugins目录下,修改相关配置项为插件自定义值,重启即可生效
插件实现流程实例
1 新建一个maven项目
1.1 项目名称取名:hugegraph-plugin-demo
1.2 添加hugegraph-core Jar包依赖
maven pom.xml详细内容如下:
2 实现扩展功能
2.1 扩展自定义后端
2.1.1 实现接口BackendStoreProvider
- 可实现接口:
com.baidu.hugegraph.backend.store.BackendStoreProvider - 或者继承抽象类:
com.baidu.hugegraph.backend.store.AbstractBackendStoreProvider
以RocksDB后端RocksDBStoreProvider为例:
2.1.2 实现接口BackendStore
BackendStore接口定义如下:
2.1.3 扩展自定义序列化器
序列化器必须继承抽象类:com.baidu.hugegraph.backend.serializer.AbstractSerializer(implements GraphSerializer, SchemaSerializer)
主要接口的定义如下:
2.1.4 扩展自定义配置项
增加自定义后端时,可能需要增加新的配置项,实现流程主要包括:
- 增加配置项容器类,并实现接口
com.baidu.hugegraph.config.OptionHolder - 提供单例方法
public static OptionHolder instance(),并在对象初始化时调用方法OptionHolder.registerOptions() - 增加配置项声明,单值配置项类型为
ConfigOption、多值配置项类型为ConfigListOption
以RocksDB配置项定义为例:
2.2 扩展自定义分词器
分词器需要实现接口com.baidu.hugegraph.analyzer.Analyzer,以实现一个SpaceAnalyzer空格分词器为例。
3. 实现插件接口,并进行注册
插件注册入口为HugeGraphPlugin.register(),自定义插件必须实现该接口方法,在其内部注册上述定义好的扩展项。
接口com.baidu.hugegraph.plugin.HugeGraphPlugin定义如下:
并且HugeGraphPlugin提供了4个静态方法用于注册扩展项:
- registerOptions(String name, String classPath):注册配置项
- registerBackend(String name, String classPath):注册后端(BackendStoreProvider)
- registerSerializer(String name, String classPath):注册序列化器
- registerAnalyzer(String name, String classPath):注册分词器
下面以注册SpaceAnalyzer分词器为例:
4. 配置SPI入口
- 确保services目录存在:hugegraph-plugin-demo/resources/META-INF/services
- 在services目录下建立文本文件:com.baidu.hugegraph.plugin.HugeGraphPlugin
- 文件内容如下:com.baidu.hugegraph.plugin.DemoPlugin
5. 打Jar包
通过maven打包,在项目目录下执行命令mvn package,在target目录下会生成Jar包文件。
使用时将该Jar包拷到plugins目录,重启服务即可生效。
4 - Backup Restore
描述
Backup 和 Restore 是备份图和恢复图的功能。备份和恢复的数据包括元数据(schema)和图数据(vertex 和 edge)。
Backup
将 HugeGraph 系统中的一张图的元数据和图数据以 JSON 格式导出。
Restore
将 Backup 导出的JSON格式的数据,重新导入到 HugeGraph 系统中的一个图中。
Restore 有两种模式:
- Restoring 模式,将 Backup 导出的元数据和图数据原封不动的恢复到 HugeGraph 系统中。可用于图的备份和恢复,一般目标图是新图(没有元数据和图数据)。比如:
- 系统升级,先备份图,然后升级系统,最后将图恢复到新的系统中
- 图迁移,从一个 HugeGraph 系统中,使用 Backup 功能将图导出,然后使用 Restore 功能将图导入另一个 HugeGraph 系统中
- Merging 模式,将 Backup 导出的元数据和图数据导入到另一个已经存在元数据或者图数据的图中,过程中元数据的 ID 可能发生改变,顶点和边的 ID 也会发生相应变化。
- 可用于合并图
使用方法
可以使用hugegraph-tools进行图的备份和恢复。
Backup
该命令将 http://127.0.0.1 的 hugegraph 图的全部元数据和图数据备份到data目录下。
Backup 在三种图模式下都可以正常工作
Restore
Restore 有两种模式: RESTORING 和 MERGING,备份之前首先要根据需要设置图模式。
步骤1:查看并设置图模式
该命令用于查看当前图模式,包括:NONE、RESTORING、MERGING。
该命令用于设置图模式,Restore 之前可以设置成 RESTORING 或者 MERGING 模式,例子中设置成 RESTORING。
步骤2:Restore 数据
该命令将data目录下的全部元数据和图数据重新导入到 http://127.0.0.1 的 hugegraph 图中。
步骤3:恢复图模式
该命令用于恢复图模式为 NONE。
至此,一次完整的图备份和图恢复流程结束。
帮助
备份和恢复命令的详细使用方式可以参考hugegraph-tools文档。
Backup/Restore使用和实现的API说明
Backup
Backup 使用元数据和图数据的相应的 list(GET) API 导出,并未增加新的 API。
Restore
Restore 使用元数据和图数据的相应的 create(POST) API 导入,并未增加新的 API。
Restore 时存在两种不同的模式: Restoring 和 Merging,另外,还有常规模式 NONE(默认),区别如下:
- None 模式,元数据和图数据的写入属于正常状态,可参见功能说明。特别的:
- 元数据(schema)创建时不允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,不允许指定 ID
- Restoring 模式,恢复到一个新图中,特别的:
- 元数据(schema)创建时允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,允许指定 ID
- Merging 模式,合并到一个已存在元数据和图数据的图中,特别的:
- 元数据(schema)创建时不允许指定 ID
- 图数据(vertex)在 id strategy 为 Automatic 时,允许指定 ID
正常情况下,图模式为 None,当需要 Restore 图时,需要根据需要临时修改图模式为 Restoring 模式或者 Merging 模式,并在完成 Restore 时,恢复图模式为 None。
实现的设置图模式的 RESTful API 如下:
查看某个图的模式. 该操作需要管理员权限
Method & Url
Response Status
Response Body
合法的图模式包括:NONE,RESTORING,MERGING
设置某个图的模式. 该操作需要管理员权限
Method & Url
Request Body
合法的图模式包括:NONE,RESTORING,MERGING
Response Status
Response Body
5 - FAQ
如何选择后端存储? 选 RocksDB 还是 Cassandra 还是 Hbase 还是 Mysql?
根据你的具体需要来判断, 一般单机或数据量 < 100 亿推荐 RocksDB, 其他推荐使用分布式存储的后端集群
启动服务时提示:
xxx (core dumped) xxx请检查JDK版本是否为1.8
启动服务成功了,但是操作图时有类似于"无法连接到后端或连接未打开"的提示
第一次启动服务前,需要先使用
init-store初始化后端,后续版本会将提示得更清晰直接。所有的后端在使用前都需要执行
init-store吗,序列化的选择可以随意填写么?除了
memory不需要,其他后端均需要,如:cassandra、hbase和rocksdb等,序列化需一一对应不可随意填写。执行
init-store报错:Exception in thread "main" java.lang.UnsatisfiedLinkError: /tmp/librocksdbjni3226083071221514754.so: /usr/lib64/libstdc++.so.6: version `GLIBCXX_3.4.10' not found (required by /tmp/librocksdbjni3226083071221514754.so)RocksDB需要 gcc 4.3.0 (GLIBCXX_3.4.10) 及以上版本
执行
init-store.sh时报错:NoHostAvailableExceptionNoHostAvailableException是指无法连接到Cassandra服务,如果确定是要使用cassandra后端,请先安装并启动这个服务。至于这个提示本身可能不够直白,我们会更新到文档进行说明的。bin目录下包含start-hugegraph.sh、start-restserver.sh和start-gremlinserver.sh三个似乎与启动有关的脚本,到底该使用哪个自0.3.3版本以来,已经把 GremlinServer 和 RestServer 合并为 HugeGraphServer 了,使用
start-hugegraph.sh启动即可,后两个在后续版本会被删掉。配置了两个图,名字是
hugegraph和hugegraph1,而启动服务的命令是start-hugegraph.sh,是只打开了hugegraph这个图吗start-hugegraph.sh会打开所有gremlin-server.yaml的graphs下的图,这二者并无名字上的直接关系服务启动成功后,使用
curl查询所有顶点时返回乱码服务端返回的批量顶点/边是压缩(gzip)过的,可以使用管道重定向至
gunzip进行解压(curl http://example | gunzip),也可以用Firefox的postman或者Chrome浏览器的restlet插件发请求,会自动解压缩响应数据。使用顶点Id通过
RESTful API查询顶点时返回空,但是顶点确实是存在的检查顶点Id的类型,如果是字符串类型,
API的url中的id部分需要加上双引号,数字类型则不用加。已经根据需要给顶点Id加上了双引号,但是通过
RESTful API查询顶点时仍然返回空检查顶点id中是否包含
+、空格、/、?、%、&和=这些URL的保留字符,如果存在则需要进行编码。下表给出了编码值:查询某一类别的顶点或边(
query by label)时提示超时由于属于某一label的数据量可能比较多,请加上limit限制。
通过
RESTful API操作图是可以的,但是发送Gremlin语句就报错:Request Failed(500)可能是
GremlinServer的配置有误,检查gremlin-server.yaml的host、port是否与rest-server.properties的gremlinserver.url匹配,如不匹配则修改,然后重启服务。使用
Loader导数据出现Socket Timeout异常,然后导致Loader中断持续地导入数据会使
Server的压力过大,然后导致有些请求超时。可以通过调整Loader的参数来适当缓解Server压力(如:重试次数,重试间隔,错误容忍数等),降低该问题出现频率。如何删除全部的顶点和边,RESTful API中没有这样的接口,调用
gremlin的g.V().drop()会报错Vertices in transaction have reached capacity xxx目前确实没有好办法删除全部的数据,用户如果是自己部署的
Server和后端,可以直接清空数据库,重启Server。可以使用paging API或scan API先获取所有数据,再逐条删除。清空了数据库,并且执行了
init-store,但是添加schema时提示"xxx has existed"HugeGraphServer内是有缓存的,清空数据库的同时是需要重启Server的,否则残留的缓存会产生不一致。插入顶点或边的过程中报错:
Id max length is 128, but got xxx {yyy}或Big id max length is 32768, but got xxx为了保证查询性能,目前的后端存储对id列的长度做了限制,顶点id不能超过128字节,边id长度不能超过32768字节,索引id不能超过128字节。
是否支持嵌套属性,如果不支持,是否有什么替代方案
嵌套属性目前暂不支持。替代方案:可以把嵌套属性作为单独的顶点拿出来,然后用边连接起来。
一个
EdgeLabel是否可以连接多对VertexLabel,比如"投资"关系,可以是"个人"投资"企业",也可以是"企业"投资"企业"一个
EdgeLabel不支持连接多对VertexLabel,需要用户将EdgeLabel拆分得更细一点,如:“个人投资”,“企业投资”。通过
RestAPI发送请求时提示HTTP 415 Unsupported Media Type请求头中需要指定
Content-Type:application/json
其他问题可以在对应项目的 issue 区搜索,例如 Server-Issues / Loader Issues