# v0.4.4
LLMS 索引: [llms.txt](/versions/1.0/cn/llms.txt)
---
### 1 测试环境
被压机器信息
机器编号 | CPU | Memory | 网卡 | 磁盘
--------------------------------- | -------------------------------------------- | ------ | --------- | ------------------
1 | 24 Intel(R) Xeon(R) CPU E5-2620 v2 @ 2.10GHz | 61G | 1000Mbps | 1.4T HDD
2 | 48 Intel(R) Xeon(R) CPU E5-2650 v4 @ 2.20GHz | 128G | 10000Mbps | 750GB SSD,2.7T HDD
- 起压力机器信息:与编号 1 机器同配置
- 测试工具:apache-Jmeter-2.5.1
注:起压机器和被压机器在同一机房
### 2 测试说明
#### 2.1 名词定义(时间的单位均为ms)
- Samples -- 本次场景中一共完成了多少个线程
- Average -- 平均响应时间
- Median -- 统计意义上面的响应时间的中值
- 90% Line -- 所有线程中90%的线程的响应时间都小于xx
- Min -- 最小响应时间
- Max -- 最大响应时间
- Error -- 出错率
- Throughput -- 吞吐量
- KB/sec -- 以流量做衡量的吞吐量
#### 2.2 底层存储
后端存储使用RocksDB,HugeGraph与RocksDB都在同一机器上启动,server相关的配置文件除主机和端口有修改外,其余均保持默认。
### 3 性能结果总结
1. HugeGraph每秒能够处理的请求数目上限是7000
2. 批量插入速度远大于单条插入,在服务器上测试结果达到22w edges/s,37w vertices/s
3. 后端是RocksDB,增大CPU数目和内存大小可以增大批量插入的性能。CPU和内存扩大一倍,性能增加45%-60%
4. 批量插入场景,使用SSD替代HDD,性能提升较小,只有3%-5%
### 4 测试结果及分析
#### 4.1 batch插入
##### 4.1.1 压力上限测试
###### 测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
###### 压力参数
持续时间:5min
###### 顶点和边的最大插入速度(高性能服务器,使用SSD存储RocksDB数据):
 ###### 结论:
- 并发1000,边的吞吐量是是451,每秒可处理的数据:451*500条=225500/s
- 并发2000,顶点的吞吐量是1842.4,每秒可处理的数据:1842.4*200=368480/s
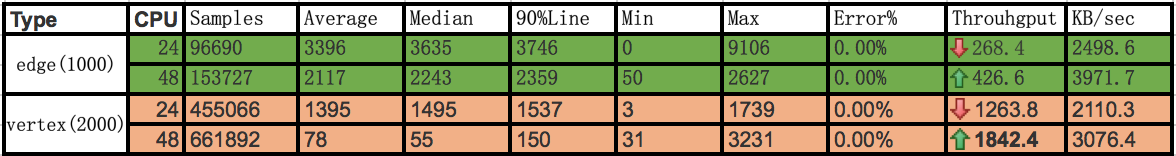
**1\. CPU和内存对插入性能的影响(服务器都使用HDD存储RocksDB数据,批量插入)**
 ###### 结论:
- 同样使用HDD硬盘,CPU和内存增加了1倍
- 边:吞吐量从268提升至426,性能提升了约60%
- 顶点:吞吐量从1263.8提升至1842.4,性能提升了约45%
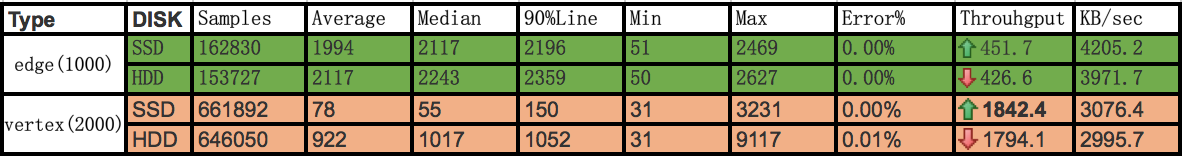
**2\. SSD和HDD对插入性能的影响(高性能服务器,批量插入)**
 ###### 结论:
- 边:使用SSD吞吐量451.7,使用HDD吞吐量426.6,性能提升5%
- 顶点:使用SSD吞吐量1842.4,使用HDD吞吐量1794,性能提升约3%
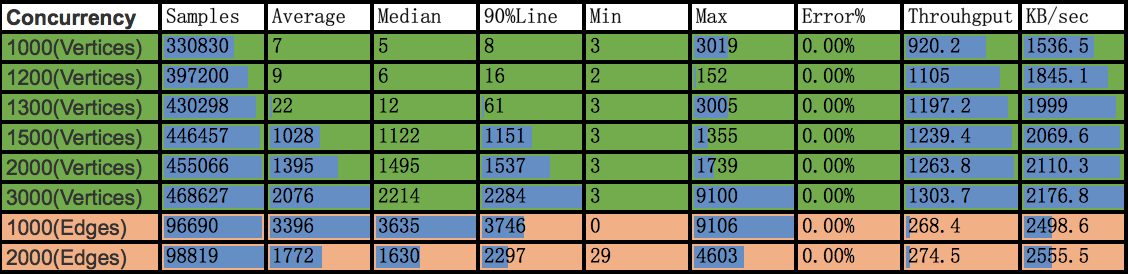
**3\. 不同并发线程数对插入性能的影响(普通服务器,使用HDD存储RocksDB数据)**
 ###### 结论:
- 顶点:1000并发,响应时间7ms和1500并发响应时间1028ms差距悬殊,且吞吐量一直保持在1300左右,因此拐点数据应该在1300 ,且并发1300时,响应时间已达到22ms,在可控范围内,相比HugeGraph 0.2(1000并发:平均响应时间8959ms),处理能力出现质的飞跃;
- 边:从1000并发到2000并发,处理时间过长,超过3s,且吞吐量几乎在270左右浮动,因此继续增大并发线程数吞吐量不会再大幅增长,270 是一个拐点,跟HugeGraph 0.2版本(1000并发:平均响应时间31849ms)相比较,处理能力提升非常明显;
#### 4.2 single插入
##### 4.2.1 压力上限测试
###### 测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
###### 压力参数
- 持续时间:5min
- 服务异常标志:错误率大于0.00%
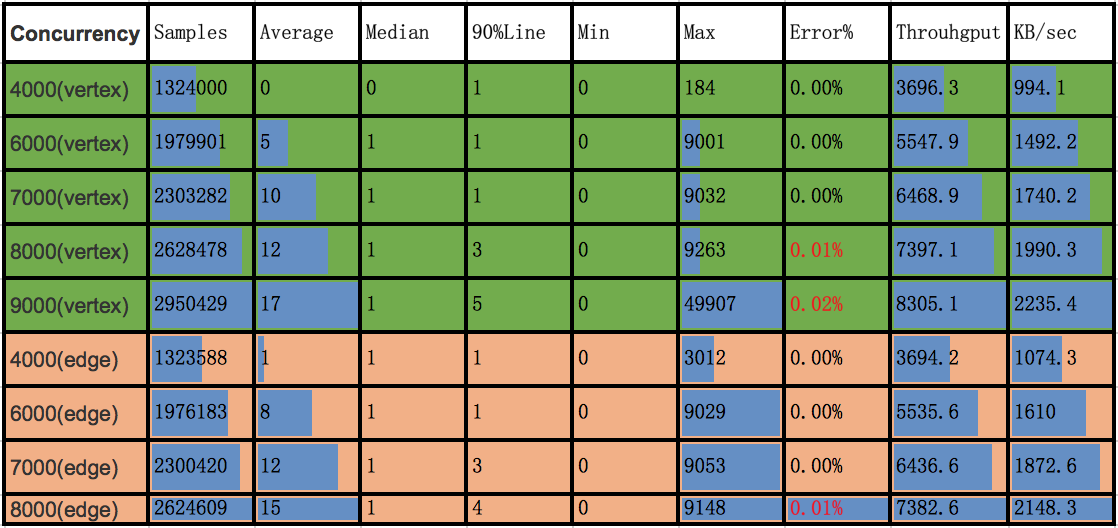 ###### 结论:
- 顶点:
- 4000并发:正常,无错误率,平均耗时小于1ms, 6000并发无错误,平均耗时5ms,在可接受范围内;
- 8000并发:存在0.01%的错误,已经无法处理,出现connection timeout错误,顶峰应该在7000左右
- 边:
- 4000并发:响应时间1ms,6000并发无任何异常,平均响应时间8ms,主要差异在于 IO network recv和send以及CPU);
- 8000并发:存在0.01%的错误率,平均耗15ms,拐点应该在7000左右,跟顶点结果匹配;