这是本节的多页打印视图。 .
PERFORMANCE
1 - HugeGraph BenchMark Performance
1 测试环境
1.1 硬件信息
| CPU | Memory | 网卡 | 磁盘 |
|---|---|---|---|
| 48 Intel(R) Xeon(R) CPU E5-2650 v4 @ 2.20GHz | 128G | 10000Mbps | 750GB SSD |
1.2 软件信息
1.2.1 测试用例
测试使用graphdb-benchmark,一个图数据库测试集。该测试集主要包含4类测试:
Massive Insertion,批量插入顶点和边,一定数量的顶点或边一次性提交
Single Insertion,单条插入,每个顶点或者每条边立即提交
Query,主要是图数据库的基本查询操作:
- Find Neighbors,查询所有顶点的邻居
- Find Adjacent Nodes,查询所有边的邻接顶点
- Find Shortest Path,查询第一个顶点到100个随机顶点的最短路径
Clustering,基于Louvain Method的社区发现算法
1.2.2 测试数据集
测试使用人造数据和真实数据
MIW、SIW和QW使用SNAP数据集
CW使用LFR-Benchmark generator生成的人造数据
本测试用到的数据集规模
| 名称 | vertex数目 | edge数目 | 文件大小 |
|---|---|---|---|
| email-enron.txt | 36,691 | 367,661 | 4MB |
| com-youtube.ungraph.txt | 1,157,806 | 2,987,624 | 38.7MB |
| amazon0601.txt | 403,393 | 3,387,388 | 47.9MB |
| com-lj.ungraph.txt | 3997961 | 34681189 | 479MB |
1.3 服务配置
HugeGraph版本:0.5.6,RestServer和Gremlin Server和backends都在同一台服务器上
- RocksDB版本:rocksdbjni-5.8.6
Titan版本:0.5.4, 使用thrift+Cassandra模式
- Cassandra版本:cassandra-3.10,commit-log 和 data 共用SSD
Neo4j版本:2.0.1
graphdb-benchmark适配的Titan版本为0.5.4
2 测试结果
2.1 Batch插入性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) | com-lj.ungraph(3000w) |
|---|---|---|---|---|
| HugeGraph | 0.629 | 5.711 | 5.243 | 67.033 |
| Titan | 10.15 | 108.569 | 150.266 | 1217.944 |
| Neo4j | 3.884 | 18.938 | 24.890 | 281.537 |
说明
- 表头"()“中数据是数据规模,以边为单位
- 表中数据是批量插入的时间,单位是s
- 例如,HugeGraph使用RocksDB插入amazon0601数据集的300w条边,花费5.711s
结论
- 批量插入性能 HugeGraph(RocksDB) > Neo4j > Titan(thrift+Cassandra)
2.2 遍历性能
2.2.1 术语说明
- FN(Find Neighbor), 遍历所有vertex, 根据vertex查邻接edge, 通过edge和vertex查other vertex
- FA(Find Adjacent), 遍历所有edge,根据edge获得source vertex和target vertex
2.2.2 FN性能
| Backend | email-enron(3.6w) | amazon0601(40w) | com-youtube.ungraph(120w) | com-lj.ungraph(400w) |
|---|---|---|---|---|
| HugeGraph | 4.072 | 45.118 | 66.006 | 609.083 |
| Titan | 8.084 | 92.507 | 184.543 | 1099.371 |
| Neo4j | 2.424 | 10.537 | 11.609 | 106.919 |
说明
- 表头”()“中数据是数据规模,以顶点为单位
- 表中数据是遍历顶点花费的时间,单位是s
- 例如,HugeGraph使用RocksDB后端遍历amazon0601的所有顶点,并查找邻接边和另一顶点,总共耗时45.118s
2.2.3 FA性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) | com-lj.ungraph(3000w) |
|---|---|---|---|---|
| HugeGraph | 1.540 | 10.764 | 11.243 | 151.271 |
| Titan | 7.361 | 93.344 | 169.218 | 1085.235 |
| Neo4j | 1.673 | 4.775 | 4.284 | 40.507 |
说明
- 表头”()“中数据是数据规模,以边为单位
- 表中数据是遍历边花费的时间,单位是s
- 例如,HugeGraph使用RocksDB后端遍历amazon0601的所有边,并查询每条边的两个顶点,总共耗时10.764s
结论
- 遍历性能 Neo4j > HugeGraph(RocksDB) > Titan(thrift+Cassandra)
2.3 HugeGraph-图常用分析方法性能
术语说明
- FS(Find Shortest Path), 寻找最短路径
- K-neighbor,从起始vertex出发,通过K跳边能够到达的所有顶点, 包括1, 2, 3…(K-1), K跳边可达vertex
- K-out, 从起始vertex出发,恰好经过K跳out边能够到达的顶点
FS性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) | com-lj.ungraph(3000w) |
|---|---|---|---|---|
| HugeGraph | 0.494 | 0.103 | 3.364 | 8.155 |
| Titan | 11.818 | 0.239 | 377.709 | 575.678 |
| Neo4j | 1.719 | 1.800 | 1.956 | 8.530 |
说明
- 表头”()“中数据是数据规模,以边为单位
- 表中数据是找到从第一个顶点出发到达随机选择的100个顶点的最短路径的时间,单位是s
- 例如,HugeGraph使用RocksDB后端在图amazon0601中查找第一个顶点到100个随机顶点的最短路径,总共耗时0.103s
结论
- 在数据规模小或者顶点关联关系少的场景下,HugeGraph性能优于Neo4j和Titan
- 随着数据规模增大且顶点的关联度增高,HugeGraph与Neo4j性能趋近,都远高于Titan
K-neighbor性能
| 顶点 | 深度 | 一度 | 二度 | 三度 | 四度 | 五度 | 六度 |
|---|---|---|---|---|---|---|---|
| v1 | 时间 | 0.031s | 0.033s | 0.048s | 0.500s | 11.27s | OOM |
| v111 | 时间 | 0.027s | 0.034s | 0.115 | 1.36s | OOM | – |
| v1111 | 时间 | 0.039s | 0.027s | 0.052s | 0.511s | 10.96s | OOM |
说明
- HugeGraph-Server的JVM内存设置为32GB,数据量过大时会出现OOM
K-out性能
| 顶点 | 深度 | 一度 | 二度 | 三度 | 四度 | 五度 | 六度 |
|---|---|---|---|---|---|---|---|
| v1 | 时间 | 0.054s | 0.057s | 0.109s | 0.526s | 3.77s | OOM |
| 度 | 10 | 133 | 2453 | 50,830 | 1,128,688 | ||
| v111 | 时间 | 0.032s | 0.042s | 0.136s | 1.25s | 20.62s | OOM |
| 度 | 10 | 211 | 4944 | 113150 | 2,629,970 | ||
| v1111 | 时间 | 0.039s | 0.045s | 0.053s | 1.10s | 2.92s | OOM |
| 度 | 10 | 140 | 2555 | 50825 | 1,070,230 |
说明
- HugeGraph-Server的JVM内存设置为32GB,数据量过大时会出现OOM
结论
- FS场景,HugeGraph性能优于Neo4j和Titan
- K-neighbor和K-out场景,HugeGraph能够实现在5度范围内秒级返回结果
2.4 图综合性能测试-CW
| 数据库 | 规模1000 | 规模5000 | 规模10000 | 规模20000 |
|---|---|---|---|---|
| HugeGraph(core) | 20.804 | 242.099 | 744.780 | 1700.547 |
| Titan | 45.790 | 820.633 | 2652.235 | 9568.623 |
| Neo4j | 5.913 | 50.267 | 142.354 | 460.880 |
说明
- “规模"以顶点为单位
- 表中数据是社区发现完成需要的时间,单位是s,例如HugeGraph使用RocksDB后端在规模10000的数据集,社区聚合不再变化,需要耗时744.780s
- CW测试是CRUD的综合评估
- 该测试中HugeGraph跟Titan一样,没有通过client,直接对core操作
结论
- 社区聚类算法性能 Neo4j > HugeGraph > Titan
2 - HugeGraph-API Performance
HugeGraph API性能测试主要测试HugeGraph-Server对RESTful API请求的并发处理能力,包括:
- 顶点/边的单条插入
- 顶点/边的批量插入
- 顶点/边的查询
HugeGraph的每个发布版本的RESTful API的性能测试情况可以参考:
即将更新,敬请期待!
2.1 - v0.5.6 Stand-alone(RocksDB)
1 测试环境
被压机器信息
| CPU | Memory | 网卡 | 磁盘 |
|---|---|---|---|
| 48 Intel(R) Xeon(R) CPU E5-2650 v4 @ 2.20GHz | 128G | 10000Mbps | 750GB SSD,2.7T HDD |
- 起压力机器信息:与被压机器同配置
- 测试工具:apache-Jmeter-2.5.1
注:起压机器和被压机器在同一机房
2 测试说明
2.1 名词定义(时间的单位均为ms)
- Samples – 本次场景中一共完成了多少个线程
- Average – 平均响应时间
- Median – 统计意义上面的响应时间的中值
- 90% Line – 所有线程中90%的线程的响应时间都小于xx
- Min – 最小响应时间
- Max – 最大响应时间
- Error – 出错率
- Throughput – 吞吐量
- KB/sec – 以流量做衡量的吞吐量
2.2 底层存储
后端存储使用RocksDB,HugeGraph与RocksDB都在同一机器上启动,server相关的配置文件除主机和端口有修改外,其余均保持默认。
3 性能结果总结
- HugeGraph单条插入顶点和边的速度在每秒1w左右
- 顶点和边的批量插入速度远大于单条插入速度
- 按id查询顶点和边的并发度可达到13000以上,且请求的平均延时小于50ms
4 测试结果及分析
4.1 batch插入
4.1.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
持续时间:5min
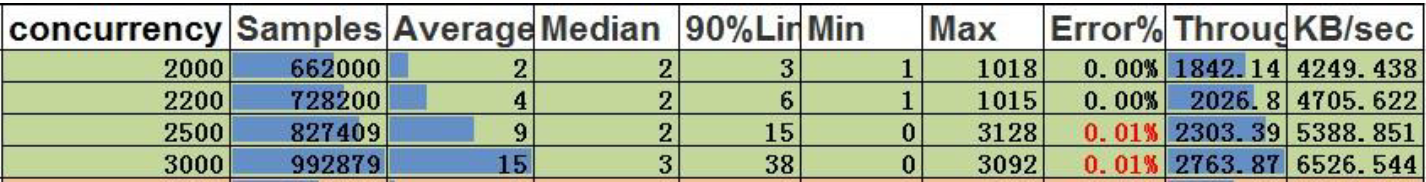
顶点的最大插入速度:
####### 结论:
- 并发2200,顶点的吞吐量是2026.8,每秒可处理的数据:2026.8*200=405360/s
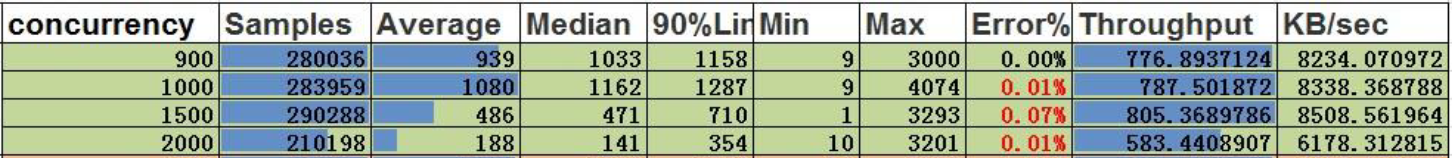
边的最大插入速度
####### 结论:
- 并发900,边的吞吐量是776.9,每秒可处理的数据:776.9*500=388450/s
4.2 single插入
4.2.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
- 持续时间:5min
- 服务异常标志:错误率大于0.00%
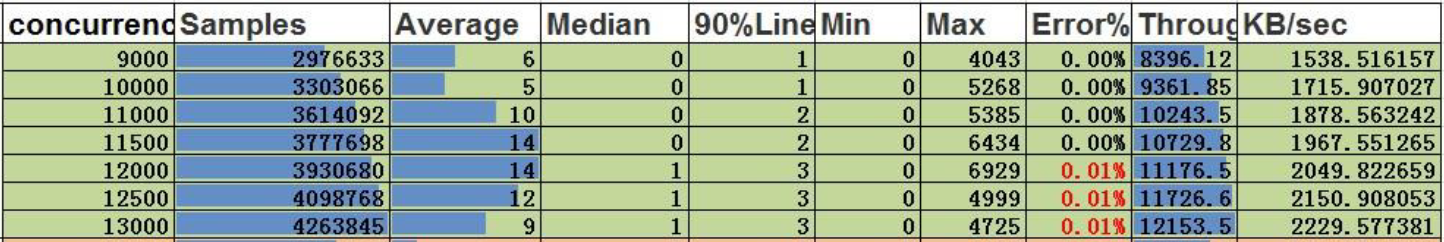
顶点的单条插入
####### 结论:
- 并发11500,吞吐量为10730,顶点的单条插入并发能力为11500
边的单条插入
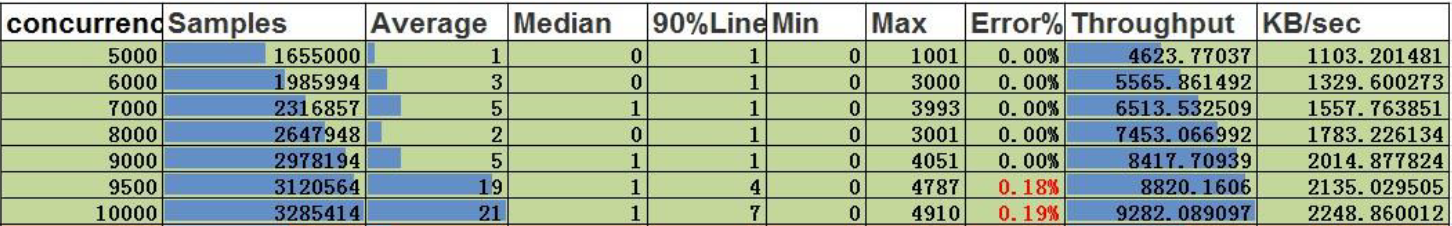
####### 结论:
- 并发9000,吞吐量是8418,边的单条插入并发能力为9000
4.3 按id查询
4.3.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
- 持续时间:5min
- 服务异常标志:错误率大于0.00%
顶点的按id查询
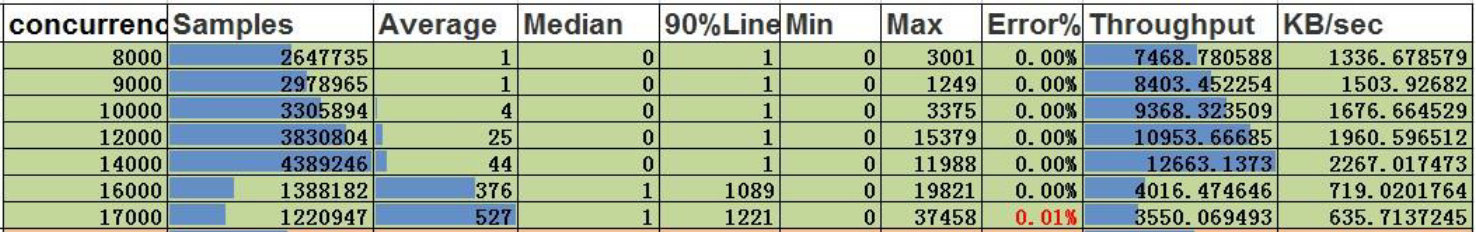
####### 结论:
- 并发14000,吞吐量是12663,顶点的按id查询的并发能力为14000,平均延时为44ms
边的按id查询
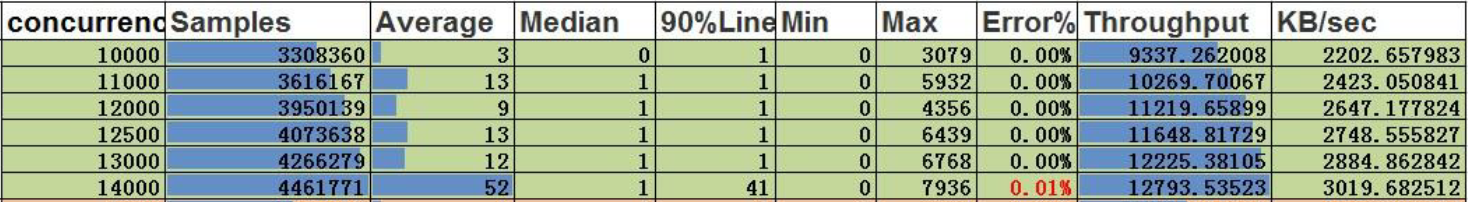
####### 结论:
- 并发13000,吞吐量是12225,边的按id查询的并发能力为13000,平均延时为12ms
2.2 - v0.5.6 Cluster(Cassandra)
1 测试环境
被压机器信息
| CPU | Memory | 网卡 | 磁盘 |
|---|---|---|---|
| 48 Intel(R) Xeon(R) CPU E5-2650 v4 @ 2.20GHz | 128G | 10000Mbps | 750GB SSD,2.7T HDD |
- 起压力机器信息:与被压机器同配置
- 测试工具:apache-Jmeter-2.5.1
注:起压机器和被压机器在同一机房
2 测试说明
2.1 名词定义(时间的单位均为ms)
- Samples – 本次场景中一共完成了多少个线程
- Average – 平均响应时间
- Median – 统计意义上面的响应时间的中值
- 90% Line – 所有线程中90%的线程的响应时间都小于xx
- Min – 最小响应时间
- Max – 最大响应时间
- Error – 出错率
- Throughput – 吞吐量
- KB/sec – 以流量做衡量的吞吐量
2.2 底层存储
后端存储使用15节点Cassandra集群,HugeGraph与Cassandra集群位于不同的服务器,server相关的配置文件除主机和端口有修改外,其余均保持默认。
3 性能结果总结
- HugeGraph单条插入顶点和边的速度分别为9000和4500
- 顶点和边的批量插入速度分别为5w/s和15w/s,远大于单条插入速度
- 按id查询顶点和边的并发度可达到12000以上,且请求的平均延时小于70ms
4 测试结果及分析
4.1 batch插入
4.1.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
持续时间:5min
顶点的最大插入速度:
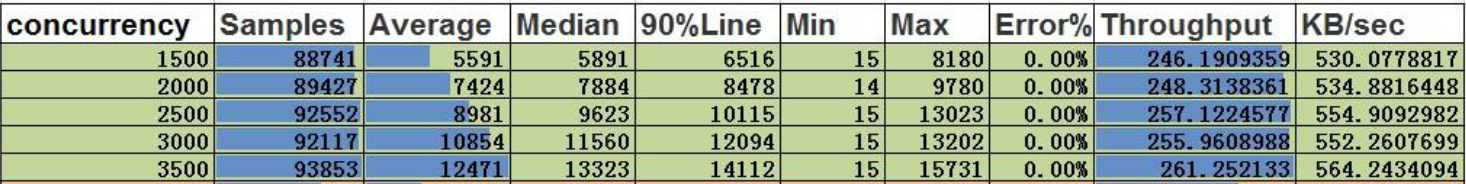
####### 结论:
- 并发3500,顶点的吞吐量是261,每秒可处理的数据:261*200=52200/s
边的最大插入速度

####### 结论:
- 并发1000,边的吞吐量是323,每秒可处理的数据:323*500=161500/s
4.2 single插入
4.2.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
- 持续时间:5min
- 服务异常标志:错误率大于0.00%
顶点的单条插入
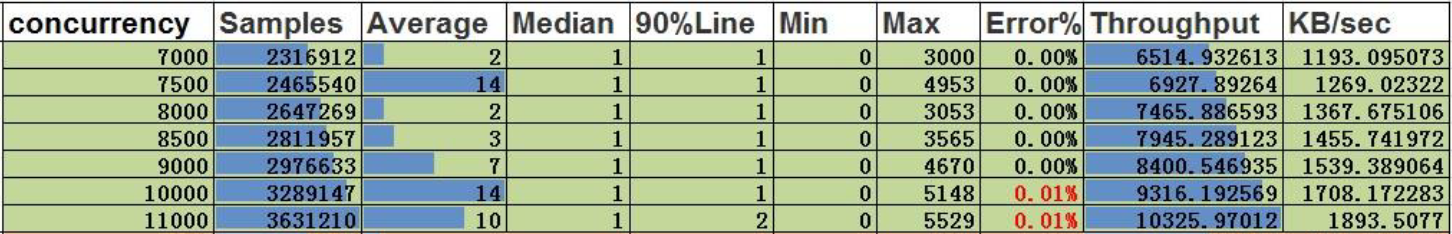
####### 结论:
- 并发9000,吞吐量为8400,顶点的单条插入并发能力为9000
边的单条插入
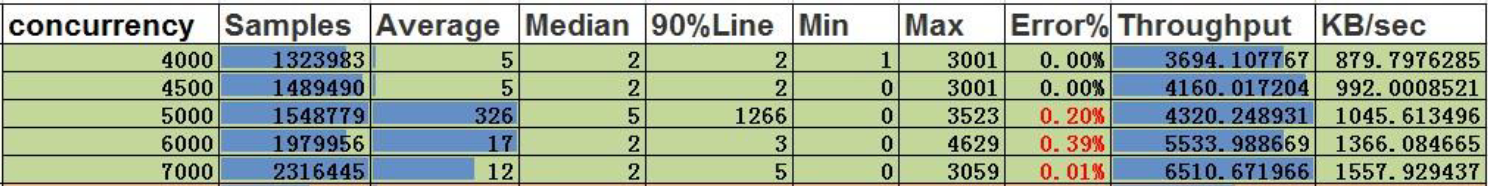
####### 结论:
- 并发4500,吞吐量是4160,边的单条插入并发能力为4500
4.3 按id查询
4.3.1 压力上限测试
测试方法
不断提升并发量,测试server仍能正常提供服务的压力上限
压力参数
- 持续时间:5min
- 服务异常标志:错误率大于0.00%
顶点的按id查询
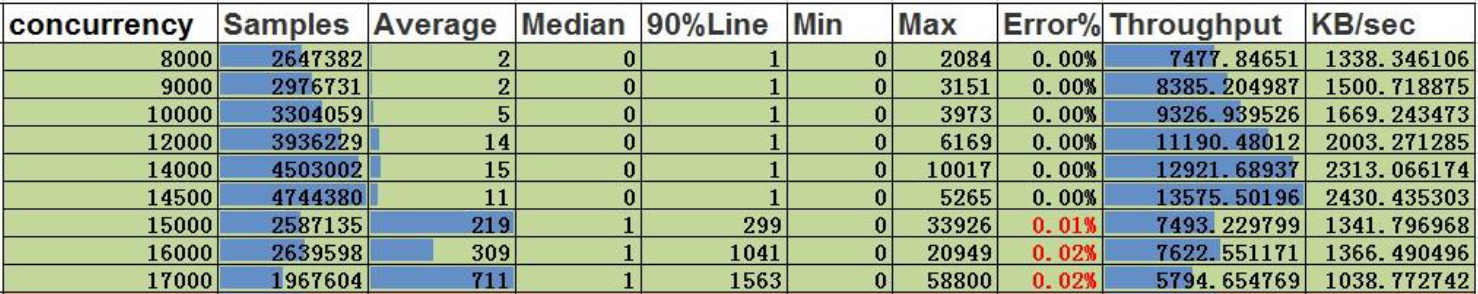
####### 结论:
- 并发14500,吞吐量是13576,顶点的按id查询的并发能力为14500,平均延时为11ms
边的按id查询
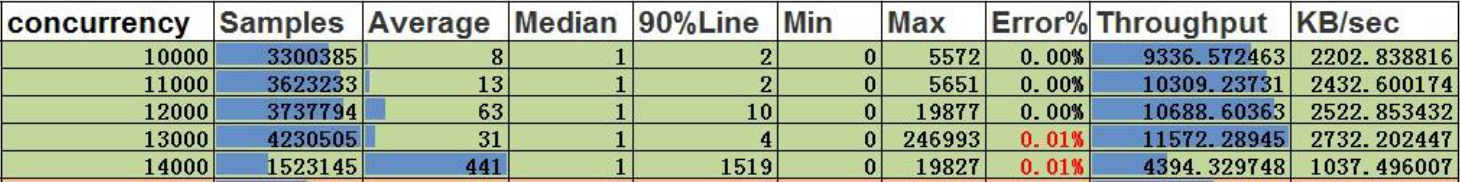
####### 结论:
- 并发12000,吞吐量是10688,边的按id查询的并发能力为12000,平均延时为63ms
3 - HugeGraph-Loader Performance
使用场景
当要批量插入的图数据(包括顶点和边)条数为billion级别及以下,或者总数据量小于TB时,可以采用HugeGraph-Loader工具持续、高速导入图数据
性能
测试均采用网址数据的边数据
RocksDB单机性能
- 关闭label index,22.8w edges/s
- 开启label index,15.3w edges/s
Cassandra集群性能
- 默认开启label index,6.3w edges/s
4 - HugeGraph 0.4.4 性能测试
1 测试环境
1.1 硬件信息
| CPU | Memory | 网卡 | 磁盘 |
|---|---|---|---|
| 48 Intel(R) Xeon(R) CPU E5-2650 v4 @ 2.20GHz | 128G | 10000Mbps | 750GB SSD |
1.2 软件信息
1.2.1 测试用例
测试使用graphdb-benchmark,一个图数据库测试集。该测试集主要包含4类测试:
Massive Insertion,批量插入顶点和边,一定数量的顶点或边一次性提交
Single Insertion,单条插入,每个顶点或者每条边立即提交
Query,主要是图数据库的基本查询操作:
- Find Neighbors,查询所有顶点的邻居
- Find Adjacent Nodes,查询所有边的邻接顶点
- Find Shortest Path,查询第一个顶点到100个随机顶点的最短路径
Clustering,基于Louvain Method的社区发现算法
1.2.2 测试数据集
测试使用人造数据和真实数据
MIW、SIW和QW使用SNAP数据集
CW使用LFR-Benchmark generator生成的人造数据
本测试用到的数据集规模
| 名称 | vertex数目 | edge数目 | 文件大小 |
|---|---|---|---|
| email-enron.txt | 36,691 | 367,661 | 4MB |
| com-youtube.ungraph.txt | 1,157,806 | 2,987,624 | 38.7MB |
| amazon0601.txt | 403,393 | 3,387,388 | 47.9MB |
1.3 服务配置
- HugeGraph版本:0.4.4,RestServer和Gremlin Server和backends都在同一台服务器上
- Cassandra版本:cassandra-3.10,commit-log 和data共用SSD
- RocksDB版本:rocksdbjni-5.8.6
- Titan版本:0.5.4, 使用thrift+Cassandra模式
graphdb-benchmark适配的Titan版本为0.5.4
2 测试结果
2.1 Batch插入性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) |
|---|---|---|---|
| Titan | 9.516 | 88.123 | 111.586 |
| RocksDB | 2.345 | 14.076 | 16.636 |
| Cassandra | 11.930 | 108.709 | 101.959 |
| Memory | 3.077 | 15.204 | 13.841 |
说明
- 表头"()“中数据是数据规模,以边为单位
- 表中数据是批量插入的时间,单位是s
- 例如,HugeGraph使用RocksDB插入amazon0601数据集的300w条边,花费14.076s,速度约为21w edges/s
结论
- RocksDB和Memory后端插入性能优于Cassandra
- HugeGraph和Titan同样使用Cassandra作为后端的情况下,插入性能接近
2.2 遍历性能
2.2.1 术语说明
- FN(Find Neighbor), 遍历所有vertex, 根据vertex查邻接edge, 通过edge和vertex查other vertex
- FA(Find Adjacent), 遍历所有edge,根据edge获得source vertex和target vertex
2.2.2 FN性能
| Backend | email-enron(3.6w) | amazon0601(40w) | com-youtube.ungraph(120w) |
|---|---|---|---|
| Titan | 7.724 | 70.935 | 128.884 |
| RocksDB | 8.876 | 65.852 | 63.388 |
| Cassandra | 13.125 | 126.959 | 102.580 |
| Memory | 22.309 | 207.411 | 165.609 |
说明
- 表头”()“中数据是数据规模,以顶点为单位
- 表中数据是遍历顶点花费的时间,单位是s
- 例如,HugeGraph使用RocksDB后端遍历amazon0601的所有顶点,并查找邻接边和另一顶点,总共耗时65.852s
2.2.3 FA性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) |
|---|---|---|---|
| Titan | 7.119 | 63.353 | 115.633 |
| RocksDB | 6.032 | 64.526 | 52.721 |
| Cassandra | 9.410 | 102.766 | 94.197 |
| Memory | 12.340 | 195.444 | 140.89 |
说明
- 表头”()“中数据是数据规模,以边为单位
- 表中数据是遍历边花费的时间,单位是s
- 例如,HugeGraph使用RocksDB后端遍历amazon0601的所有边,并查询每条边的两个顶点,总共耗时64.526s
结论
- HugeGraph RocksDB > Titan thrift+Cassandra > HugeGraph Cassandra > HugeGraph Memory
2.3 HugeGraph-图常用分析方法性能
术语说明
- FS(Find Shortest Path), 寻找最短路径
- K-neighbor,从起始vertex出发,通过K跳边能够到达的所有顶点, 包括1, 2, 3…(K-1), K跳边可达vertex
- K-out, 从起始vertex出发,恰好经过K跳out边能够到达的顶点
FS性能
| Backend | email-enron(30w) | amazon0601(300w) | com-youtube.ungraph(300w) |
|---|---|---|---|
| Titan | 11.333 | 0.313 | 376.06 |
| RocksDB | 44.391 | 2.221 | 268.792 |
| Cassandra | 39.845 | 3.337 | 331.113 |
| Memory | 35.638 | 2.059 | 388.987 |
说明
- 表头”()“中数据是数据规模,以边为单位
- 表中数据是找到从第一个顶点出发到达随机选择的100个顶点的最短路径的时间,单位是s
- 例如,HugeGraph使用RocksDB查找第一个顶点到100个随机顶点的最短路径,总共耗时2.059s
结论
- 在数据规模小或者顶点关联关系少的场景下,Titan最短路径性能优于HugeGraph
- 随着数据规模增大且顶点的关联度增高,HugeGraph最短路径性能优于Titan
K-neighbor性能
| 顶点 | 深度 | 一度 | 二度 | 三度 | 四度 | 五度 | 六度 |
|---|---|---|---|---|---|---|---|
| v1 | 时间 | 0.031s | 0.033s | 0.048s | 0.500s | 11.27s | OOM |
| v111 | 时间 | 0.027s | 0.034s | 0.115 | 1.36s | OOM | – |
| v1111 | 时间 | 0.039s | 0.027s | 0.052s | 0.511s | 10.96s | OOM |
说明
- HugeGraph-Server的JVM内存设置为32GB,数据量过大时会出现OOM
K-out性能
| 顶点 | 深度 | 一度 | 二度 | 三度 | 四度 | 五度 | 六度 |
|---|---|---|---|---|---|---|---|
| v1 | 时间 | 0.054s | 0.057s | 0.109s | 0.526s | 3.77s | OOM |
| 度 | 10 | 133 | 2453 | 50,830 | 1,128,688 | ||
| v111 | 时间 | 0.032s | 0.042s | 0.136s | 1.25s | 20.62s | OOM |
| 度 | 10 | 211 | 4944 | 113150 | 2,629,970 | ||
| v1111 | 时间 | 0.039s | 0.045s | 0.053s | 1.10s | 2.92s | OOM |
| 度 | 10 | 140 | 2555 | 50825 | 1,070,230 |
说明
- HugeGraph-Server的JVM内存设置为32GB,数据量过大时会出现OOM
结论
- FS场景,HugeGraph性能优于Titan
- K-neighbor和K-out场景,HugeGraph能够实现在5度范围内秒级返回结果
2.4 图综合性能测试-CW
| 数据库 | 规模1000 | 规模5000 | 规模10000 | 规模20000 |
|---|---|---|---|---|
| Titan | 45.943 | 849.168 | 2737.117 | 9791.46 |
| Memory(core) | 41.077 | 1825.905 | * | * |
| Cassandra(core) | 39.783 | 862.744 | 2423.136 | 6564.191 |
| RocksDB(core) | 33.383 | 199.894 | 763.869 | 1677.813 |
说明
- “规模"以顶点为单位
- 表中数据是社区发现完成需要的时间,单位是s,例如HugeGraph使用RocksDB后端在规模10000的数据集,社区聚合不再变化,需要耗时763.869s
- “*“表示超过10000s未完成
- CW测试是CRUD的综合评估
- 后三者分别是HugeGraph的不同后端,该测试中HugeGraph跟Titan一样,没有通过client,直接对core操作
结论
- HugeGraph在使用Cassandra后端时,性能略优于Titan,随着数据规模的增大,优势越来越明显,数据规模20000时,比Titan快30%
- HugeGraph在使用RocksDB后端时,性能远高于Titan和HugeGraph的Cassandra后端,分别比两者快了6倍和4倍