这是本节的多页打印视图。 .
HugeGraph-AI
hugegraph-ai 提供 HugeGraph 的 Python 客户端、图机器学习工具,以及面向知识图谱构建和 GraphRAG 的 LLM 工具。
Apache License 2.0 · Ask DeepWiki
模块
- hugegraph-llm:知识图谱构建、GraphRAG 和自然语言图查询。
- hugegraph-ml:从 HugeGraph 读取图数据并运行图学习模型。
- hugegraph-python-client:管理 Schema、图数据和 Gremlin 查询的 Python SDK。
- vermeer-python-client:调用 Vermeer 图计算服务的 Python SDK。
仓库使用 uv workspace 管理 LLM 和 Python 客户端。HugeGraph-ML 是路径依赖模块,不在 workspace members 中。
环境要求
- HugeGraph-LLM:Python 3.10 或 3.11
- HugeGraph-ML、Python 客户端:Python 3.10 或更高版本
uv0.7 或更高版本- HugeGraph Server 1.5 或更高版本
Docker Compose 部署
仓库提供同时启动 HugeGraph Server 和 RAG 服务的 Compose 文件:
默认地址:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 界面:
http://localhost:8001
从源码启动 RAG 服务
uv sync 会创建根目录下的 .venv。不要在 hugegraph-llm 子目录另建一套环境,否则容易绕过 workspace 锁定的依赖。
安装 ML 依赖
示例脚本位于 hugegraph-ml/src/hugegraph_ml/examples/。
后续阅读
1 - HugeGraph-LLM
HugeGraph-LLM 用于知识图谱构建、GraphRAG 和自然语言图查询。演示服务把 Gradio 页面和 FastAPI 接口挂在同一个进程上,默认监听 8001 端口。
环境要求
AI 总结项目文档:Ask DeepWiki
- Python 3.10 或 3.11
uv0.7 或更高版本- HugeGraph Server 1.5 或更高版本
Docker Compose 部署
在 HugeGraph-AI 仓库根目录准备环境文件:
启动后可访问:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 页面:
http://localhost:8001
从源码启动
依赖应从仓库根目录按 workspace 安装:
自定义监听地址和端口:
服务以 hugegraph-llm/.env 保存模型、HugeGraph 和登录配置。提示词放在 hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml。缺少文件时,配置代码会按默认值创建。
主要功能
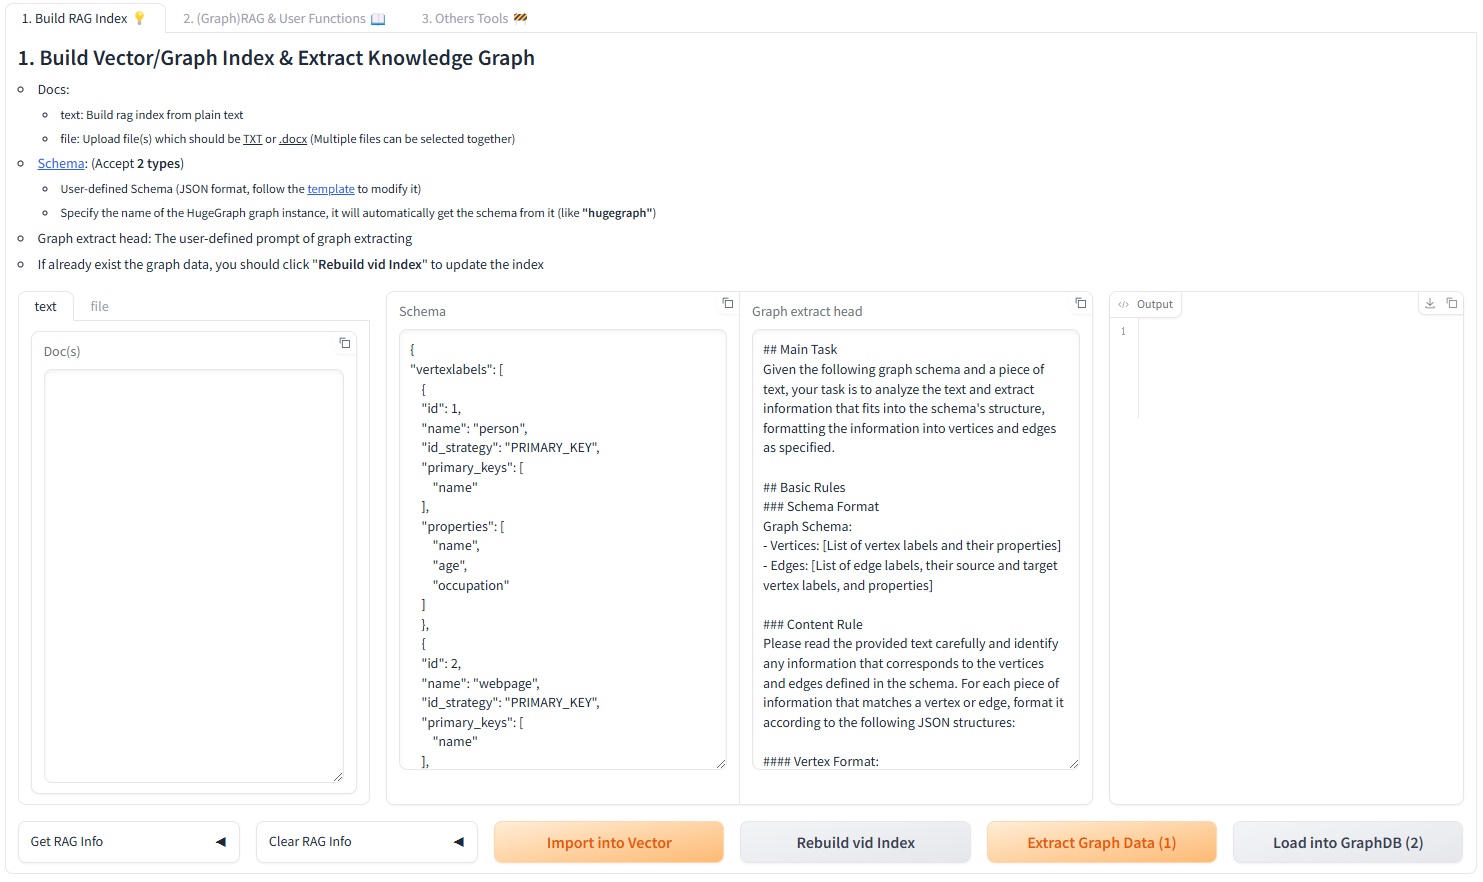
构建 RAG 索引
Web 页面的第一个标签页可以处理文本或文件,并执行以下操作:
- 切分文本并写入 chunk 向量索引。
- 按给定 Schema 从文本抽取顶点和边。
- 将抽取结果写入 HugeGraph,并更新顶点向量索引。
Schema 可以是内联 JSON,也可以是现有图名。通过 REST API 使用图名时,必须同时传入匹配的 client_config.graph;内联 JSON 不会连接 HugeGraph,也不能附带 client_config。
GraphRAG
查询流程可以组合直接回答、chunk 向量召回和图召回。图召回先抽取关键词并匹配顶点,再尝试 Text2Gremlin;生成或执行失败时可回退到预定义的图遍历方式。请求参数可控制返回数量、向量距离阈值、模板数量和重排序方式。
Text2Gremlin
POST /text2gremlin 根据自然语言、图 Schema 和可选示例生成 Gremlin。自定义提示词必须保留 {query}、{schema}、{example} 和 {vertices} 四个占位符。
模型与向量后端
聊天、信息抽取和 Text2Gremlin 可以分别使用 OpenAI 兼容接口、Ollama 或 LiteLLM。嵌入模型也可以独立选择。默认向量索引使用 FAISS;安装 vectordb 可选依赖后,还可配置 Milvus 或 Qdrant:
完整环境变量见配置参考,HTTP 请求格式见REST API。
开发检查
2 - HugeGraph-ML
HugeGraph-ML 从 HugeGraph 读取图数据并转换为 DGL 图,供节点嵌入、节点分类和图分类等任务使用。模型实现位于 hugegraph-ml/src/hugegraph_ml/models/。
环境要求
- Python 3.10 或更高版本
- HugeGraph Server 1.0 或更高版本,推荐 1.5 及以上版本
uv0.7 或更高版本
安装
HugeGraph-ML 是根项目的路径依赖,但不属于 uv workspace members。应在仓库根目录选择 ml extra,不要在子目录建立另一套锁文件。
已实现模型
当前 README 列出的模型如下:
| 模型 | 主要用途 |
|---|---|
| AGNN、APPNP、ARMA、Cluster-GCN、DAGNN、DeeperGCN、GRAND、JKNet | 节点分类 |
| BGNN、CARE-GNN | 欺诈检测 |
| BGRL、DGI、GRACE | 表示学习 |
| DiffPool | 图分类 |
| GATNE、P-GNN、SEAL | 链接预测或网络嵌入 |
| C&S | 预测结果校正与平滑 |
源码中还包含 GIN 图分类实现和供下游分类使用的 MLPClassifier。模型数量会随版本变化,以 src/hugegraph_ml/models/ 为准。
DGI 节点嵌入示例
先把 DGL 的 Cora 数据集导入 HugeGraph:
读取图并训练 DGI:
完整脚本是 hugegraph-ml/src/hugegraph_ml/examples/dgi_example.py。
GRAND 节点分类示例
完整脚本是 hugegraph-ml/src/hugegraph_ml/examples/grand_example.py。
排查问题
- 连接失败:检查 HugeGraph Server 地址、端口和认证信息。
- Schema 不匹配:示例默认使用
CORA_vertex和CORA_edge,自有数据需要传入实际标签。 - DGL 或 PyTorch 导入失败:回到仓库根目录重新执行
uv sync --extra ml,并确认当前 Python 来自根目录.venv。
3 - HugeGraph-LLM 使用流程
本文说明 HugeGraph-LLM Web 页面的处理流程。服务启动方式见 HugeGraph-LLM。
1. 构建 RAG 索引
第一个标签页负责两类索引:
- 将文档切分后写入 chunk 向量索引。
- 按 Schema 从文档抽取顶点和边,写入 HugeGraph,并维护顶点向量索引。
flowchart TD
    A[输入文档] --> B[文本切分]
    B --> C[生成 chunk 向量]
    C --> D[写入向量索引]
    B --> E[LLM 按 Schema 抽取顶点和边]
    E --> F[写入 HugeGraph]
    F --> G[更新顶点向量索引]
页面包含文档、Schema、抽取提示词和结果区域。常用操作有:
Import into Vector:切分文档并建立 chunk 向量索引。Extract Graph Data:按 Schema 抽取图数据。Load into GraphDB:把抽取结果写入 HugeGraph,并更新顶点向量。Update Vid Embedding:重新生成顶点向量。
页面还可以查看或清除 chunk 索引、顶点索引和图数据。清除操作会删除已有数据,执行前先确认当前图和索引是否仍被其他查询使用。
2. GraphRAG 查询
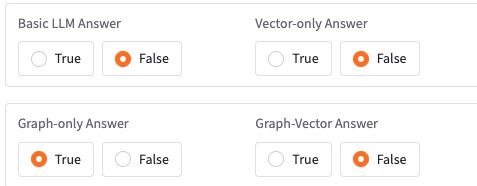
第二个标签页提供四种回答范围:
- 直接使用 LLM 回答。
- 只使用 chunk 向量召回。
- 只使用图召回。
- 合并图召回与向量召回。
flowchart TD
    Q[问题] --> V[查询 chunk 向量索引]
    Q --> K[抽取关键词]
    K --> M[匹配图顶点]
    M --> T[生成并执行 Gremlin]
    T -->|失败| B[BFS 图遍历回退]
    T --> R[整理图结果]
    B --> R
    V --> S[合并与重排序]
    R --> S
    S --> A[生成答案]
图召回先用关键词精确匹配 HugeGraph 顶点,找不到时再用顶点向量做近似匹配。匹配结果会进入 Text2Gremlin;生成或执行失败时,流程可以回退到预定义的图遍历。
Template Num 控制 Text2Gremlin 使用的示例数量。小于等于 0 表示不提供模板,大于 0 表示从示例索引中取相应数量的相近模板。
3. Text2Gremlin
第三个标签页把自然语言转换成 Gremlin:
- 读取当前图的 Schema。
- 从示例向量索引取回相近的自然语言与 Gremlin 对。
- 把问题、Schema、示例和已匹配顶点填入提示词。
- 调用 LLM 生成 Gremlin,并按所选输出类型决定是否执行。
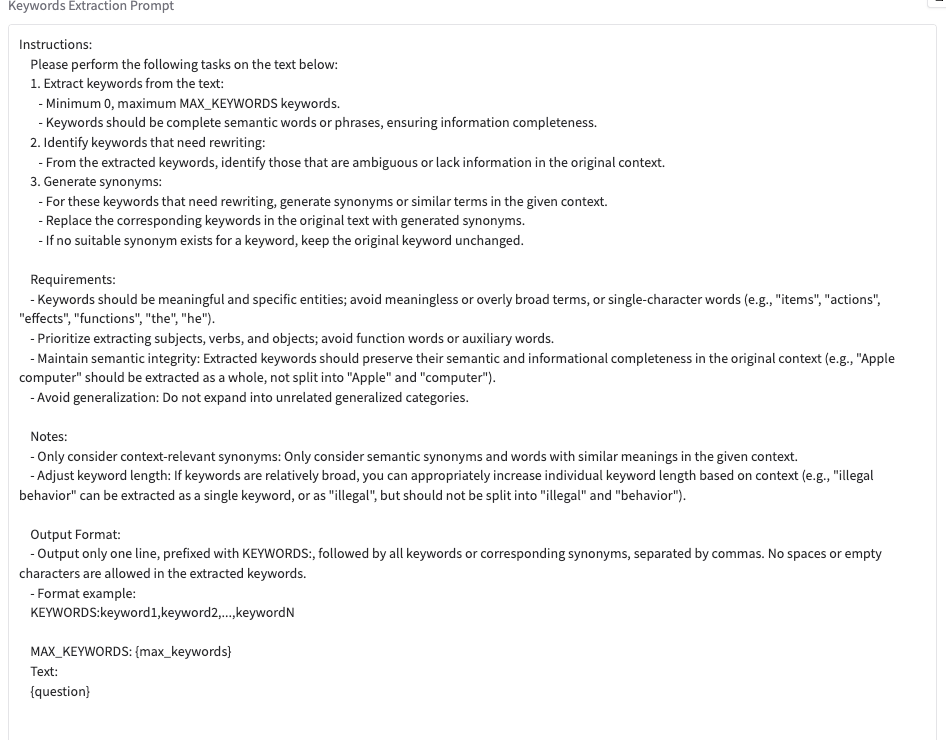
自定义提示词必须包含 {query}、{schema}、{example} 和 {vertices}。缺少任一占位符时,REST API 会拒绝请求。
4. 图工具与管理工具
Graph Tools 标签页用于直接执行图操作。Admin Tools 提供日志等管理能力。启用登录后,页面和 API 需要使用 USER_TOKEN;日志接口还要求单独配置安全的 ADMIN_TOKEN。
5. 提示词语言
在 hugegraph-llm/.env 中设置:
修改后重启服务。该配置选择内置提示词语言,不会自动翻译输入文档,也不是 /rag 请求体字段。
6. REST 调用
Web 页面和 REST API 使用同一套流程。需要程序集成时使用 /rag、/rag/graph、/graph/extract 和 /text2gremlin;请求结构见 REST API。
4 - 配置参考
HugeGraph-LLM 从 hugegraph-llm/.env 读取运行配置。提示词单独保存在 hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml,不会写入 .env。
运行以下命令可按配置类的默认值创建或更新文件:
.env 包含密钥和密码,不要提交到版本库。
基础选项
| 配置项 | 默认值 | 说明 |
|---|---|---|
LANGUAGE | EN | 提示词语言,可选 EN、CN |
CHAT_LLM_TYPE | openai | 回答模型,可选 openai、litellm、ollama/local |
EXTRACT_LLM_TYPE | openai | 信息抽取模型,取值同上 |
TEXT2GQL_LLM_TYPE | openai | Text2Gremlin 模型,取值同上 |
EMBEDDING_TYPE | openai | 嵌入模型,取值同上,也可以留空 |
RERANKER_TYPE | 空 | 可选 cohere、siliconflow |
KEYWORD_EXTRACT_TYPE | llm | 可选 llm、textrank、hybrid |
WINDOW_SIZE | 3 | TextRank 滑窗,范围 1 到 10 |
HYBRID_LLM_WEIGHTS | 0.5 | hybrid 模式中 LLM 结果的权重,范围 0 到 1 |
OpenAI 兼容接口
聊天、抽取和 Text2Gremlin 可以使用不同端点、密钥和模型。
| 用途 | API 地址 | 密钥 | 模型 | 最大 token 默认值 |
|---|---|---|---|---|
| 回答 | OPENAI_CHAT_API_BASE | OPENAI_CHAT_API_KEY | OPENAI_CHAT_LANGUAGE_MODEL | OPENAI_CHAT_TOKENS=8192 |
| 抽取 | OPENAI_EXTRACT_API_BASE | OPENAI_EXTRACT_API_KEY | OPENAI_EXTRACT_LANGUAGE_MODEL | OPENAI_EXTRACT_TOKENS=256 |
| Text2Gremlin | OPENAI_TEXT2GQL_API_BASE | OPENAI_TEXT2GQL_API_KEY | OPENAI_TEXT2GQL_LANGUAGE_MODEL | OPENAI_TEXT2GQL_TOKENS=4096 |
| 嵌入 | OPENAI_EMBEDDING_API_BASE | OPENAI_EMBEDDING_API_KEY | OPENAI_EMBEDDING_MODEL | 不适用 |
API 地址默认是 https://api.openai.com/v1;三个语言模型默认是 gpt-4.1-mini,嵌入模型默认是 text-embedding-3-small。
OPENAI_BASE_URL 和 OPENAI_API_KEY 可作为通用回退值。嵌入模型另有 OPENAI_EMBEDDING_BASE_URL 和 OPENAI_EMBEDDING_API_KEY 回退值。
LiteLLM
| 用途 | API 地址 | 密钥 | 模型 | 最大 token 默认值 |
|---|---|---|---|---|
| 回答 | LITELLM_CHAT_API_BASE | LITELLM_CHAT_API_KEY | LITELLM_CHAT_LANGUAGE_MODEL | LITELLM_CHAT_TOKENS=8192 |
| 抽取 | LITELLM_EXTRACT_API_BASE | LITELLM_EXTRACT_API_KEY | LITELLM_EXTRACT_LANGUAGE_MODEL | LITELLM_EXTRACT_TOKENS=256 |
| Text2Gremlin | LITELLM_TEXT2GQL_API_BASE | LITELLM_TEXT2GQL_API_KEY | LITELLM_TEXT2GQL_LANGUAGE_MODEL | LITELLM_TEXT2GQL_TOKENS=4096 |
| 嵌入 | LITELLM_EMBEDDING_API_BASE | LITELLM_EMBEDDING_API_KEY | LITELLM_EMBEDDING_MODEL | 不适用 |
三个语言模型默认是 openai/gpt-4.1-mini,嵌入模型默认是 openai/text-embedding-3-small。模型名通常使用 供应商/模型 格式,具体取值由 LiteLLM 服务决定。
Ollama
| 用途 | 主机 | 端口 | 模型 |
|---|---|---|---|
| 回答 | OLLAMA_CHAT_HOST | OLLAMA_CHAT_PORT | OLLAMA_CHAT_LANGUAGE_MODEL |
| 抽取 | OLLAMA_EXTRACT_HOST | OLLAMA_EXTRACT_PORT | OLLAMA_EXTRACT_LANGUAGE_MODEL |
| Text2Gremlin | OLLAMA_TEXT2GQL_HOST | OLLAMA_TEXT2GQL_PORT | OLLAMA_TEXT2GQL_LANGUAGE_MODEL |
| 嵌入 | OLLAMA_EMBEDDING_HOST | OLLAMA_EMBEDDING_PORT | OLLAMA_EMBEDDING_MODEL |
主机默认是 127.0.0.1,端口默认是 11434,模型名没有默认值。使用前先在 Ollama 中拉取对应模型。
重排序
| 配置项 | 默认值 | 说明 |
|---|---|---|
COHERE_BASE_URL | https://api.cohere.com/v1/rerank | Cohere rerank 接口;CO_API_URL 可作为回退值 |
RERANKER_API_KEY | 空 | Cohere 或 SiliconFlow 密钥 |
RERANKER_MODEL | 空 | 服务端支持的模型名 |
HugeGraph 连接与召回限制
| 配置项 | 默认值 | 说明 |
|---|---|---|
GRAPH_URL | 127.0.0.1:8080 | HugeGraph 地址,不拆分为 IP 和端口 |
GRAPH_NAME | hugegraph | 图名 |
GRAPH_USER | admin | 用户名 |
GRAPH_PWD | xxx | 密码 |
GRAPH_SPACE | 空 | GraphSpace 名称 |
LIMIT_PROPERTY | False | 是否限制返回属性;配置类按字符串读取 |
MAX_GRAPH_PATH | 10 | 最大图路径长度 |
MAX_GRAPH_ITEMS | 30 | 图召回的最大项目数 |
EDGE_LIMIT_PRE_LABEL | 8 | 每个边标签的返回上限 |
VECTOR_DIS_THRESHOLD | 0.9 | 向量距离阈值;超过阈值的结果会被忽略 |
TOPK_PER_KEYWORD | 1 | 每个关键词的候选数 |
TOPK_RETURN_RESULTS | 20 | 重排序后返回的结果数 |
外部向量数据库
默认实现可以使用本地 FAISS。启用可选依赖后还可配置:
| 配置项 | 默认值 |
|---|---|
QDRANT_HOST | 空 |
QDRANT_PORT | 6333 |
QDRANT_API_KEY | 空 |
MILVUS_HOST | 空 |
MILVUS_PORT | 19530 |
MILVUS_USER | 空 |
MILVUS_PASSWORD | 空 |
安装对应依赖:
登录与日志接口
| 配置项 | 默认值 | 说明 |
|---|---|---|
ENABLE_LOGIN | False | 是否要求 Bearer token;配置类按字符串读取 |
USER_TOKEN | 4321 | Web 页面和普通 API 的 token |
ADMIN_TOKEN | xxxx | /logs 使用的管理员 token |
ADMIN_TOKEN 为空或仍为 xxxx 时,/logs 会直接返回 403。生产环境应同时替换用户 token 和管理员 token。
最小 OpenAI 配置
配置加载
配置类先提供代码默认值,再从 .env 和进程环境读取覆盖值。Web 页面和配置 API 可以在运行时更新当前设置,并把受支持的字段同步回 .env。手工改动 .env 后应重启服务;提示词 YAML 可由页面加载逻辑刷新。
配置定义位于:
hugegraph-llm/src/hugegraph_llm/config/llm_config.pyhugegraph-llm/src/hugegraph_llm/config/hugegraph_config.pyhugegraph-llm/src/hugegraph_llm/config/admin_config.pyhugegraph-llm/src/hugegraph_llm/config/prompt_config.py
5 - HugeGraph-LLM REST API
HugeGraph-LLM 演示进程同时提供 Web 页面和 REST API。默认地址是 http://localhost:8001:
认证
在 .env 中启用登录:
启用后,请求需要 Bearer token:
RAG
POST /rag
根据开关返回一种或多种回答。未显式指定时只启用 graph_only。
响应只包含已启用的回答字段:
其他可选参数包括 graph_ratio、rerank_method(bleu 或 reranker)、near_neighbor_first、custom_priority_info,以及三类自定义提示词。
POST /rag/graph
只执行图召回,不生成最终自然语言答案:
响应的 graph_recall 可能包含 keywords、match_vids、gremlin、graph_result 和 vertex_degree_list。设置 get_vertex_only=true 可在顶点匹配后提前返回。
图抽取
POST /graph/extract
使用内联 Schema 时不会连接 HugeGraph:
texts 可以是字符串或字符串数组。language 可选 zh、en,split_type 可选 document、paragraph、sentence。
若 schema 传现有图名,必须同时传入 client_config,且 client_config.graph 必须和图名相同:
成功响应固定包含 status、result.vertices、result.edges、warnings 和 meta。
Text2Gremlin
POST /text2gremlin
output_types 可包含:
match_resulttemplate_gremlinraw_gremlintemplate_execution_resultraw_execution_result
省略该字段时默认只返回 template_gremlin;传空数组表示由实现返回全部输出。自定义 gremlin_prompt 必须包含 {query}、{schema}、{example} 和 {vertices}。
运行时配置
POST /config/graph
POST /config/llm 与 POST /config/embedding
两个端点使用同一个请求模型。OpenAI 或 LiteLLM 示例:
Ollama 请求仍要提供公共字段;api_key 和 api_base 可传空字符串:
POST /config/rerank
reranker_type 可选 cohere、siliconflow。Cohere 还可以传 cohere_base_url。
这些配置端点会改动进程当前配置,并可能同步到 .env。/rag、/rag/graph 和 /text2gremlin 的 client_config 只在单次请求期间覆盖 HugeGraph 连接;当前实现仍会临时改动进程全局设置,不适合用不同连接并发发起长请求。
日志
POST /logs
该接口要求 .env 中的 ADMIN_TOKEN 已改成安全值。请求体示例:
log_file 只能是 logs/ 目录下的文件名,不能包含路径分隔符。