文档 1.7 版本已不再积极维护,你当前浏览的是一份归档快照。 最新文档请参阅 最新版本。
HugeGraph-LLM
HugeGraph-LLM 用于知识图谱构建、GraphRAG 和自然语言图查询。演示服务把 Gradio 页面和 FastAPI 接口挂在同一个进程上,默认监听 8001 端口。
环境要求
AI 总结项目文档:Ask DeepWiki
- Python 3.10 或 3.11
uv0.7 或更高版本- HugeGraph Server 1.5 或更高版本
Docker Compose 部署
在 HugeGraph-AI 仓库根目录准备环境文件:
启动后可访问:
- HugeGraph Server:
http://localhost:8080 - RAG 服务和 Web 页面:
http://localhost:8001
从源码启动
依赖应从仓库根目录按 workspace 安装:
自定义监听地址和端口:
服务以 hugegraph-llm/.env 保存模型、HugeGraph 和登录配置。提示词放在 hugegraph-llm/src/hugegraph_llm/resources/demo/config_prompt.yaml。缺少文件时,配置代码会按默认值创建。
主要功能
构建 RAG 索引
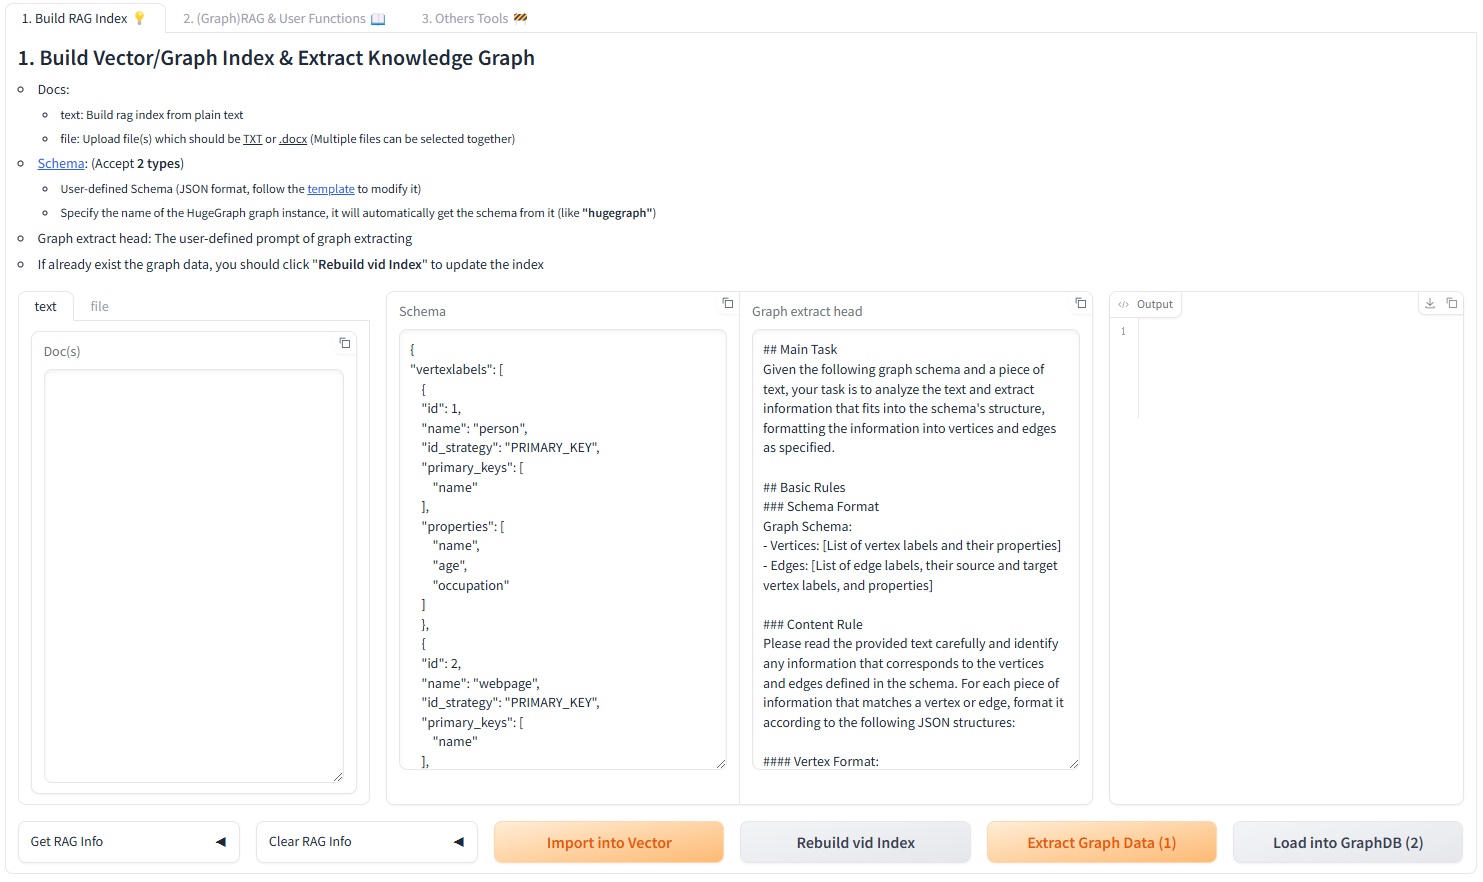
Web 页面的第一个标签页可以处理文本或文件,并执行以下操作:
- 切分文本并写入 chunk 向量索引。
- 按给定 Schema 从文本抽取顶点和边。
- 将抽取结果写入 HugeGraph,并更新顶点向量索引。
Schema 可以是内联 JSON,也可以是现有图名。通过 REST API 使用图名时,必须同时传入匹配的 client_config.graph;内联 JSON 不会连接 HugeGraph,也不能附带 client_config。
GraphRAG
查询流程可以组合直接回答、chunk 向量召回和图召回。图召回先抽取关键词并匹配顶点,再尝试 Text2Gremlin;生成或执行失败时可回退到预定义的图遍历方式。请求参数可控制返回数量、向量距离阈值、模板数量和重排序方式。
Text2Gremlin
POST /text2gremlin 根据自然语言、图 Schema 和可选示例生成 Gremlin。自定义提示词必须保留 {query}、{schema}、{example} 和 {vertices} 四个占位符。
模型与向量后端
聊天、信息抽取和 Text2Gremlin 可以分别使用 OpenAI 兼容接口、Ollama 或 LiteLLM。嵌入模型也可以独立选择。默认向量索引使用 FAISS;安装 vectordb 可选依赖后,还可配置 Milvus 或 Qdrant:
完整环境变量见配置参考,HTTP 请求格式见REST API。